API & SDKHướng dẫn
Request đầu tiên trong Java với openai-java: base URL, key, usage
Một chương trình Java 8+ chạy được: openai-java trỏ tới CheapTokens, một chat completion, và in ra câu trả lời, finish_reason và lượng token đã dùng.
Trên trang này
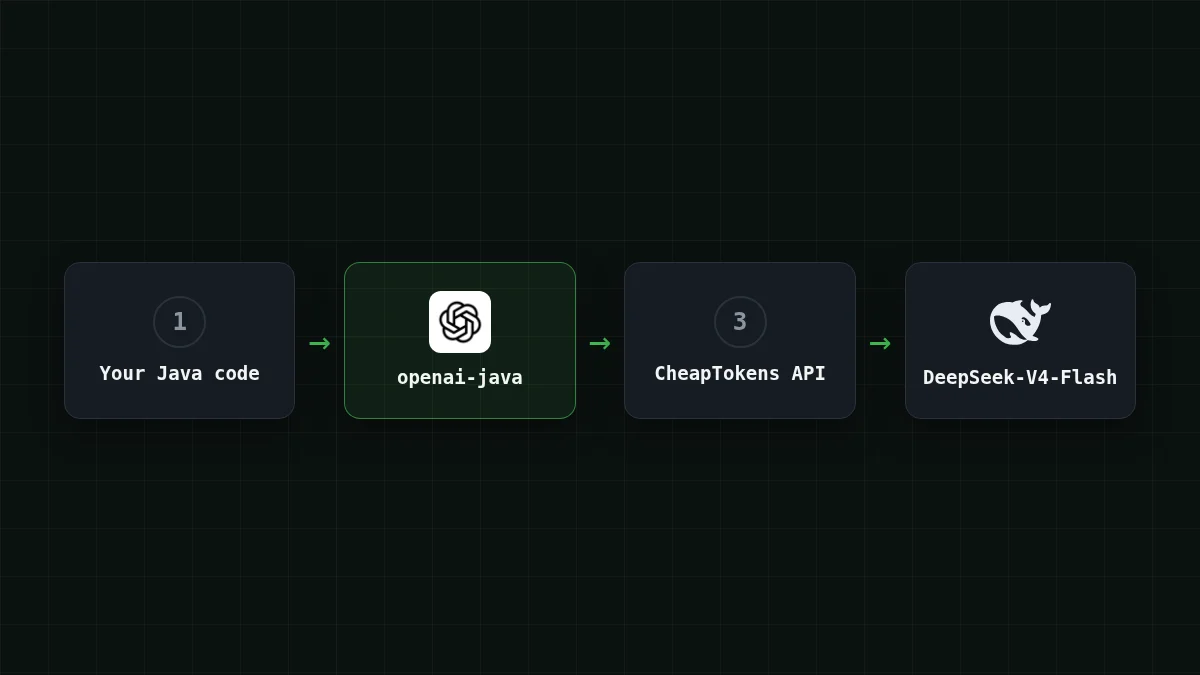
Để gọi CheapTokens từ Java, hãy giữ nguyên SDK chính thức openai-java và thay đổi ba thứ: base URL (https:/), API key, và model id, được truyền dưới dạng một String thuần. Chương trình dưới đây gửi một chat completion và in ra câu trả lời, finish_reason và lượng token đã dùng. Nó cần Java 8 trở lên.
Nếu nhóm của bạn đã có một dịch vụ Spring nói chuyện với OpenAI, thì đây là toàn bộ việc di chuyển: không client mới, không lớp request mới.
Thêm dependency#
README của SDK (github.com/openai/openai-java, kiểm tra ngày 4 tháng 11 năm 2026) ghi phiên bản 4.99.0, group com.openai, artifact openai-java. README không ghi ngày phát hành, nên hãy xem repository để biết phiên bản mới nhất trước khi bạn sao chép đoạn này.
Thêm openai-java vào build của bạn
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")Các artifact độc lập với framework chạy trên Java 8+, nên một JDK doanh nghiệp cũ không phải là trở ngại.
Đặt key và base URL bên ngoài mã nguồn#
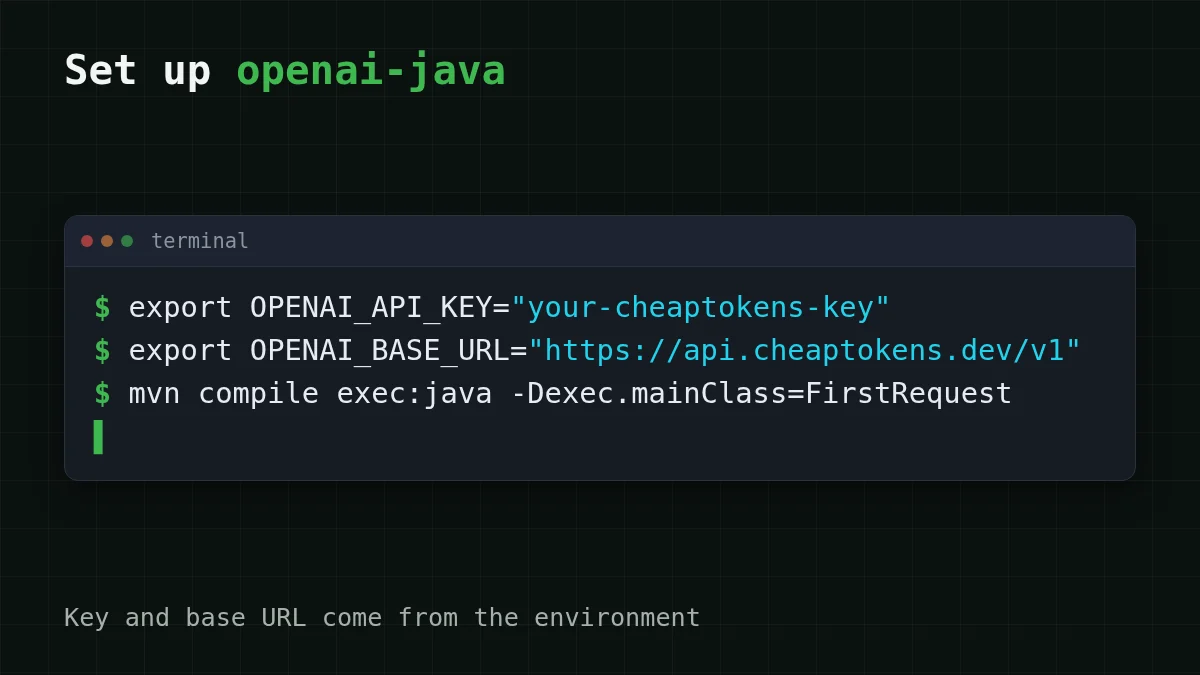
SDK đọc hai biến môi trường: OPENAI_API_KEY và OPENAI_BASE_URL. OpenAIOkHttpClient. nhận cả hai, nên key không bao giờ lọt vào file nguồn của bạn. (System property openai.apiKey và openai.baseUrl cũng hoạt động và được ưu tiên hơn các biến môi trường.)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
Base URL mặc định của SDK là https:/. Bỏ qua dòng thứ hai và request của bạn sẽ đi tới đó, với một key CheapTokens mà nó không biết. Đó là một cách để nhận 401 ngay lần chạy đầu tiên. Về nơi lưu key và cách giữ nó khỏi git, xem lưu trữ API key an toàn.
Chương trình#
Tạo FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
Vài dòng đáng để xem lại.
.. Các ví dụ trong README của SDK dùng hằng số có kiểu nhưmodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel., nhưng builder cũng có một overloadGPT_ 5_ 2 model(String), nên id nào cũng được. Dùng id đầy đủ từ tài liệu CheapTokens: tên ngắndeepseek-là cách giá được ghi nhãn trên trang web; API cần id đầy đủ với tiền tốv4- flash- 0731 deepseek-ai/. Không chắc về một id? Liệt kê model với GET /v1/models... Một giới hạn trên cho độ dài câu trả lời, dưới dạngmaxCompletionTokens(300L) long. DeepSeek-V4-Flash cho phép tối đa 32.768 token đầu ra mỗi câu trả lời, nên 300 ở đây là một lựa chọn để giữ bản demo ngắn gọn, không phải giới hạn của model.content()là mộtOptional. Đó là lý do chương trình cóorElse. Một câu trả lời chỉ gồm các tool call thì không có văn bản.usage()cũng là mộtOptional.ifPresentin nó ra khi server gửi nó.
Biên dịch và chạy theo cách build của bạn (mvn compile exec:java -, hoặc một task JavaExec trong Gradle). Bạn sẽ nhận được lời giải thích về một token, rồi một dòng finish_reason: … có chứa stop, rồi một dòng với số lượng token đầu vào và đầu ra. Nếu finish_reason ghi length, câu trả lời đã chạm mức giới hạn 300 token của bạn và bị cắt: hãy tăng con số đó (tại sao điều đó xảy ra).
usage() trả về số lượng token prompt, completion và tổng (promptTokens(), completionTokens(), totalTokens()).
Đặt giá trị tường minh bằng builder#
Các bài test, hoặc một dịch vụ có nhiều client, đôi khi cần giá trị tường minh. Cùng client đó, được dựng thủ công:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
Mọi thứ sau dòng này, các params và lời gọi create, giữ nguyên như trên. Ngay cả ở đây cũng hãy đọc key từ môi trường; một string literal trong file .java sẽ kết thúc trong repository của bạn.
Ba lỗi bạn sẽ gặp đầu tiên#
Ghép cặp
Khớp triệu chứng với nguyên nhân
Nhấn vào một mục bên trái, rồi đến cặp của nó
- 401 Unauthorizedkey trống hoặc sai, hoặc request đã đi tới api.openai.com vì
OPENAI_BASE_URLchưa được đặt - 404 Not Foundbase URL thiếu
/v1, hoặc model id không tồn tại - finish_reason ghi length
maxCompletionTokensthấp hơn mức câu trả lời cần
Một biến môi trường trống rất dễ bị bỏ sót trong IDE: một cấu hình chạy được khởi động từ thanh công cụ có thể không kế thừa các biến bạn đã export trong terminal. Nếu key "đã được đặt" mà bạn vẫn nhận 401, hãy thêm các biến vào cấu hình chạy. Thêm về các mã này: API 401 hoặc 404: key, base URL, model id.
Một request tốn bao nhiêu#
Vì bạn in usage, bạn có thể định giá request trước khi mở rộng quy mô. Giả sử dịch vụ của bạn gửi khoảng 200 token đầu vào và nhận lại 300. Với giá hiện tại, request đó tốn $0.000033 trên DeepSeek-V4-Flash. Đầu vào và đầu ra được tính chung, và tổng cộng rẻ hơn OpenRouter. Bảng lặp lại điều đó cho 1.000 request trên các model của chúng tôi:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 1.000 yêu cầu | OpenRouter, 1.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 token đầu vào và 300 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Giờ hãy thay vào lưu lượng của chính bạn. Kéo các thanh trượt tới các con số từ dòng usage đầu tiên bạn in ra:
Máy tính chi phí
Một dịch vụ hỗ trợ với 2.000 request mỗi ngày
Token đầu vào mỗi yêu cầu: 200 · Token đầu ra mỗi yêu cầu: 300 · Số yêu cầu mỗi ngày: 2.000
| Mô hình | Mỗi ngày | Mỗi tháng |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
Để có nhiều chỗ hơn cho mỗi câu trả lời hoặc một dạng khối lượng công việc khác, DeepSeek-V4-Flash cho bạn cửa sổ ngữ cảnh 380K và một mức giá vào bất kỳ giờ nào trong ngày; GLM-5.3-Flash (zai-) là một lựa chọn thay thế trực tiếp trong cùng chương trình: chỉ đổi id, không gì khác. Giá hiện tại cho tất cả các model nằm trên trang giá, và tài liệu hiển thị cùng request đó bằng các ngôn ngữ khác. Làm điều này trong Go? Xem phiên bản openai-go.


