API i SDKPrzewodnik
Pierwsze żądanie w Javie z openai-java: bazowy URL, klucz, zużycie
Uruchamialny program w Javie 8+: openai-java wskazany na CheapTokens, jedno uzupełnienie czatu oraz wypisana odpowiedź, finish_reason i zużycie tokenów.
Na tej stronie
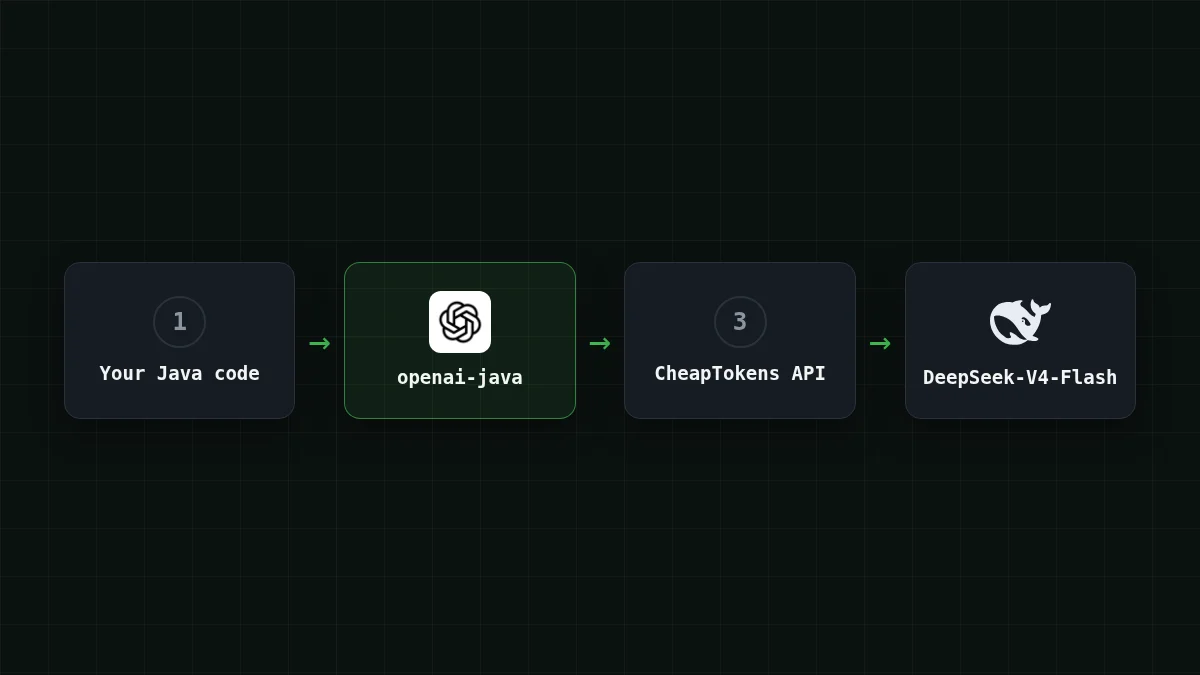
Aby wywołać CheapTokens z Javy, zachowaj oficjalne SDK openai-java i zmień trzy rzeczy: bazowy URL (https:/), klucz API oraz identyfikator modelu, przekazywany jako zwykły String. Poniższy program wysyła jedno uzupełnienie czatu i wypisuje odpowiedź, finish_reason oraz zużycie tokenów. Wymaga Javy 8 lub nowszej.
Jeśli Twój zespół ma już usługę Spring, która rozmawia z OpenAI, to cała migracja: żadnego nowego klienta, żadnych nowych klas żądań.
Dodaj zależność#
README SDK (github.com/openai/openai-java, sprawdzone 4 listopada 2026) pokazuje wersję 4.99.0, grupę com.openai, artefakt openai-java. README nie podaje daty wydania, więc zanim to skopiujesz, sprawdź najnowszą wersję w repozytorium.
Dodaj openai-java do swojego builda
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")Artefakty niezależne od frameworka działają na Javie 8+, więc starszy firmowy JDK nie jest przeszkodą.
Ustaw klucz i bazowy URL poza kodem#
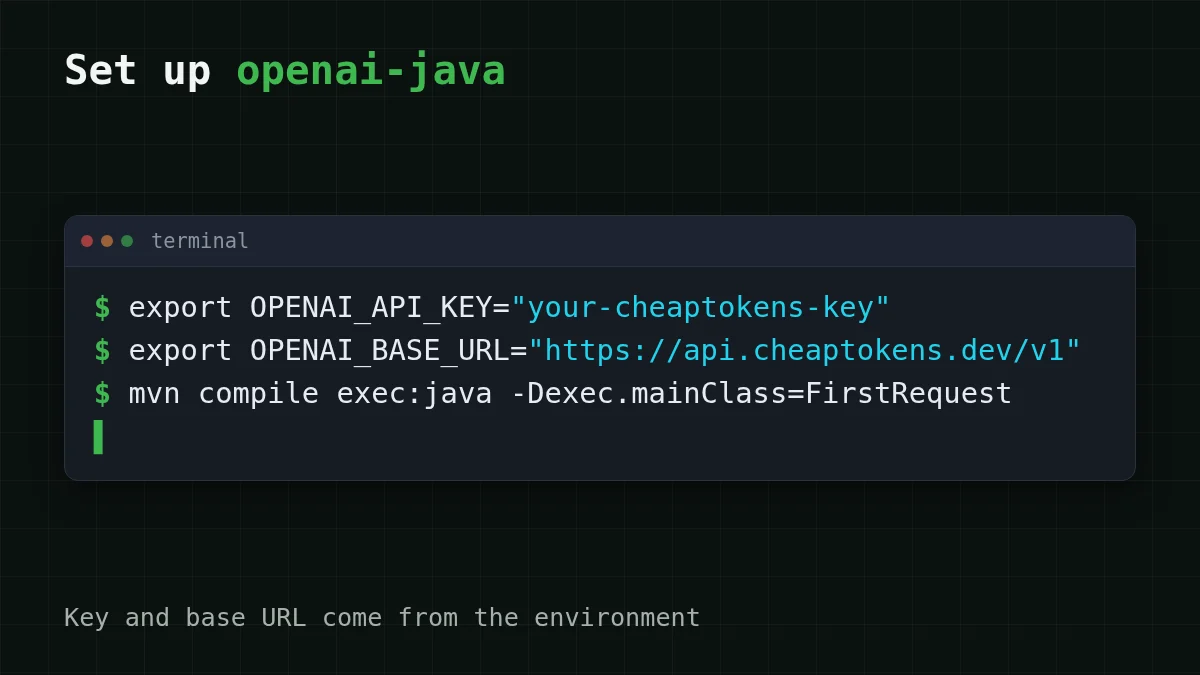
SDK odczytuje dwie zmienne środowiskowe: OPENAI_API_KEY i OPENAI_BASE_URL. OpenAIOkHttpClient. podchwytuje obie, więc klucz nigdy nie trafia do plików źródłowych. (Właściwości systemowe openai.apiKey i openai.baseUrl też działają i mają pierwszeństwo przed zmiennymi.)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
Domyślny bazowy URL SDK to https:/. Pomiń drugą linię, a Twoje żądanie tam trafi, z kluczem CheapTokens, którego nie zna. To jeden ze sposobów na 401 przy pierwszym uruchomieniu. Gdzie trzymać klucz i jak nie wrzucić go do gita, zobacz bezpieczne przechowywanie klucza API.
Program#
Utwórz FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
Kilka linii zasługuje na drugie spojrzenie.
.. Przykłady w README SDK używają typowanych stałych, takich jakmodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel., ale builder ma też przeciążenieGPT_ 5_ 2 model(String), więc każdy identyfikator zadziała. Użyj pełnego identyfikatora z dokumentacji CheapTokens: krótka nazwadeepseek-to sposób oznaczania cen w serwisie; API wymaga pełnego identyfikatora z prefiksemv4- flash- 0731 deepseek-ai/. Nie masz pewności co do identyfikatora? Wylistuj modele przez GET /v1/models... Górny limit długości odpowiedzi, jakomaxCompletionTokens(300L) long. DeepSeek-V4-Flash pozwala na maksymalnie 32 768 tokenów wyjściowych na odpowiedź, więc 300 tutaj to wybór, by demo było krótkie, a nie limit modelu.content()toOptional. Dlatego program maorElse. Odpowiedź złożona wyłącznie z wywołań narzędzi nie ma tekstu.usage()też jestOptional.ifPresentwypisuje go, gdy serwer go wyśle.
Skompiluj i uruchom tak, jak robi to Twój build (mvn compile exec:java - lub zadanie JavaExec w Gradle). Powinieneś otrzymać wyjaśnienie tokena, potem linię finish_reason: … z stop w środku, a następnie linię z liczbą tokenów wejściowych i wyjściowych. Jeśli finish_reason mówi length, odpowiedź trafiła w Twój limit 300 tokenów i została ucięta: zwiększ liczbę (dlaczego tak się dzieje).
usage() zwraca liczbę tokenów promptu, uzupełnienia i łączną (promptTokens(), completionTokens(), totalTokens()).
Ustaw wartości jawnie przez builder#
Testy lub usługa z kilkoma klientami czasem potrzebują jawnych wartości. Ten sam klient, zbudowany ręcznie:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
Wszystko po tej linii, parametry i wywołanie create, pozostaje dokładnie jak wyżej. Nawet tutaj czytaj klucz ze środowiska; literał tekstowy w pliku .java trafia do Twojego repozytorium.
Trzy błędy, które spotkasz najpierw#
Dopasuj pary
Dopasuj objaw do przyczyny
Dotknij element po lewej, a następnie jego parę
- 401 Unauthorizedklucz jest pusty lub błędny, albo żądanie poszło do api.openai.com, bo
OPENAI_BASE_URLnie jest ustawione - 404 Not Foundw bazowym URL brakuje
/v1albo identyfikator modelu nie istnieje - finish_reason mówi length
maxCompletionTokensjest niższe niż potrzebuje odpowiedź
Pustą zmienną środowiskową łatwo przeoczyć w IDE: konfiguracja uruchomienia startowana z paska narzędzi może nie dziedziczyć zmiennych wyeksportowanych w terminalu. Jeśli klucz „jest ustawiony”, ale nadal dostajesz 401, dodaj zmienne do konfiguracji uruchomienia. Więcej o tych kodach: API 401 lub 404: klucz, bazowy URL, identyfikator modelu.
Ile kosztuje jedno żądanie#
Ponieważ wypisujesz usage, możesz wycenić żądanie, zanim je przeskalujesz. Załóżmy, że Twoja usługa wysyła około 200 tokenów wejściowych i dostaje 300 z powrotem. Przy dzisiejszych cenach to żądanie kosztuje $0.000033 na DeepSeek-V4-Flash. Wejście i wyjście są rozliczane razem, a w sumie jest to taniej niż OpenRouter. Tabela powtarza to dla 1000 żądań w naszych modelach:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Teraz podstaw własny ruch. Przeciągnij suwaki do liczb z pierwszej wypisanej linii usage:
Kalkulator kosztów
Usługa wsparcia z 2000 żądań dziennie
Tokeny wejściowe na żądanie: 200 · Tokeny wyjściowe na żądanie: 300 · Żądania dziennie: 2000
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
Na więcej miejsca na odpowiedź lub inny kształt obciążenia DeepSeek-V4-Flash daje okno kontekstu 380K i jedną cenę o każdej porze dnia; GLM-5.3-Flash (zai-) to zamiennik bez zmian w tym samym programie: zmień identyfikator, nic więcej. Aktualne ceny wszystkich modeli są na stronie cennika, a dokumentacja pokazuje to samo żądanie w innych językach. Robisz to w Go? Zobacz wersję openai-go.


