API e SDKGuia
Primeira requisição em Java com openai-java: base URL, chave, uso
Um programa Java 8+ executável: openai-java apontado para o CheapTokens, uma chat completion e a resposta, finish_reason e uso de tokens impressos.
Nesta página
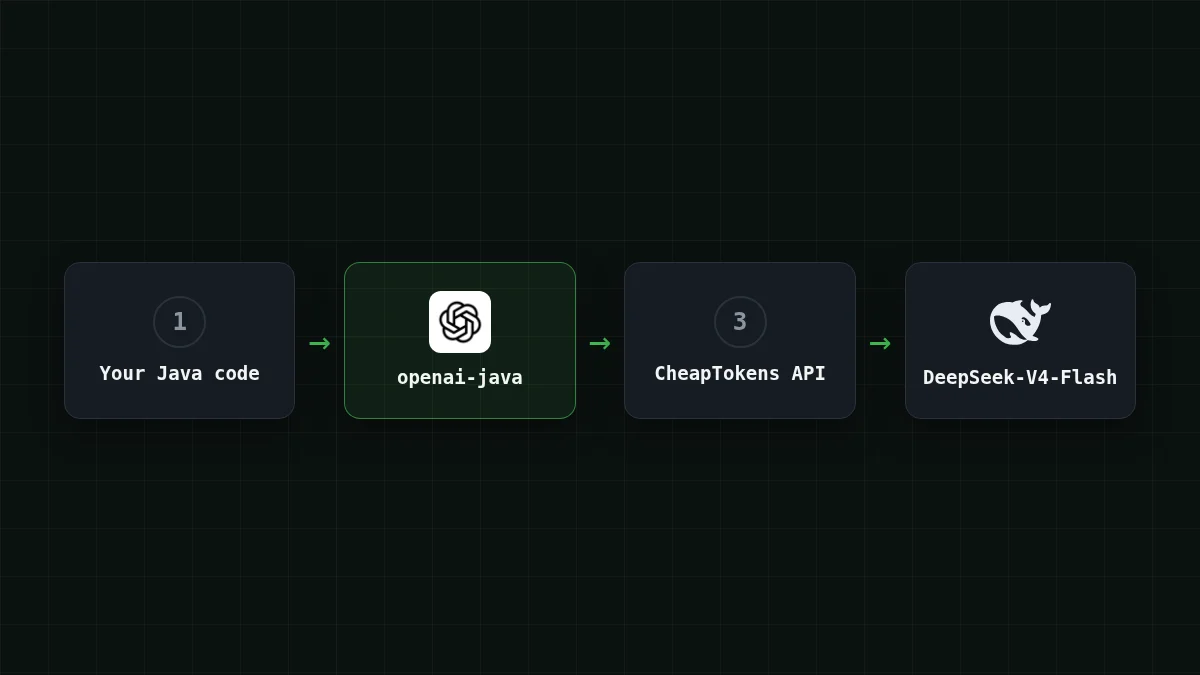
Para chamar o CheapTokens a partir do Java, mantenha o SDK oficial openai-java e altere três coisas: a base URL (https:/), a chave de API e o id do modelo, passado como uma String simples. O programa abaixo envia uma chat completion e imprime a resposta, o finish_reason e o uso de tokens. Ele requer Java 8 ou superior.
Se sua equipe já tem um serviço Spring que conversa com a OpenAI, esta é a migração inteira: nenhum cliente novo, nenhuma classe de requisição nova.
Adicione a dependência#
O README do SDK (github.com/openai/openai-java, verificado em 4 de novembro de 2026) mostra a versão 4.99.0, grupo com.openai, artefato openai-java. O README não informa uma data de lançamento, então consulte o repositório para a versão mais recente antes de copiar isto.
Adicione openai-java ao seu build
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")Os artefatos neutros em relação a frameworks rodam em Java 8+, então um JDK corporativo mais antigo não é um bloqueio.
Defina a chave e a base URL fora do código#
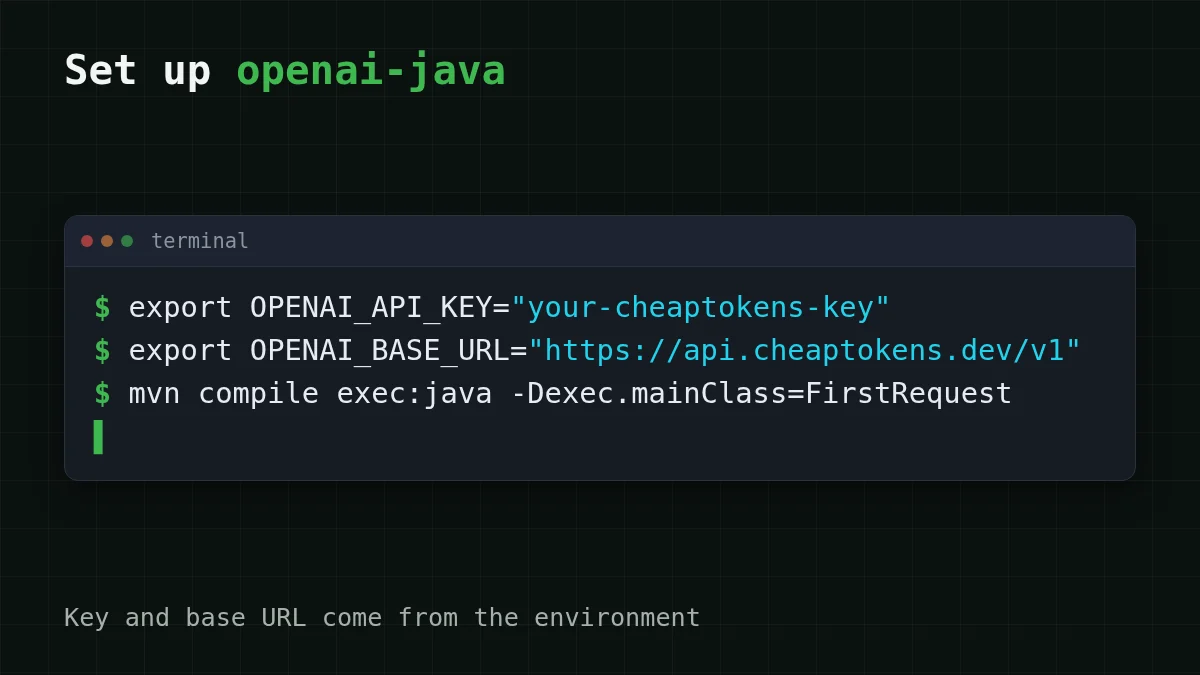
O SDK lê duas variáveis de ambiente: OPENAI_API_KEY e OPENAI_BASE_URL. OpenAIOkHttpClient. pega as duas, então a chave nunca vai parar nos seus arquivos-fonte. (As propriedades de sistema openai.apiKey e openai.baseUrl também funcionam e têm precedência sobre as variáveis.)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
A base URL padrão do SDK é https:/. Pule a segunda linha e sua requisição vai para lá, com uma chave do CheapTokens que ele não conhece. Essa é uma forma de receber um 401 na primeira execução. Para saber onde guardar a chave e como mantê-la fora do git, veja armazene uma chave de API com segurança.
O programa#
Crie FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
Algumas linhas merecem uma segunda olhada.
.. Os exemplos do README do SDK usam constantes tipadas comomodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel., mas o builder também tem uma sobrecargaGPT_ 5_ 2 model(String), então qualquer id funciona. Use o id completo da documentação do CheapTokens: o nome curtodeepseek-é como os preços são rotulados no site; a API quer o id completo com o prefixov4- flash- 0731 deepseek-ai/. Não tem certeza de um id? Liste os modelos com GET /v1/models... Um teto para o tamanho da resposta, como ummaxCompletionTokens(300L) long. O DeepSeek-V4-Flash permite até 32.768 tokens de saída por resposta, então 300 aqui é uma escolha para manter a demonstração curta, não um limite do modelo.content()é umOptional. É por isso que o programa temorElse. Uma resposta feita apenas de tool calls não tem texto.usage()também é umOptional.ifPresento imprime quando o servidor o envia.
Compile e execute como seu build faz (mvn compile exec:java -, ou uma tarefa JavaExec no Gradle). Você deve receber a explicação de um token, depois uma linha finish_reason: … com stop nela, depois uma linha com as contagens de tokens de entrada e saída. Se finish_reason disser length, a resposta atingiu seu teto de 300 tokens e foi cortada: aumente o número (por que isso acontece).
usage() retorna as contagens de tokens de prompt, completion e total (promptTokens(), completionTokens(), totalTokens()).
Defina os valores explicitamente com o builder#
Testes, ou um serviço com vários clientes, às vezes precisam de valores explícitos. O mesmo cliente, construído à mão:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
Tudo depois desta linha, os params e a chamada create, permanece exatamente como acima. Continue lendo a chave do ambiente mesmo aqui; um literal de string em um arquivo .java acaba no seu repositório.
Três erros que você vai encontrar primeiro#
Emparelhar os pares
Relacione o sintoma à causa
Toque num item à esquerda, depois no seu par
- 401 Unauthorizeda chave está vazia ou errada, ou a requisição foi para api.openai.com porque
OPENAI_BASE_URLnão está definida - 404 Not Founda base URL não tem
/v1, ou o id do modelo não existe - finish_reason diz length
maxCompletionTokensé menor do que a resposta precisa
Uma variável de ambiente vazia é fácil de passar despercebida em uma IDE: uma configuração de execução iniciada pela barra de ferramentas pode não herdar as variáveis que você exportou no terminal. Se a chave "está definida" mas você ainda recebe 401, adicione as variáveis à configuração de execução. Mais sobre esses códigos: API 401 ou 404: chave, base URL, id do modelo.
Quanto custa uma requisição#
Como você imprime usage, pode precificar a requisição antes de escalá-la. Digamos que seu serviço envie cerca de 200 tokens de entrada e receba 300 de volta. Com os preços de hoje, essa requisição custa $0.000033 no DeepSeek-V4-Flash. Entrada e saída são cobradas juntas, e no total isso é mais barato que o OpenRouter. A tabela repete isso para 1.000 requisições em nossos modelos:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 1.000 solicitações | OpenRouter, 1.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 tokens de entrada e 300 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Agora insira seu próprio tráfego. Arraste os sliders para os números da sua primeira linha usage impressa:
Calculadora de custos
Um serviço de suporte com 2.000 requisições por dia
Tokens de entrada por solicitação: 200 · Tokens de saída por solicitação: 300 · Solicitações por dia: 2.000
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
Para mais espaço por resposta ou um formato diferente de carga de trabalho, o DeepSeek-V4-Flash oferece uma janela de contexto de 380K e um preço único em qualquer hora do dia; o GLM-5.3-Flash (zai-) é um substituto direto no mesmo programa: mude o id, nada mais. Os preços atuais de todos os modelos estão na página de preços, e a documentação mostra a mesma requisição em outras linguagens. Fazendo isso em Go? Veja a versão openai-go.


