API y SDKGuía
Primera petición en Java con openai-java: URL base, clave, uso
Un programa Java 8+ ejecutable: openai-java apuntando a CheapTokens, una chat completion y la respuesta, finish_reason y uso de tokens impresos.
En esta página
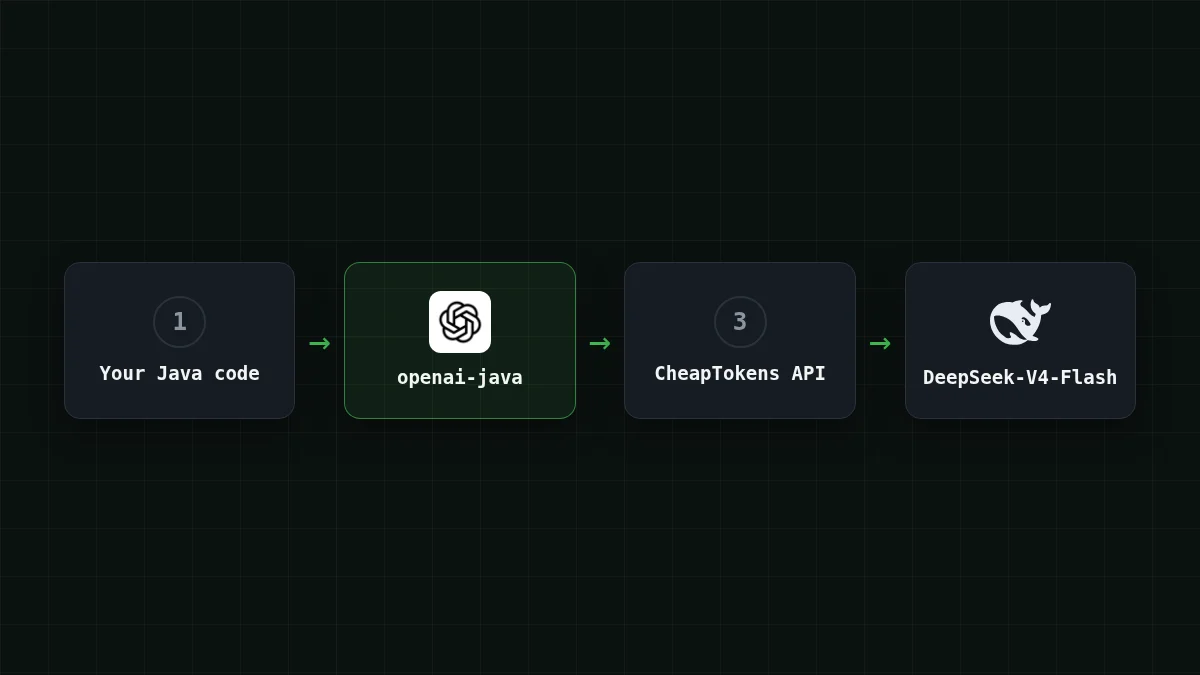
Para llamar a CheapTokens desde Java, conserva el SDK oficial openai-java y cambia tres cosas: la URL base (https:/), la clave de API y el id del modelo, pasado como un String simple. El programa siguiente envía una chat completion e imprime la respuesta, el finish_reason y el uso de tokens. Necesita Java 8 o posterior.
Si tu equipo ya tiene un servicio Spring que habla con OpenAI, esta es toda la migración: ningún cliente nuevo, ninguna clase de petición nueva.
Añade la dependencia#
El README del SDK (github.com/openai/openai-java, consultado el 4 de noviembre de 2026) muestra la versión 4.99.0, grupo com.openai, artefacto openai-java. El README no indica una fecha de publicación, así que revisa el repositorio para ver la última versión antes de copiar esto.
Añade openai-java a tu build
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")Los artefactos neutrales respecto al framework funcionan en Java 8+, así que un JDK corporativo antiguo no es un impedimento.
Configura la clave y la URL base fuera del código#
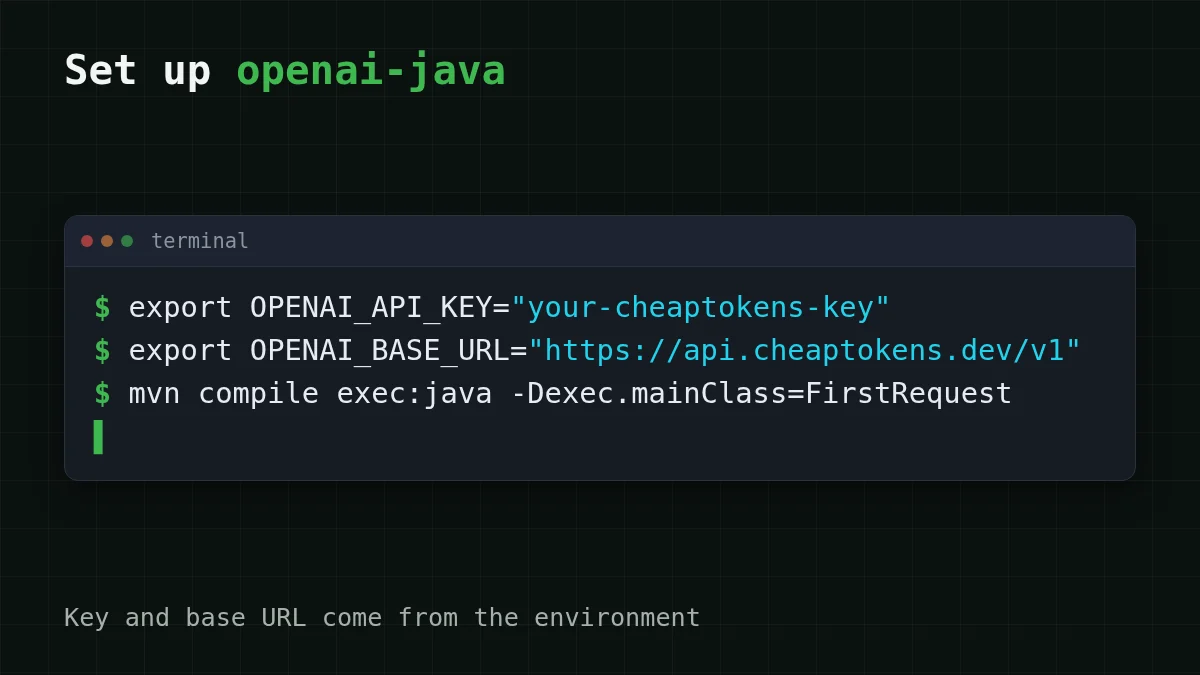
El SDK lee dos variables de entorno: OPENAI_API_KEY y OPENAI_BASE_URL. OpenAIOkHttpClient. recoge ambas, así que la clave nunca acaba en tus archivos fuente. (Las propiedades del sistema openai.apiKey y openai.baseUrl también funcionan y tienen prioridad sobre las variables).
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
La URL base por defecto del SDK es https:/. Omite la segunda línea y tu petición irá allí, con una clave de CheapTokens que no conoce. Esa es una forma de obtener un 401 en la primera ejecución. Para saber dónde guardar la clave y cómo mantenerla fuera de git, consulta guardar una clave de API de forma segura.
El programa#
Crea FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
Algunas líneas merecen una segunda mirada.
.. Los ejemplos del README del SDK usan constantes tipadas comomodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel., pero el builder también tiene una sobrecargaGPT_ 5_ 2 model(String), así que cualquier id sirve. Usa el id completo de la documentación de CheapTokens: el nombre cortodeepseek-es como se etiquetan los precios en el sitio; la API quiere el id completo con el prefijov4- flash- 0731 deepseek-ai/. ¿No estás seguro de un id? Lista los modelos con GET /v1/models... Un límite a la longitud de la respuesta, como unmaxCompletionTokens(300L) long. DeepSeek-V4-Flash permite hasta 32.768 tokens de salida por respuesta, así que 300 aquí es una elección para mantener la demo corta, no un límite del modelo.content()es unOptional. Por eso el programa tieneorElse. Una respuesta compuesta solo de tool calls no tiene texto.usage()también es unOptional.ifPresentlo imprime cuando el servidor lo envía.
Compílalo y ejecútalo como lo haga tu build (mvn compile exec:java -, o una tarea JavaExec en Gradle). Deberías obtener la explicación de un token, luego una línea finish_reason: … con stop en ella, y después una línea con los recuentos de tokens de entrada y salida. Si finish_reason dice length, la respuesta alcanzó tu tope de 300 tokens y se cortó: sube el número (por qué ocurre).
usage() devuelve los recuentos de tokens de prompt, completion y total (promptTokens(), completionTokens(), totalTokens()).
Configura los valores explícitamente con el builder#
Los tests, o un servicio con varios clientes, a veces necesitan valores explícitos. El mismo cliente, construido a mano:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
Todo lo que sigue a esta línea, los params y la llamada create, se queda exactamente como arriba. Sigue leyendo la clave del entorno incluso aquí; un literal de cadena en un archivo .java acaba en tu repositorio.
Tres errores que encontrarás primero#
Emparejar los pares
Relaciona el síntoma con la causa
Toca un elemento de la izquierda, luego su par
- 401 Unauthorizedla clave está vacía o es incorrecta, o la petición fue a api.openai.com porque
OPENAI_BASE_URLno está configurada - 404 Not Founda la URL base le falta
/v1, o el id del modelo no existe - finish_reason dice length
maxCompletionTokenses menor de lo que necesita la respuesta
Una variable de entorno vacía es fácil de pasar por alto en un IDE: una configuración de ejecución iniciada desde la barra de herramientas puede no heredar las variables que exportaste en la terminal. Si la clave "está configurada" pero sigues recibiendo 401, añade las variables a la configuración de ejecución. Más sobre estos códigos: API 401 o 404: clave, URL base, id del modelo.
Cuánto cuesta una petición#
Como imprimes usage, puedes calcular el precio de la petición antes de escalarla. Digamos que tu servicio envía unos 200 tokens de entrada y recibe 300. A los precios de hoy, esa petición cuesta $0.000033 en DeepSeek-V4-Flash. La entrada y la salida se facturan juntas, y en total eso es más barato que OpenRouter. La tabla lo repite para 1.000 peticiones en nuestros modelos:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Ahora introduce tu propio tráfico. Mueve los deslizadores a los números de tu primera línea usage impresa:
Calculadora de costos
Un servicio de soporte con 2.000 peticiones al día
Tokens de entrada por solicitud: 200 · Tokens de salida por solicitud: 300 · Solicitudes por día: 2000
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
Para más espacio por respuesta o una forma de carga de trabajo distinta, DeepSeek-V4-Flash te da una ventana de contexto de 380K y un único precio a cualquier hora del día; GLM-5.3-Flash (zai-) es un reemplazo directo en el mismo programa: cambia el id, nada más. Los precios actuales de todos los modelos están en la página de precios, y la documentación muestra la misma petición en otros lenguajes. ¿Lo haces en Go? Consulta la versión de openai-go.


