API & SDKPanduan
Request pertama di Java dengan openai-java: base URL, key, usage
Program Java 8+ yang dapat dijalankan: openai-java diarahkan ke CheapTokens, satu chat completion, dan jawaban, finish_reason serta penggunaan token dicetak.
Di halaman ini
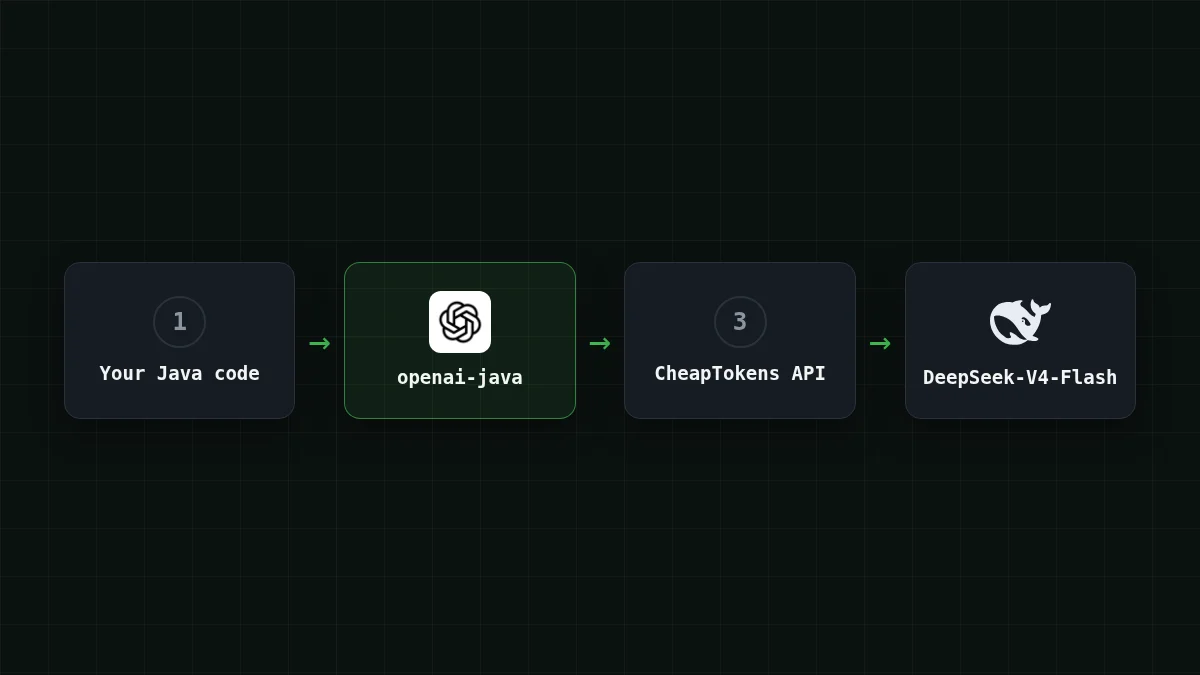
Untuk memanggil CheapTokens dari Java, tetap gunakan SDK resmi openai-java dan ubah tiga hal: base URL (https:/), API key, dan id model, yang diteruskan sebagai String biasa. Program di bawah mengirim satu chat completion dan mencetak jawaban, finish_reason, dan penggunaan token. Program ini membutuhkan Java 8 atau lebih baru.
Jika tim Anda sudah memiliki layanan Spring yang berkomunikasi dengan OpenAI, inilah keseluruhan migrasinya: tidak ada klien baru, tidak ada kelas request baru.
Tambahkan dependensi#
README SDK (github.com/openai/openai-java, diperiksa 4 November 2026) menunjukkan versi 4.99.0, group com.openai, artifact openai-java. README tidak mencantumkan tanggal rilis, jadi periksa repositori untuk versi terbaru sebelum Anda menyalin ini.
Tambahkan openai-java ke build Anda
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")Artifact yang netral terhadap framework berjalan di Java 8+, jadi JDK korporat yang lebih lama bukan penghalang.
Atur key dan base URL di luar kode#
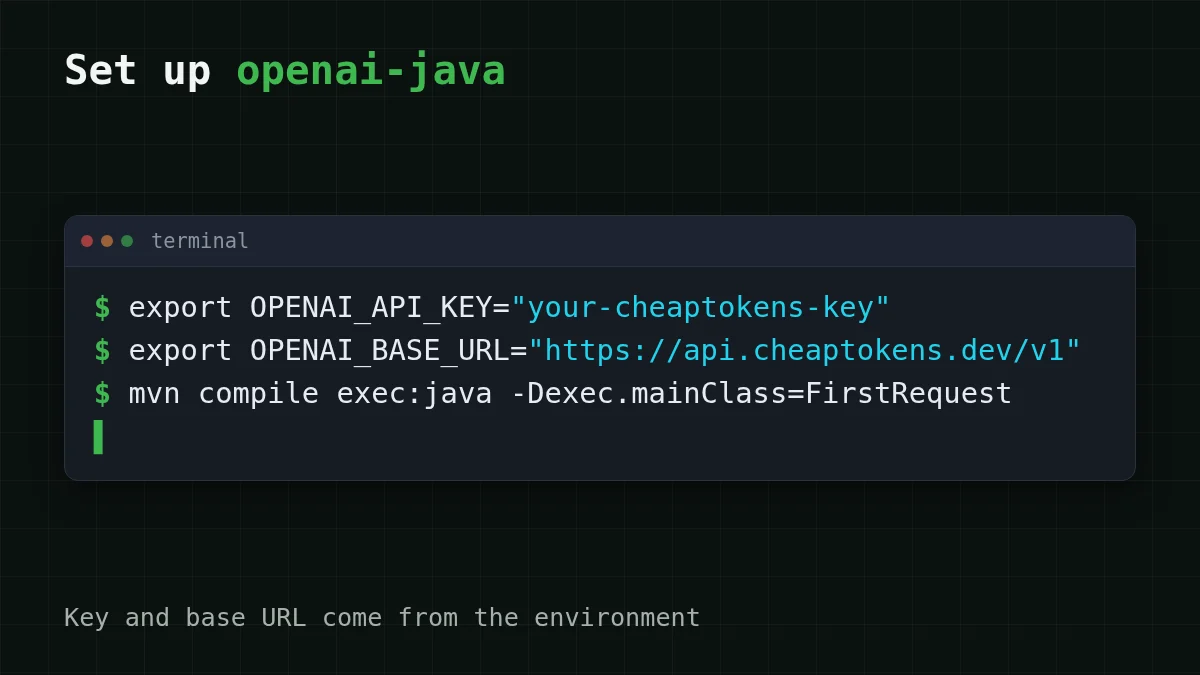
SDK membaca dua variabel lingkungan: OPENAI_API_KEY dan OPENAI_BASE_URL. OpenAIOkHttpClient. mengambil keduanya, sehingga key tidak pernah masuk ke file sumber Anda. (Properti sistem openai.apiKey dan openai.baseUrl juga berfungsi dan diprioritaskan di atas variabel tersebut.)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
Base URL default SDK adalah https:/. Lewati baris kedua dan request Anda akan dikirim ke sana, dengan key CheapTokens yang tidak dikenalnya. Itu salah satu cara mendapatkan 401 pada percobaan pertama. Untuk tempat menyimpan key dan cara menjaganya agar tidak masuk ke git, lihat menyimpan API key dengan aman.
Programnya#
Buat FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
Beberapa baris perlu diperhatikan lebih teliti.
.. Contoh di README SDK menggunakan konstanta bertipe sepertimodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel., tetapi builder juga memiliki overloadGPT_ 5_ 2 model(String), jadi id apa pun bisa dipakai. Gunakan id lengkap dari dokumentasi CheapTokens: nama pendekdeepseek-adalah cara harga dilabeli di situs; API membutuhkan id lengkap dengan prefiksv4- flash- 0731 deepseek-ai/. Tidak yakin dengan sebuah id? Daftar model dengan GET /v1/models... Batas atas panjang jawaban, sebagaimaxCompletionTokens(300L) long. DeepSeek-V4-Flash mengizinkan hingga 32.768 token output per jawaban, jadi 300 di sini adalah pilihan untuk menjaga demo tetap singkat, bukan batas dari model.content()adalahOptional. Itulah sebabnya program memilikiorElse. Balasan yang hanya berisi tool call tidak memiliki teks.usage()jugaOptional.ifPresentmencetaknya saat server mengirimkannya.
Kompilasi dan jalankan dengan cara build Anda (mvn compile exec:java -, atau task JavaExec di Gradle). Anda seharusnya mendapatkan penjelasan tentang token, lalu baris finish_reason: … dengan stop di dalamnya, lalu baris dengan jumlah token input dan output. Jika finish_reason menyebutkan length, jawaban mencapai batas 300 token Anda dan terpotong: naikkan angkanya (mengapa itu terjadi).
usage() mengembalikan jumlah token prompt, completion, dan total (promptTokens(), completionTokens(), totalTokens()).
Atur nilai secara eksplisit dengan builder#
Test, atau layanan dengan beberapa klien, terkadang membutuhkan nilai eksplisit. Klien yang sama, dibangun secara manual:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
Semua setelah baris ini, params dan pemanggilan create, tetap persis seperti di atas. Tetap baca key dari lingkungan bahkan di sini; literal string di file .java akan berakhir di repositori Anda.
Tiga error yang pertama kali Anda temui#
Cocokkan pasangan
Cocokkan gejala dengan penyebabnya
Ketuk item di kiri, lalu pasangannya
- 401 Unauthorizedkey kosong atau salah, atau request dikirim ke api.openai.com karena
OPENAI_BASE_URLtidak diatur - 404 Not Foundbase URL tidak memiliki
/v1, atau id model tidak ada - finish_reason menyebutkan length
maxCompletionTokenslebih rendah dari yang dibutuhkan jawaban
Variabel lingkungan yang kosong mudah terlewat di IDE: konfigurasi run yang dimulai dari toolbar mungkin tidak mewarisi variabel yang Anda ekspor di terminal. Jika key "sudah diatur" tetapi Anda masih mendapat 401, tambahkan variabel ke konfigurasi run. Lebih lanjut tentang kode ini: API 401 atau 404: key, base URL, id model.
Berapa biaya satu request#
Karena Anda mencetak usage, Anda dapat menghitung biaya request sebelum menskalakannya. Katakanlah layanan Anda mengirim sekitar 200 token input dan menerima 300 kembali. Dengan harga saat ini, request tersebut berbiaya $0.000033 pada DeepSeek-V4-Flash. Input dan output ditagih bersama, dan secara total itu lebih murah daripada OpenRouter. Tabel mengulanginya untuk 1.000 request di seluruh model kami:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 1.000 permintaan | OpenRouter, 1.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 token input dan 300 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Sekarang masukkan trafik Anda sendiri. Geser slider ke angka dari baris usage pertama yang Anda cetak:
Kalkulator biaya
Layanan dukungan dengan 2.000 request per hari
Token input per permintaan: 200 · Token output per permintaan: 300 · Permintaan per hari: 2.000
| Model | Per hari | Per bulan |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
Untuk ruang lebih per jawaban atau bentuk beban kerja yang berbeda, DeepSeek-V4-Flash memberi Anda jendela konteks 380K dan satu harga pada jam berapa pun; GLM-5.3-Flash (zai-) adalah pengganti langsung dalam program yang sama: ubah id-nya, tidak ada yang lain. Harga terkini untuk semua model ada di halaman harga, dan dokumentasi menunjukkan request yang sama dalam bahasa lain. Melakukan ini di Go? Lihat versi openai-go.


