用 openai-java 在 Java 中发出第一个请求:base URL、key、用量
一个可运行的 Java 8+ 程序:将 openai-java 指向 CheapTokens,一次 chat completion,并打印回答、finish_reason 和 token 用量。
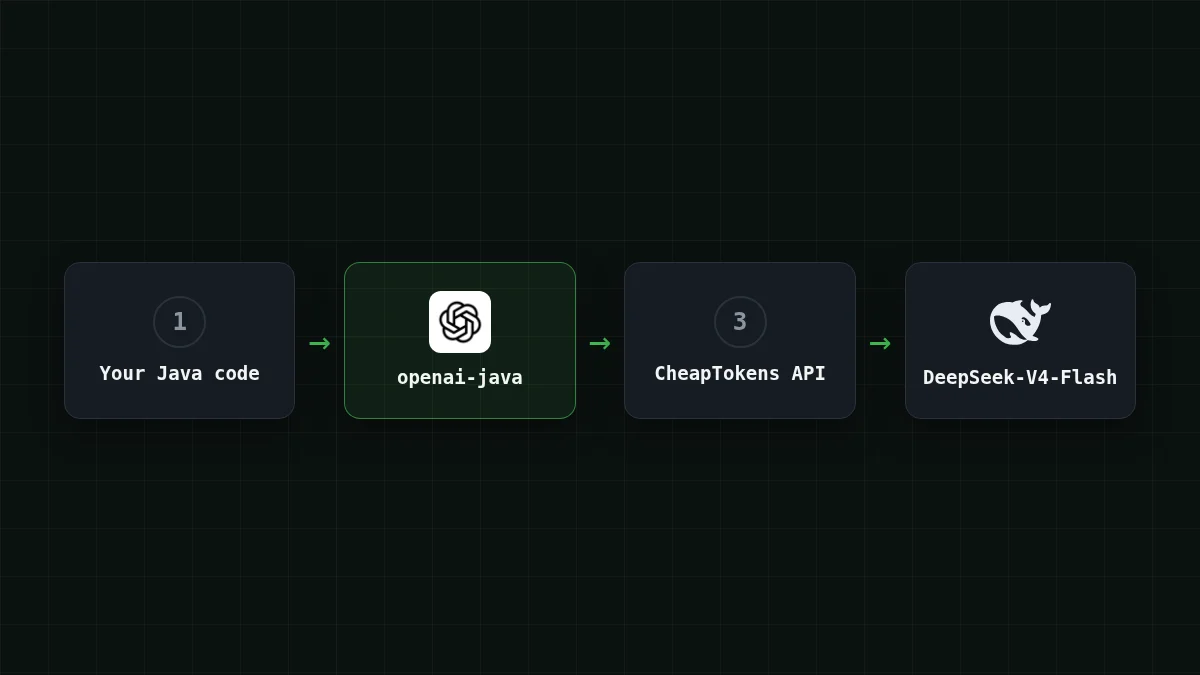
要从 Java 调用 CheapTokens,保留官方 openai-java SDK,只需改三处:base URL(https:/)、API key,以及以普通 String 传入的 model id。下面的程序发送一次 chat completion,并打印回答、finish_reason 和 token 用量。它需要 Java 8 或更高版本。
如果你的团队已有对接 OpenAI 的 Spring 服务,这就是全部迁移工作:不需要新客户端,也不需要新的请求类。
添加依赖#
SDK 的 README(github.com/openai/openai-java,查阅于 2026 年 11 月 4 日)显示版本 4.99.0,group 为 com.openai,artifact 为 openai-java。README 没有印出发布日期,所以复制之前请先到仓库查看最新版本。
将 openai-java 添加到你的构建
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")与框架无关的 artifact 可在 Java 8+ 上运行,所以较旧的企业 JDK 不是障碍。
在代码之外设置 key 和 base URL#
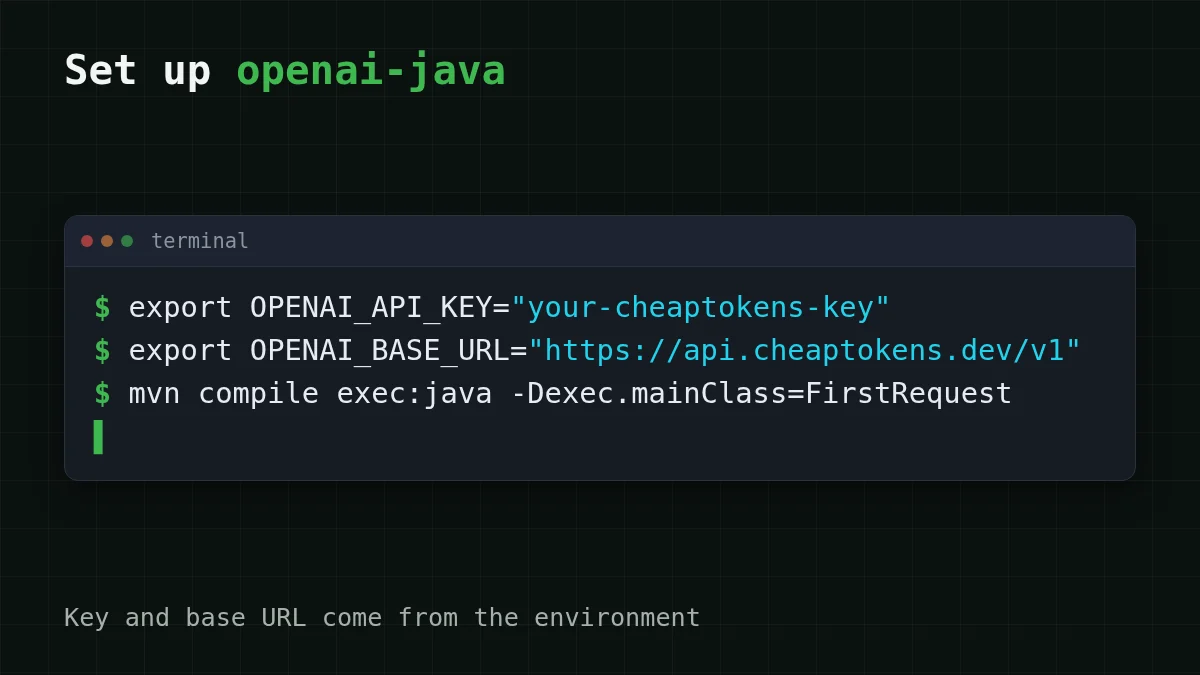
SDK 读取两个环境变量:OPENAI_API_KEY 和 OPENAI_BASE_URL。OpenAIOkHttpClient. 会同时读取两者,因此 key 永远不会进入你的源文件。(系统属性 openai.apiKey 和 openai.baseUrl 也可用,且优先级高于环境变量。)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
SDK 的默认 base URL 是 https:/。跳过第二行,请求就会发到那里,并带上一个它不认识的 CheapTokens key。这是首次运行就得到 401 的一种方式。关于 key 应保存在哪里以及如何避免它进入 git,请参阅安全存储 API key。
程序#
创建 FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
有几行值得再看一眼。
.。 SDK 的 README 示例使用model("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel.之类的类型化常量,但 builder 也有GPT_ 5_ 2 model(String)重载,所以任何 id 都可用。请使用 CheapTokens 文档中的完整 id:短名称deepseek-是网站上标注价格的方式;API 需要带v4- flash- 0731 deepseek-ai/前缀的完整 id。不确定 id?用 GET /v1/models 列出模型。.。 回答长度的上限,类型为maxCompletionTokens(300L) long。DeepSeek-V4-Flash 每次回答最多允许 32,768 个输出 token,所以这里的 300 是为了让演示保持简短的选择,而不是模型的限制。content()是Optional。 这就是程序中有orElse的原因。仅由工具调用组成的回复没有文本。usage()也是Optional。 服务器发送时,ifPresent会打印它。
按你的构建方式编译并运行(mvn compile exec:java -,或 Gradle 中的 JavaExec 任务)。你应该会得到对 token 的解释,然后是一行包含 stop 的 finish_reason: …,再是一行输入和输出 token 计数。如果 finish_reason 显示 length,说明回答达到了 300 token 上限并被截断:请调高这个数字(为什么会这样)。
usage() 返回 prompt、completion 和 total token 计数(promptTokens()、completionTokens()、totalTokens())。
用 builder 显式设置值#
测试,或拥有多个客户端的服务,有时需要显式值。同一个客户端,手动构建:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
这一行之后的所有内容,params 和 create 调用,都保持与上面完全相同。即使在这里也要继续从环境读取 key;.java 文件中的字符串字面量最终会进入你的仓库。
你最先会遇到的三类错误#
配对
将症状与原因对应起来
点击左侧项目,然后点击其配对项
- 401 Unauthorizedkey 为空或错误,或者因为未设置
OPENAI_BASE_URL,请求发到了 api.openai.com - 404 Not Foundbase URL 缺少
/v1,或 model id 不存在 - finish_reason 显示 length
maxCompletionTokens低于回答所需
空的环境变量在 IDE 中很容易被忽略:从工具栏启动的运行配置可能不会继承你在终端中导出的变量。如果 key“已设置”但仍得到 401,请将变量添加到运行配置中。关于这些状态码的更多信息:API 401 或 404:key、base URL、model id。
一次请求的成本#
因为你打印了 usage,所以可以在扩大规模前为请求定价。假设你的服务发送约 200 个输入 token,并得到 300 个输出。按今天的价格,在 DeepSeek-V4-Flash 上该请求花费 $0.000033。输入和输出一起计费,总计比 OpenRouter 便宜。下表按我们的模型重复计算 1,000 次请求:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
每次请求 200 个输入 token 和 300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
现在代入你自己的流量。将滑块拖到你首次打印的 usage 行中的数字:
成本计算器
一个每天 2,000 次请求的支持服务
每次请求的输入 token 数: 200 · 每次请求的输出 token 数: 300 · 每日请求数: 2,000
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
如果需要每次回答更多空间或不同形态的工作负载,DeepSeek-V4-Flash 提供 380K 上下文窗口,且一天中任何时段价格相同;GLM-5.3-Flash(zai-)可在同一程序中直接替换:只改 id,其他不变。所有模型的当前价格在定价页面,文档展示了其他语言中的相同请求。用 Go 做这个?请参阅openai-go 版本。


