API และ SDKคู่มือ
คำขอแรกใน Java ด้วย openai-java: base URL, key, usage
โปรแกรม Java 8+ ที่รันได้: openai-java ชี้ไปที่ CheapTokens, chat completion หนึ่งครั้ง และพิมพ์คำตอบ, finish_reason และ token usage
ในหน้านี้
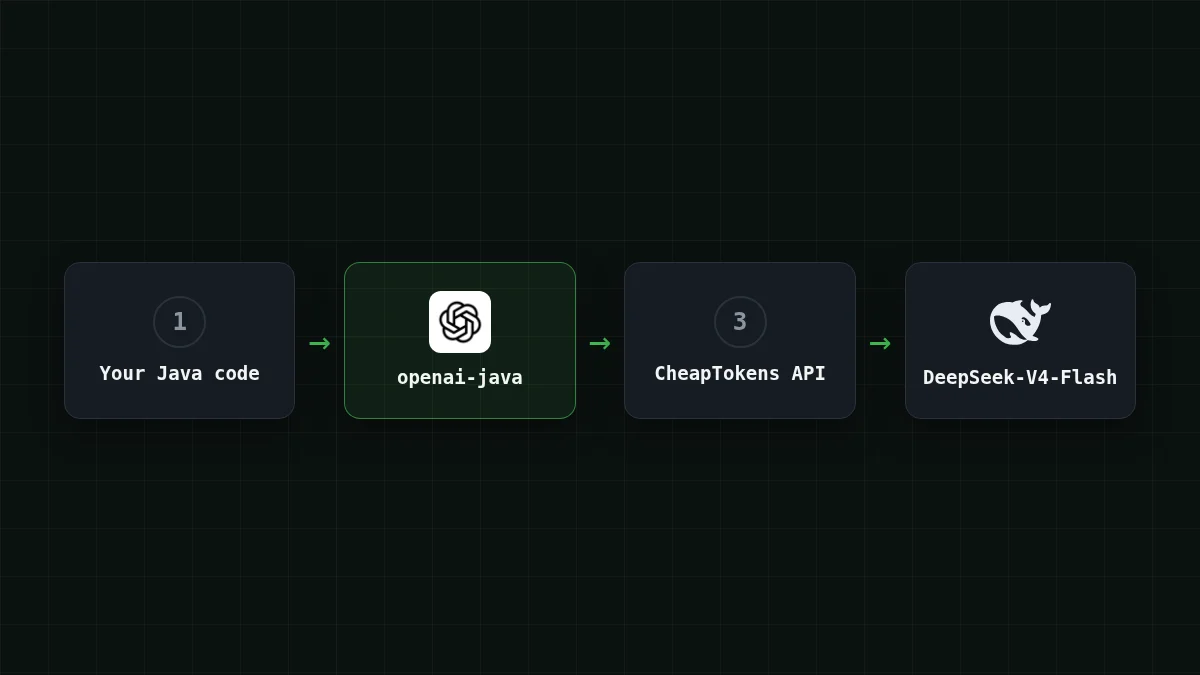
ในการเรียก CheapTokens จาก Java ให้ใช้ SDK อย่างเป็นทางการ openai-java และเปลี่ยนสามอย่าง: base URL (https:/), API key และ model id ที่ส่งเป็น String ธรรมดา โปรแกรมด้านล่างส่ง chat completion หนึ่งครั้งและพิมพ์คำตอบ, finish_reason และ token usage ต้องใช้ Java 8 ขึ้นไป
หากทีมของคุณมี Spring service ที่คุยกับ OpenAI อยู่แล้ว นี่คือการย้ายทั้งหมด: ไม่มี client ใหม่ ไม่มี request class ใหม่
เพิ่ม dependency#
README ของ SDK (github.com/openai/openai-java ตรวจสอบเมื่อ 4 พฤศจิกายน 2026) แสดงเวอร์ชัน 4.99.0, group com.openai, artifact openai-java README ไม่ได้ระบุวันที่ release ดังนั้นให้ดูที่ repository สำหรับเวอร์ชันล่าสุดก่อนคัดลอก
เพิ่ม openai-java ใน build ของคุณ
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")artifact ที่ไม่ผูกกับ framework ทำงานบน Java 8+ ดังนั้น JDK องค์กรรุ่นเก่าไม่ใช่อุปสรรค
ตั้งค่า key และ base URL นอกโค้ด#
SDK อ่าน environment variable สองตัว: OPENAI_API_KEY และ OPENAI_BASE_URL OpenAIOkHttpClient. รับทั้งสองตัว ดังนั้น key จะไม่ไปอยู่ในไฟล์ source ของคุณ (system property openai.apiKey และ openai.baseUrl ก็ใช้ได้และมีลำดับความสำคัญเหนือกว่า variable)
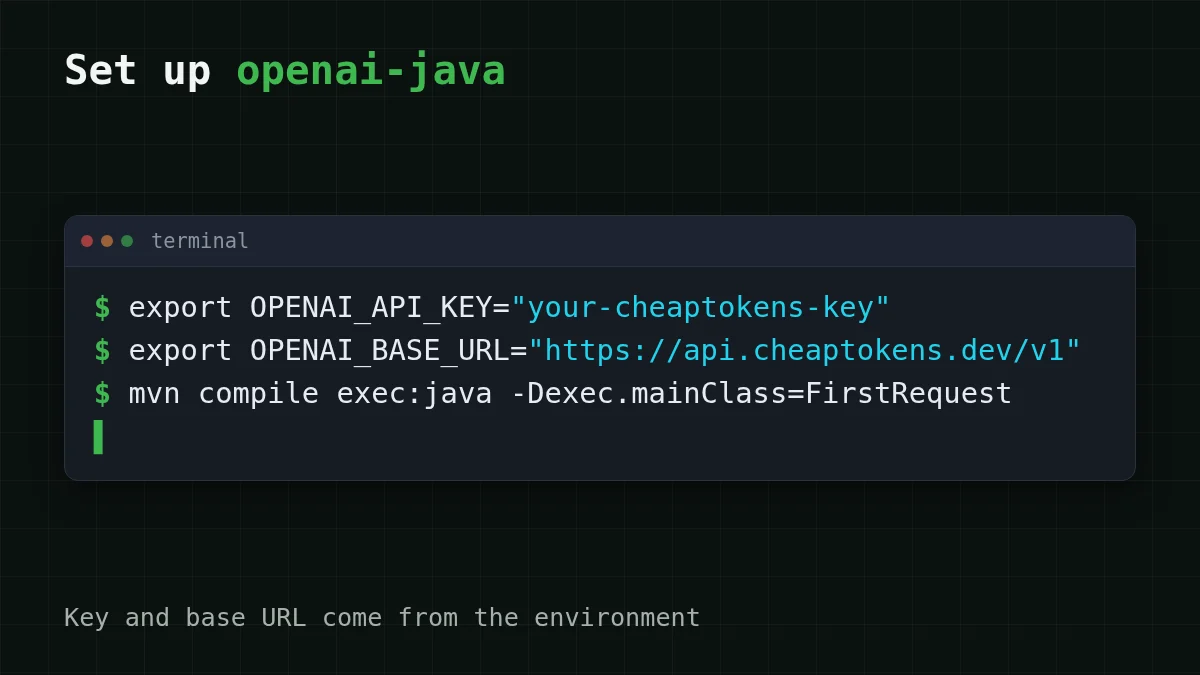
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
base URL เริ่มต้นของ SDK คือ https:/ หากข้ามบรรทัดที่สอง คำขอของคุณจะไปที่นั่นพร้อม key ของ CheapTokens ที่มันไม่รู้จัก นั่นคือวิธีหนึ่งที่จะได้ 401 ในการรันครั้งแรก สำหรับตำแหน่งที่เก็บ key และวิธีกันไม่ให้เข้า git ดู store an API key safely
โปรแกรม#
สร้าง FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
มีบางบรรทัดที่ควรดูอีกครั้ง
.. ตัวอย่างใน README ของ SDK ใช้ค่าคงที่แบบมี type เช่นmodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel.แต่ builder ก็มี overload แบบGPT_ 5_ 2 model(String)ดังนั้น id ใดก็ได้ ใช้ id เต็มจากเอกสาร CheapTokens: ชื่อย่อdeepseek-คือวิธีที่ราคาถูกติดป้ายบนเว็บไซต์; API ต้องการ id เต็มที่มี prefixv4- flash- 0731 deepseek-ai/ไม่แน่ใจ id? List models with GET /v1/models.. เพดานความยาวคำตอบ เป็นmaxCompletionTokens(300L) longDeepSeek-V4-Flash รองรับ output token สูงสุด 32,768 ต่อคำตอบ ดังนั้น 300 ที่นี่เป็นการเลือกเพื่อให้ demo สั้น ไม่ใช่ข้อจำกัดของโมเดลcontent()เป็นOptional. นั่นคือเหตุผลที่โปรแกรมมีorElseคำตอบที่ประกอบด้วย tool call เท่านั้นจะไม่มีข้อความusage()ก็เป็นOptionalเช่นกัน.ifPresentพิมพ์มันเมื่อ server ส่งมา
คอมไพล์และรันตามวิธีที่ build ของคุณทำ (mvn compile exec:java - หรือ task JavaExec ใน Gradle) คุณควรได้คำอธิบายของ token จากนั้นบรรทัด finish_reason: … ที่มี stop อยู่ แล้วจึงเป็นบรรทัดที่มีจำนวน input และ output token หาก finish_reason ระบุ length แสดงว่าคำตอบชนเพดาน 300 token และถูกตัด: เพิ่มจำนวนนั้น (why that happens)
usage() คืนจำนวน token ของ prompt, completion และ total (promptTokens(), completionTokens(), totalTokens())
ตั้งค่าอย่างชัดเจนด้วย builder#
การทดสอบ หรือ service ที่มีหลาย client บางครั้งต้องการค่าที่ชัดเจน client เดียวกัน สร้างด้วยมือ:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
ทุกอย่างหลังจากบรรทัดนี้ ทั้ง params และการเรียก create ยังคงเหมือนเดิม แม้แต่ที่นี่ก็ให้อ่าน key จาก environment; string literal ในไฟล์ .java จะไปอยู่ใน repository ของคุณ
สามข้อผิดพลาดที่คุณจะเจอเป็นอันดับแรก#
จับคู่
จับคู่อาการกับสาเหตุ
แตะรายการทางซ้าย แล้วแตะคู่ของมัน
- 401 Unauthorizedkey ว่างหรือผิด หรือคำขอไปที่ api.openai.com เพราะไม่ได้ตั้ง
OPENAI_BASE_URL - 404 Not Foundbase URL ขาด
/v1หรือ model id ไม่มีอยู่ - finish_reason ระบุ length
maxCompletionTokensต่ำกว่าที่คำตอบต้องการ
environment variable ที่ว่างเปล่านั้นมองข้ามได้ง่ายใน IDE: run configuration ที่เริ่มจาก toolbar อาจไม่ได้รับ variable ที่คุณ export ใน terminal หาก key "ถูกตั้งแล้ว" แต่ยังได้ 401 ให้เพิ่ม variable ใน run configuration เพิ่มเติมเกี่ยวกับรหัสเหล่านี้: API 401 or 404: key, base URL, model id
หนึ่งคำขอมีค่าใช้จ่ายเท่าไร#
เพราะคุณพิมพ์ usage คุณจึงคำนวณราคาคำขอก่อนขยาย規模ได้ สมมติ service ของคุณส่ง input ประมาณ 200 token และได้กลับมา 300 ที่ราคาวันนี้ คำขอนั้นมีค่าใช้จ่าย $0.000033 บน DeepSeek-V4-Flash input และ output คิดเงินรวมกัน และโดยรวมแล้วถูกกว่า OpenRouter ตารางแสดงซ้ำสำหรับ 1,000 คำขอในโมเดลของเรา:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 1,000 คำขอ | OpenRouter, 1,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 โทเค็นอินพุตและ 300 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ตอนนี้ใส่ทราฟฟิกของคุณเอง ลากสไลเดอร์ไปยังตัวเลขจากบรรทัด usage ที่พิมพ์ครั้งแรก:
เครื่องคำนวณค่าใช้จ่าย
บริการซัพพอร์ตที่มี 2,000 คำขอต่อวัน
โทเค็นอินพุตต่อคำขอ: 200 · โทเค็นเอาต์พุตต่อคำขอ: 300 · คำขอต่อวัน: 2,000
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
หากต้องการพื้นที่ต่อคำตอบมากขึ้นหรือ workload รูปแบบอื่น DeepSeek-V4-Flash ให้ context window 380K และราคาเดียวทุกชั่วโมงของวัน; GLM-5.3-Flash (zai-) เป็นตัวแทนที่ใช้แทนได้ทันทีในโปรแกรมเดียวกัน: เปลี่ยน id ไม่ต้องแก้อื่น ราคาปัจจุบันของทุกโมเดลอยู่ที่ pricing page และ docs แสดงคำขอเดียวกันในภาษาอื่น ทำสิ่งนี้ใน Go? ดู the openai-go version


