API और SDKगाइड
openai-java के साथ Java में पहला अनुरोध: base URL, key, usage
एक रन करने योग्य Java 8+ प्रोग्राम: CheapTokens की ओर इंगित openai-java, एक chat completion, और उत्तर, finish_reason और token usage प्रिंट।
इस पृष्ठ पर
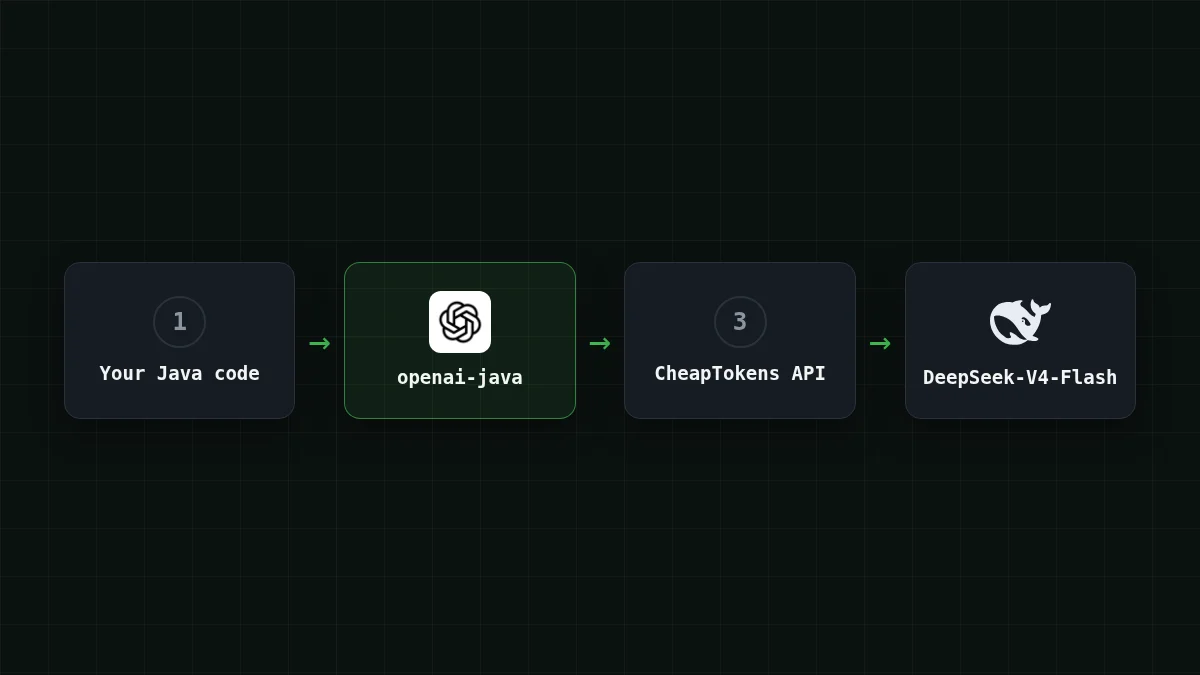
Java से CheapTokens को कॉल करने के लिए, आधिकारिक openai-java SDK रखें और तीन चीज़ें बदलें: बेस URL (https:/), API key, और model id, जिसे सादे String के रूप में पास किया जाता है। नीचे दिया गया प्रोग्राम एक chat completion भेजता है और उत्तर, finish_reason और token usage प्रिंट करता है। इसके लिए Java 8 या बाद का संस्करण आवश्यक है।
यदि आपकी टीम के पास पहले से एक Spring सेवा है जो OpenAI से बात करती है, तो यह पूरा माइग्रेशन है: कोई नया क्लाइंट नहीं, कोई नई request क्लास नहीं।
डिपेंडेंसी जोड़ें#
SDK का README (github.com/openai/openai-java, 4 नवंबर 2026 को जाँचा गया) संस्करण 4.99.0, group com.openai, artifact openai-java दिखाता है। README कोई रिलीज़ तिथि नहीं छापता, इसलिए इसे कॉपी करने से पहले नवीनतम संस्करण के लिए रिपॉज़िटरी देखें।
अपने बिल्ड में openai-java जोड़ें
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")फ्रेमवर्क-न्यूट्रल आर्टिफैक्ट Java 8+ पर चलते हैं, इसलिए पुराना कॉर्पोरेट JDK बाधा नहीं है।
key और base URL को कोड के बाहर सेट करें#
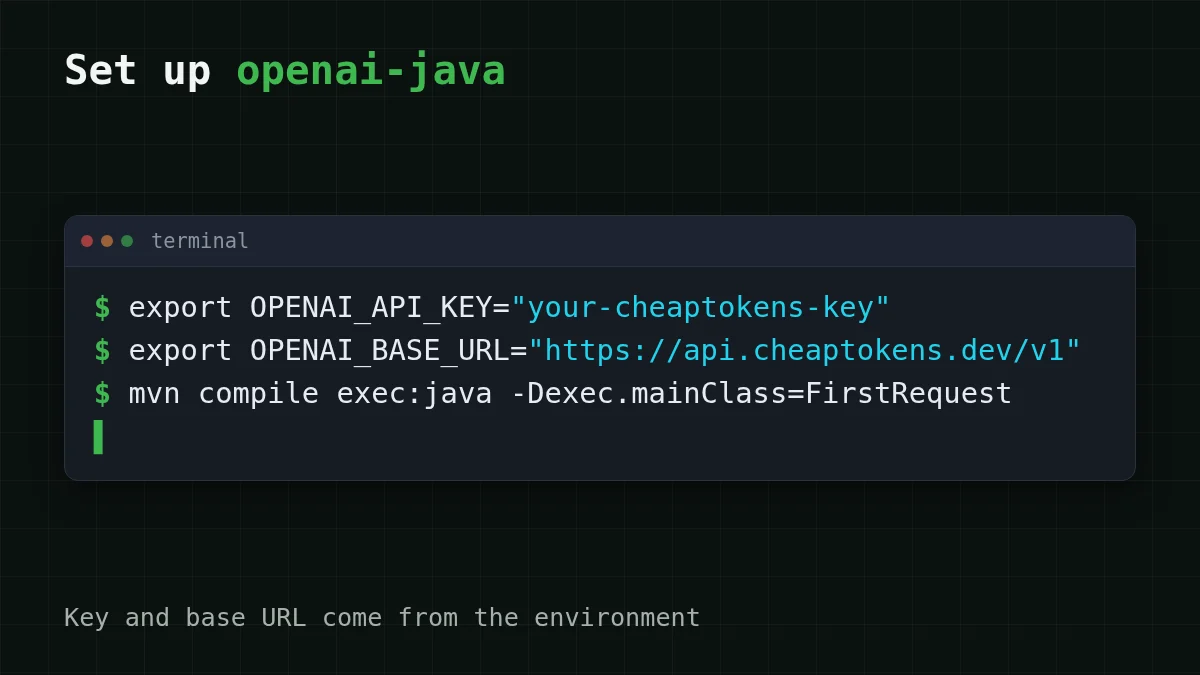
SDK दो environment variables पढ़ता है: OPENAI_API_KEY और OPENAI_BASE_URL। OpenAIOkHttpClient. दोनों को उठा लेता है, इसलिए key कभी आपकी सोर्स फ़ाइलों में नहीं जाती। (System properties openai.apiKey और openai.baseUrl भी काम करते हैं और variables पर प्राथमिकता लेते हैं।)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
SDK का डिफ़ॉल्ट base URL https:/ है। दूसरी पंक्ति छोड़ें और आपका अनुरोध वहीं जाता है, जहाँ CheapTokens key अपरिचित है। यह पहली बार चलाने पर 401 पाने का एक तरीका है। key कहाँ रखें और इसे git से बाहर कैसे रखें, इसके लिए देखें API key सुरक्षित रूप से संग्रहीत करें।
प्रोग्राम#
FirstRequest. बनाएँ:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
कुछ पंक्तियाँ दूसरी नज़र के योग्य हैं।
.. SDK के README उदाहरणmodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel.जैसे टाइप्ड कॉन्स्टेंट का उपयोग करते हैं, लेकिन builder मेंGPT_ 5_ 2 model(String)ओवरलोड भी है, इसलिए कोई भी id काम करता है। CheapTokens डॉक्स से पूरा id उपयोग करें: छोटा नामdeepseek-साइट पर कीमतों को लेबल करने का तरीका है; API कोv4- flash- 0731 deepseek-ai/प्रीफ़िक्स के साथ पूरा id चाहिए। id का यकीन नहीं? GET /v1/models से मॉडल सूचीबद्ध करें।.. उत्तर की लंबाई पर एक सीमा,maxCompletionTokens(300L) longके रूप में। DeepSeek-V4-Flash प्रति उत्तर अधिकतम 32,768 आउटपुट टोकन की अनुमति देता है, इसलिए यहाँ 300 डेमो को छोटा रखने का विकल्प है, मॉडल की सीमा नहीं।content()एकOptionalहै। इसलिए प्रोग्राम मेंorElseहै। केवल tool calls से बना उत्तर में कोई टेक्स्ट नहीं होता।usage()भी एकOptionalहै।ifPresentइसे प्रिंट करता है जब सर्वर इसे भेजता है।
इसे उसी तरह कंपाइल और रन करें जैसे आपका बिल्ड करता है (mvn compile exec:java -, या Gradle में JavaExec टास्क)। आपको एक टोकन की व्याख्या मिलनी चाहिए, फिर finish_reason: … वाली एक पंक्ति जिसमें stop हो, फिर इनपुट और आउटपुट टोकन गणना वाली एक पंक्ति। यदि finish_reason कहता है length, तो उत्तर आपकी 300-टोकन सीमा पर पहुँच गया और कट गया: संख्या बढ़ाएँ (ऐसा क्यों होता है)।
usage() प्रॉम्प्ट, कम्प्लीशन और कुल टोकन गणना लौटाता है (promptTokens(), completionTokens(), totalTokens())।
builder के साथ मान स्पष्ट रूप से सेट करें#
टेस्ट, या कई क्लाइंट वाली सेवा, को कभी-कभी स्पष्ट मान चाहिए। वही क्लाइंट, हाथ से बनाया गया:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
इस पंक्ति के बाद सब कुछ, params और create कॉल, ऊपर के अनुसार ही रहता है। यहाँ भी key को environment से पढ़ते रहें; .java फ़ाइल में एक स्ट्रिंग लिटरल आपके रिपॉज़िटरी में पहुँच जाता है।
तीन त्रुटियाँ जो आप पहले मिलेंगी#
जोड़े मिलाएँ
लक्षण को कारण से मिलाएँ
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- 401 Unauthorizedkey खाली या गलत है, या अनुरोध api.openai.com पर गया क्योंकि
OPENAI_BASE_URLसेट नहीं है - 404 Not Foundbase URL में
/v1नहीं है, या model id मौजूद नहीं है - finish_reason कहता है length
maxCompletionTokensउत्तर की आवश्यकता से कम है
IDE में खाली environment variable को नज़रअंदाज़ करना आसान है: टूलबार से शुरू किया गया रन कॉन्फ़िगरेशन उन variables को विरासत में नहीं ले सकता जो आपने टर्मिनल में एक्सपोर्ट किए थे। यदि key "सेट है" लेकिन फिर भी 401 मिलता है, तो रन कॉन्फ़िगरेशन में variables जोड़ें। इन कोड पर अधिक: API 401 या 404: key, base URL, model id।
एक अनुरोध की लागत#
क्योंकि आप usage प्रिंट करते हैं, आप अनुरोध को स्केल करने से पहले उसकी कीमत लगा सकते हैं। मान लें आपकी सेवा लगभग 200 इनपुट टोकन भेजती है और 300 वापस पाती है। आज की कीमतों पर वह अनुरोध DeepSeek-V4-Flash पर $0.000033 का है। इनपुट और आउटपुट एक साथ बिल किए जाते हैं, और कुल मिलाकर यह OpenRouter से सस्ता है। तालिका इसे हमारे मॉडलों में 1,000 अनुरोधों के लिए दोहराती है:
| मॉडल | इनपुट $/1M | आउटपुट $/1M | प्रति अनुरोध | 1,000 अनुरोध | OpenRouter, 1,000 अनुरोध |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
प्रति अनुरोध 200 इनपुट और 300 आउटपुट टोकन। प्रति 1M टोकन की कीमतें वर्तमान हैं और हमारे टैरिफ के साथ बदलती रहती हैं; OpenRouter कॉलम समान कार्यभार के लिए संदर्भ कीमतें दिखाता है।
अब अपना ट्रैफ़िक डालें। स्लाइडर को अपनी पहली प्रिंट की गई usage पंक्ति के नंबरों पर खींचें:
लागत कैलकुलेटर
प्रति दिन 2,000 अनुरोधों वाली एक सहायता सेवा
प्रति अनुरोध इनपुट टोकन: 200 · प्रति अनुरोध आउटपुट टोकन: 300 · प्रति दिन अनुरोध: 2,000
| मॉडल | प्रति दिन | प्रति माह |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
प्रति उत्तर अधिक जगह या भिन्न प्रकार के वर्कलोड के लिए, DeepSeek-V4-Flash आपको 380K कॉन्टेक्स्ट विंडो और दिन के किसी भी समय एक ही कीमत देता है; GLM-5.3-Flash (zai-) उसी प्रोग्राम में ड्रॉप-इन रिप्लेसमेंट है: id बदलें, और कुछ नहीं। सभी मॉडलों की वर्तमान कीमतें मूल्य पृष्ठ पर हैं, और डॉक्स अन्य भाषाओं में वही अनुरोध दिखाते हैं। इसे Go में कर रहे हैं? देखें openai-go संस्करण।


