API اور SDKگائیڈ
openai-java کے ساتھ Java میں پہلی request: base URL، key، usage
ایک چلنے والا Java 8+ پروگرام: openai-java CheapTokens کی طرف اشارہ کیا گیا، ایک chat completion، اور جواب، finish_reason اور token usage پرنٹ۔
اس صفحہ پر
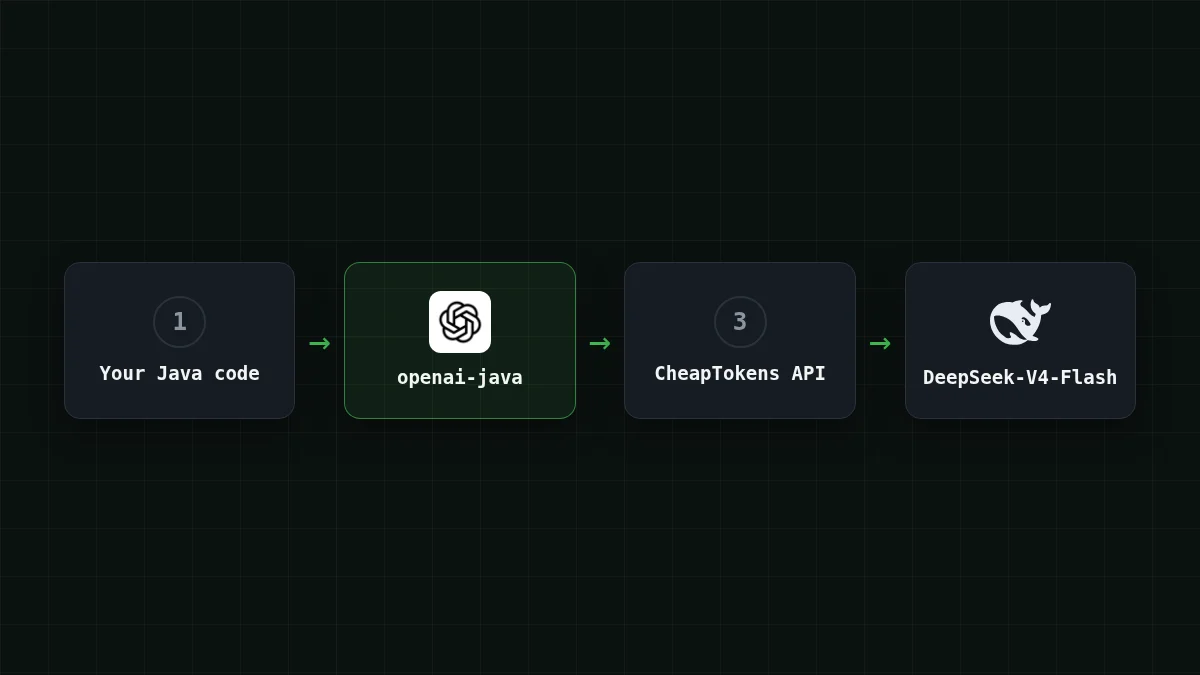
Java سے CheapTokens کو کال کرنے کے لیے، سرکاری openai-java SDK رکھیں اور تین چیزیں تبدیل کریں: base URL (https:/)، API key، اور model id، جو ایک سادہ String کے طور پر پاس کی جاتی ہے۔ نیچے دیا گیا پروگرام ایک chat completion بھیجتا ہے اور جواب، finish_reason اور token usage پرنٹ کرتا ہے۔ اس کے لیے Java 8 یا اس سے جدید ورژن درکار ہے۔
اگر آپ کی ٹیم کے پاس پہلے سے کوئی Spring سروس ہے جو OpenAI سے بات کرتی ہے، تو پوری migration یہی ہے: کوئی نیا client نہیں، کوئی نئی request classes نہیں۔
dependency شامل کریں#
SDK کا README (github.com/openai/openai-java، 4 نومبر 2026 کو چیک کیا گیا) ورژن 4.99.0، group com.openai، artifact openai-java دکھاتا ہے۔ README کوئی release date نہیں دکھاتا، اس لیے اسے کاپی کرنے سے پہلے تازہ ترین ورژن کے لیے repository دیکھیں۔
اپنی build میں openai-java شامل کریں
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")framework-neutral artifacts Java 8+ پر چلتے ہیں، اس لیے پرانا corporate JDK رکاوٹ نہیں ہے۔
key اور base URL کوڈ سے باہر رکھیں#
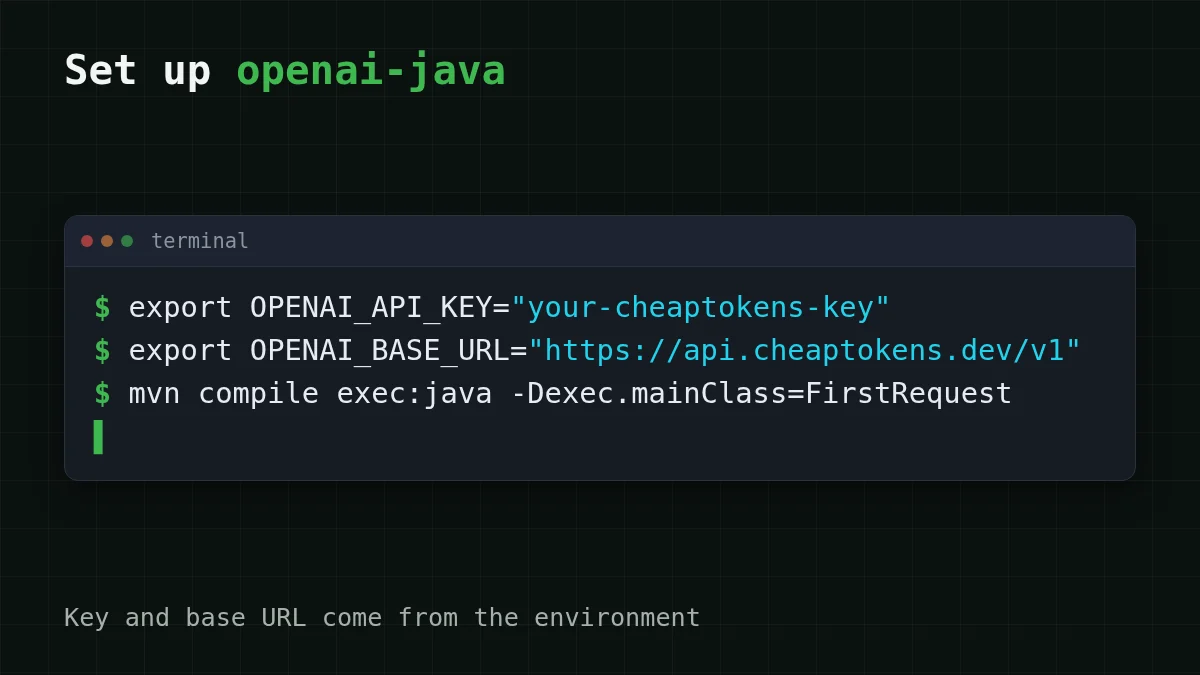
SDK دو environment variables پڑھتا ہے: OPENAI_API_KEY اور OPENAI_BASE_URL۔ OpenAIOkHttpClient. دونوں اٹھا لیتا ہے، اس لیے key کبھی آپ کی source files میں نہیں پہنچتی۔ (System properties openai.apiKey اور openai.baseUrl بھی کام کرتی ہیں اور variables پر فوقیت رکھتی ہیں۔)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
SDK کا default base URL https:/ ہے۔ دوسری لائن چھوڑ دیں تو آپ کی request وہاں جاتی ہے، ایسی CheapTokens key کے ساتھ جسے وہ نہیں جانتا۔ یہ پہلی بار چلانے پر 401 حاصل کرنے کا ایک طریقہ ہے۔ key کہاں رکھیں اور اسے git سے باہر کیسے رکھیں، اس کے لیے دیکھیں store an API key safely۔
پروگرام#
FirstRequest. بنائیں:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
چند لائنیں دوبارہ دیکھنے کے قابل ہیں۔
.۔ SDK کے README کی مثالیںmodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel.جیسے typed constants استعمال کرتی ہیں، لیکن builder میںGPT_ 5_ 2 model(String)overload بھی ہے، اس لیے کوئی بھی id کام کرتی ہے۔ CheapTokens docs سے مکمل id استعمال کریں: مختصر نامdeepseek-وہ ہے جس سے سائٹ پر قیمتیں لیبل ہوتی ہیں؛ API کوv4- flash- 0731 deepseek-ai/prefix کے ساتھ مکمل id چاہیے۔ id کا یقین نہیں؟ List models with GET /v1/models۔.۔ جواب کی لمبائی پر حد، بطورmaxCompletionTokens(300L) long۔ DeepSeek-V4-Flash فی جواب زیادہ سے زیادہ 32,768 output tokens کی اجازت دیتا ہے، اس لیے یہاں 300 ڈیمو کو مختصر رکھنے کا انتخاب ہے، model کی حد نہیں۔content()ایکOptionalہے۔ اسی لیے پروگرام میںorElseہے۔ صرف tool calls پر مشتمل جواب میں کوئی متن نہیں ہوتا۔usage()بھی ایکOptionalہے۔ جب سرور بھیجتا ہے توifPresentاسے پرنٹ کرتا ہے۔
اسے اسی طرح compile اور run کریں جیسے آپ کی build کرتی ہے (mvn compile exec:java -، یا Gradle میں JavaExec task)۔ آپ کو token کی وضاحت ملنی چاہیے، پھر finish_reason: … والی ایک لائن جس میں stop ہو، پھر input اور output token counts والی ایک لائن۔ اگر finish_reason میں length لکھا ہو، تو جواب آپ کی 300-token حد پر پہنچ کر کٹ گیا: نمبر بڑھائیں (ایسا کیوں ہوتا ہے)۔
usage() prompt، completion اور total token counts واپس کرتا ہے (promptTokens()، completionTokens()، totalTokens())۔
builder کے ساتھ values واضح طور پر سیٹ کریں#
Tests، یا کئی clients والی سروس، کو کبھی کبھی واضح values درکار ہوتی ہیں۔ وہی client، ہاتھ سے بنایا گیا:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
اس لائن کے بعد سب کچھ، params اور create کال، بالکل ویسا ہی رہتا ہے جیسا اوپر ہے۔ یہاں بھی key environment سے ہی پڑھیں؛ .java فائل میں string literal آپ کے repository میں پہنچ جاتا ہے۔
تین errors جو آپ سب سے پہلے ملیں گے#
جوڑے ملائیں
علامت کو وجہ سے ملائیں
بائیں طرف کسی آئٹم پر ٹیپ کریں، پھر اس کا جوڑا
- 401 Unauthorizedkey خالی یا غلط ہے، یا request api.openai.com پر گئی کیونکہ
OPENAI_BASE_URLسیٹ نہیں - 404 Not Foundbase URL میں
/v1نہیں، یا model id موجود نہیں - finish_reason کہتا ہے length
maxCompletionTokensجواب کی ضرورت سے کم ہے
IDE میں خالی environment variable نظر سے چھوٹ جانا آسان ہے: toolbar سے شروع کی گئی run configuration شاید وہ variables inherit نہ کرے جو آپ نے terminal میں export کیے۔ اگر key "سیٹ ہے" مگر پھر بھی 401 ملتا ہے، تو run configuration میں variables شامل کریں۔ ان codes پر مزید: API 401 or 404: key, base URL, model id۔
ایک request کی لاگت#
چونکہ آپ usage پرنٹ کرتے ہیں، آپ scale کرنے سے پہلے request کی قیمت لگا سکتے ہیں۔ فرض کریں آپ کی سروس تقریباً 200 input tokens بھیجتی ہے اور 300 واپس پاتی ہے۔ آج کی قیمتوں پر وہ request DeepSeek-V4-Flash پر $0.000033 کی پڑتی ہے۔ Input اور output ایک ساتھ بل ہوتے ہیں، اور مجموعی طور پر یہ OpenRouter سے سستا ہے۔ جدول ہمارے models میں 1,000 requests کے لیے اسے دہراتا ہے:
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
فی درخواست 200 ان پٹ اور 300 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
اب اپنی traffic ڈالیں۔ sliders کو اپنی پہلی پرنٹ شدہ usage لائن کے نمبروں پر لے جائیں:
لاگت کیلکولیٹر
روزانہ 2,000 requests والی support سروس
فی درخواست ان پٹ ٹوکنز: 200 · فی درخواست آؤٹ پٹ ٹوکنز: 300 · فی دن درخواستیں: 2,000
| ماڈل | فی دن | فی ماہ |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
فی جواب زیادہ گنجائش یا مختلف قسم کے workload کے لیے، DeepSeek-V4-Flash آپ کو 380K context window اور دن کے کسی بھی وقت ایک ہی قیمت دیتا ہے؛ GLM-5.3-Flash (zai-) اسی پروگرام میں drop-in replacement ہے: id بدلیں، بس۔ تمام models کی موجودہ قیمتیں pricing page پر ہیں، اور docs وہی request دیگر زبانوں میں دکھاتے ہیں۔ یہ Go میں کر رہے ہیں؟ دیکھیں the openai-go version۔


