API اور SDKگائیڈ
Rust میں async-openai کے ساتھ پہلی request: base URL، key، usage
tokio اور async-openai کے ساتھ ایک چھوٹا Rust پروگرام جو CheapTokens کو ایک chat completion بھیجتا ہے اور جواب اور token counts پرنٹ کرتا ہے۔
اس صفحہ پر
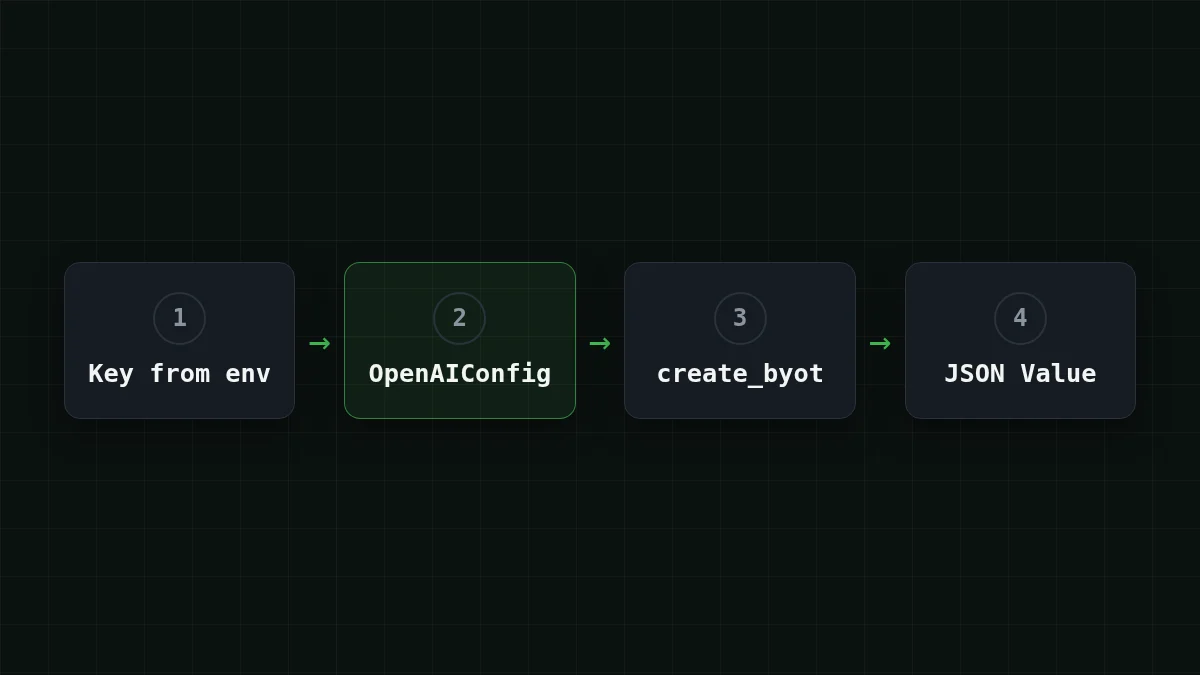
Rust میں async-openai کے ساتھ CheapTokens کو کال کرنے کے لیے، base URL https:/ اور اپنی key کے ساتھ ایک OpenAIConfig بنائیں، پھر create_byot اور JSON body کے ساتھ request بھیجیں۔ جواب کا متن اور token counts واپس آنے والے JSON سے نکلتے ہیں۔ یہ تقریباً 25 لائنوں کا کوڈ ہے، اور ایک ہی string بدلنے پر یہی پروگرام CheapTokens models page پر موجود کسی بھی model کے لیے کام کرتا ہے۔
crate کا docs.rs صفحہ (8 نومبر 2026 کو چیک کیا گیا) MIT لائسنس کے تحت version 0.43.0 دکھاتا ہے، اور یہی وہ version ہے جس کی اس گائیڈ میں پیروی کی گئی ہے۔
typed requests کے بجائے create_byot کیوں#
async-openai عام طور پر آپ کو ایک typed request builder دیتا ہے: آپ ایک struct بھرتے ہیں، یہ آپ کو struct واپس دیتا ہے۔ یہ اس وقت تک آرام دہ ہے جب تک gateway کوئی ایسا field واپس نہ کرے جو structs نہیں جانتے۔ byot feature ("bring your own types") *_byot methods شامل کرتا ہے جو کوئی بھی JSON body لیتے ہیں اور کوئی بھی ایسی type واپس دیتے ہیں جسے آپ deserialize کر سکیں، بشمول سادہ serde_۔
پہلی request کے لیے یہی وہ چیز ہے جو آپ چاہتے ہیں۔ آپ وہی JSON لکھتے ہیں جو آپ curl کال میں ڈالتے، اور usage براہ راست response سے پڑھتے ہیں، بغیر کسی type کو تلاش کرنے کے۔
پروجیکٹ سیٹ اپ کریں#
قدم بہ قدم
پروجیکٹ بنائیں اور key سیٹ کریں
crates شامل کریں
ایک نئے پروجیکٹ میں (cargo new cheaptokens-)، تین dependencies شامل کریں۔ async-openai کو یہاں دو features چاہیے: create_byot methods کے لیے byot اور chat سیکشن کے لیے chat-completion۔
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
key کو environment variable میں رکھیں
اپنے CheapTokens اکاؤنٹ میں key بنائیں اور اسے source code سے باہر رکھیں۔ اگر آپ تفصیلی ورژن چاہتے ہیں تو how to store an API key safely دیکھیں۔
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell پر وہی لائن $env:CHEAPTOKENS_ ہے۔
پروگرام چلائیں
اگلے سیکشن کا کوڈ src/main.rs میں پیسٹ کریں اور اسے شروع کریں۔
cargo runپروگرام#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
تین لائنیں پورا خیال سمیٹے ہوئے ہیں۔ with_api_base وہ جگہ ہے جہاں CheapTokens آتا ہے: base URL /v1 پر ختم ہوتا ہے، اور async-openai خود endpoint path شامل کرتا ہے۔ with_api_key وہ value لیتا ہے جو ہم نے environment سے پڑھی۔ اور model مکمل id deepseek- ہے — price tables کے مختصر نام API قبول نہیں کرتا۔
کسی Value کو missing key کے ساتھ index کرنے پر panic کے بجائے null ملتا ہے، اس لیے field کے نام میں ٹائپو آؤٹ پٹ میں crash کے بجائے null کے طور پر ظاہر ہوتا ہے۔ یہ response کو explore کرتے وقت بہت کام آتا ہے۔
کیا واپس آتا ہے#
gateway OpenAI Chat Completions format بولتا ہے، اس لیے response کی معمول کی شکل ہوتی ہے (یہاں تراشا گیا، ... ان fields کو نشان زد کرتا ہے جنہیں ہم چھوڑ دیتے ہیں):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
usage میں موجود اعداد آپ کی request کے حقیقی counts ہیں، اس لیے چلانے پر یہ zeros کی جگہ لے لیتے ہیں۔ prompt_tokens وہ ہے جو آپ نے بھیجا، completion_ وہ ہے جو model نے لکھا۔ ان کی billing مختلف قیمتوں پر ہوتی ہے، اور انہیں پرنٹ کرنے کا مقصد یہی ہے۔ اگر یہ فرق آپ کے لیے نیا ہے تو input vs output tokens اسے پانچ منٹ میں سمجھا دیتا ہے۔
خود آزمائیںآزمائیں: "max_tokens" کو 5 پر سیٹ کریں اور دوبارہ چلائیں۔ finish_reason کیا کہتا ہے؟جواب دکھائیں
OpenAI Chat Completions format میں یہ length کہتا ہے۔ model آپ کی حد پر پہنچ گیا اور جملہ درمیان میں کٹ گیا۔ معمول کے جواب کے ساتھ یہ stop کہتا ہے۔ اگر کسی حقیقی job میں length نظر آئے تو max_tokens بڑھائیں — this article اس کا حل بتاتا ہے۔
ایک request کی لاگت#
فرض کریں آپ یہ کال loop میں چلاتے ہیں، اندر ایک چھوٹا سوال اور باہر ایک مختصر جواب: ہر بار 300 input tokens اور 200 output tokens۔ DeepSeek-V4-Flash پر یہ فی request $0.000025 ہے، $0.015 فی 1M input tokens اور $0.10 فی 1M output tokens کی live قیمت سے۔ input اور output کو ملا کر گننے پر یہ OpenRouter سے سستا ہے، اور model 380K context رکھتا ہے اور 32,768 tokens تک جواب دیتا ہے۔
نیچے دیا گیا جدول ہر model پر وہی request دکھاتا ہے، 1,000 سے ضرب دے کر۔
| ماڈل | ان پٹ $/1M | آؤٹ پٹ $/1M | فی درخواست | 1,000 درخواستیں | OpenRouter، 1,000 درخواستیں |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
فی درخواست 300 ان پٹ اور 200 آؤٹ پٹ ٹوکنز۔ فی 1M ٹوکنز کی قیمتیں موجودہ ہیں اور ہمارے ٹیرف کے ساتھ تبدیل ہوتی ہیں؛ OpenRouter کالم اسی ورک لوڈ کے لیے حوالہ جاتی قیمتیں دکھاتا ہے۔
قیمتیں pricing page پر ہیں۔
model تبدیل کرنا#
model بدلنے پر کوڈ نہیں بدلتا؛ صرف "model" میں موجود string بدلتی ہے۔ مثال کے طور پر، zai- کا 390K context ہے اور یہ 8,192 tokens تک جواب دیتا ہے۔ کوڈ میں بالکل ترمیم سے بچنے کے لیے، id کو std::env::var("CHEAPTOKENS_ کے ساتھ دوسرے variable سے پڑھیں۔ اگر آپ کو یقین نہیں کہ آپ کی key کون سی ids دیکھتی ہے تو list models with GET /v1/models۔
اگر یہ کام نہ کرے#
- بالکل شروع میں
environment variable not found: key اس terminal میں export نہیں ہوئی۔ اسے اسی ونڈو میں دوبارہ export کریں جہاں آپcargo runچلاتے ہیں۔ - API سے 401 error: key غلط ہے یا اس کے اردگرد کوئی اضافی space یا quote ہے۔
- 404 error: چیک کریں کہ base URL
/v1پر ختم ہوتا ہے اور model id مکمل ہے،deepseek-ai/prefix کے ساتھ۔ API 401 or 404: key, base URL, model id اس پر تفصیل سے گزرتا ہے۔ - compiler کو
create_byotنہیں مل رہا:byotfeature فعال نہیں ہے۔ setup سےcargo addلائن دوبارہ چلائیں۔
اگر کوئی connection مسئلہ ان میں سے کوئی نہیں ہے تو common connection errors دیکھیں۔
یہی پہلی request دوسری زبانوں کے لیے بھی موجود ہے: Go اور Ruby۔ خود API کے بارے میں مزید جاننے کے لیے CheapTokens docs کھولیں۔


