APIとSDKガイド
async-openai で Rust の最初のリクエスト: ベース URL、キー、使用量
tokio と async-openai を使った小さな Rust プログラムで、CheapTokens に 1 回のチャット補完を送信し、返信とトークン数を出力します。
Rust から async-openai で CheapTokens を呼び出すには、ベース URL https:/ とあなたのキーを指定して OpenAIConfig を構築し、create_byot と JSON ボディでリクエストを送信します。返信テキストとトークン数は、返ってきた JSON から取り出します。コードは約 25 行で、文字列を 1 つ変更するだけで、同じプログラムが CheapTokens のモデルページにあるどのモデルでも動作します。
このクレートの docs.rs ページ(2026 年 11 月 8 日確認)には MIT ライセンスでバージョン 0.43.0 が記載されており、本ガイドはこのバージョンに従っています。
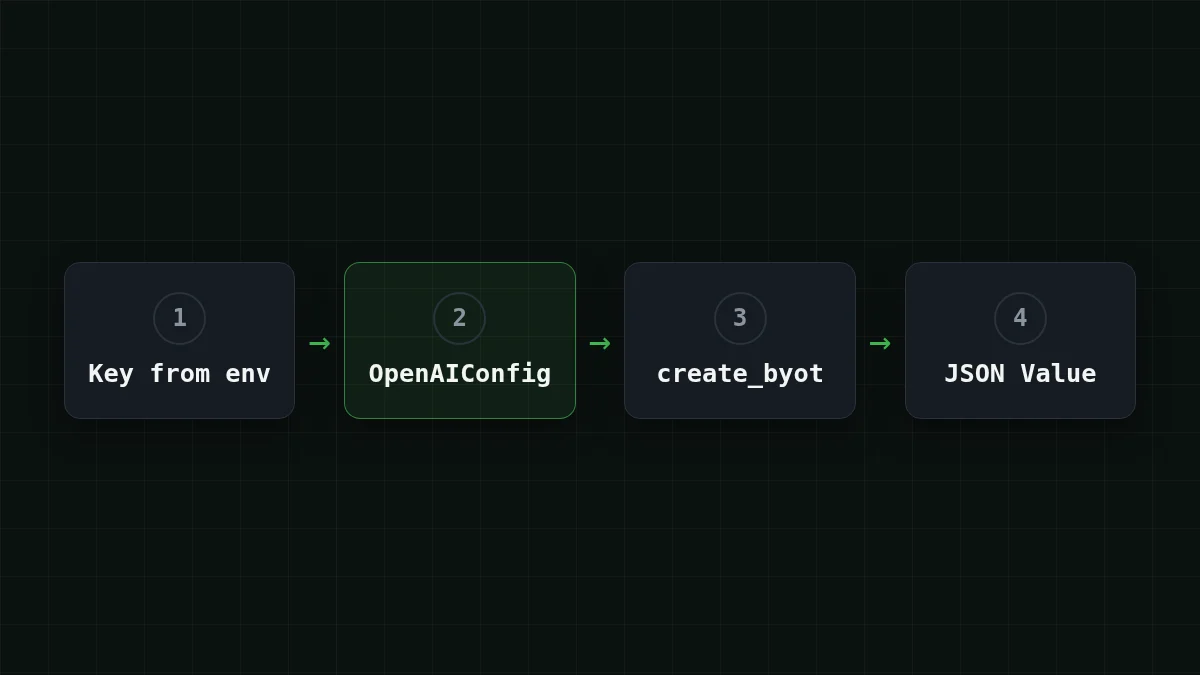
型付きリクエストではなく create_byot を使う理由#
async-openai は通常、型付きのリクエストビルダーを提供します。構造体を埋めると、構造体が返ってきます。これは、ゲートウェイが構造体の知らないフィールドを返すまでは快適です。byot フィーチャー(「bring your own types」)は、任意の JSON ボディを受け取り、デシリアライズ可能な任意の型(プレーンな serde_ を含む)を返す *_byot メソッドを追加します。
最初のリクエストにはまさにこれが適しています。curl 呼び出しに書くのと同じ JSON を書き、usage をレスポンスから直接読み取ります。型を調べる必要はありません。
プロジェクトのセットアップ#
ステップバイステップ
プロジェクトを作成し、キーを設定する
クレートを追加する
新規プロジェクト(cargo new cheaptokens-)で、3 つの依存関係を追加します。async-openai にはここで 2 つのフィーチャーが必要です。create_byot メソッド用の byot と、チャットセクション用の chat-completion です。
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
キーを環境変数に入れる
CheapTokens アカウントでキーを作成し、ソースコードには入れないでください。詳しい説明が必要なら、API キーを安全に保存する方法をご覧ください。
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell では同じ行は $env:CHEAPTOKENS_ です。
プログラムを実行する
次のセクションのコードを src/main.rs に貼り付けて起動します。
cargo runプログラム#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
3 行が全体の要点を担っています。with_api_base は CheapTokens を設定する場所です。ベース URL は /v1 で終わり、async-openai がエンドポイントパス自体を追加します。with_api_key は環境から読み取った値を取ります。そして model は完全な ID deepseek- です。価格表の短い名前は API では受け付けられません。
存在しないキーで Value をインデックスすると、パニックではなく null が返るため、フィールド名のタイプミスはクラッシュではなく出力の null として現れます。レスポンスを調べるときに便利です。
返ってくるもの#
ゲートウェイは OpenAI Chat Completions 形式を話すため、レスポンスは通常の形をしています(ここでは省略しており、... はスキップするフィールドを示します):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
usage の数値はあなたのリクエストに対する実際のカウントなので、実行するとゼロが置き換わります。prompt_tokens は送信した内容、completion_ はモデルが書いた内容です。これらは異なる価格で課金されるため、表示する意味があります。この違いが初めてなら、入力トークンと出力トークンが 5 分で説明します。
自分で試す試してみましょう: "max_tokens" を 5 に設定して再度実行します。finish_reason は何と言っていますか?答えを表示
OpenAI Chat Completions 形式では length と表示されます。モデルが上限に達し、文が途中で切れています。通常の回答では stop と表示されます。実際のジョブで length が表示されたら、max_tokens を増やしてください — この記事で修正方法を説明しています。
1 リクエストのコスト#
この呼び出しをループで実行し、小さな質問を入力して短い回答を出力するとします: 各 300 入力トークンと 200 出力トークン。DeepSeek-V4-Flash では、1M 入力トークンあたり $0.015、1M 出力トークンあたり $0.10 の最新価格から、1 リクエストあたり $0.000025 です。入力と出力を合計すると、OpenRouter より安く、モデルは 380K のコンテキストを保持し、最大 32,768 トークンまで回答します。
以下の表は、同じリクエストをすべてのモデルで 1,000 回実行した場合を示しています。
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
リクエストあたり 300 入力トークンと 200 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
価格は価格ページにあります。
モデルの切り替え#
モデルが変わってもコードは変わりません。変わるのは "model" の文字列だけです。例えば、zai- は 390K のコンテキストを持ち、最大 8,192 トークンまで回答します。コードを一切編集しないようにするには、std::env::var("CHEAPTOKENS_ で 2 つ目の変数から ID を読み取ります。あなたのキーがどの ID を見られるかわからない場合は、GET /v1/models でモデルを一覧表示してください。
うまくいかない場合#
- 最初に
environment variable not foundが出る: キーがこのターミナルでエクスポートされていません。cargo runを実行する同じウィンドウで再度エクスポートしてください。 - API から 401 エラー: キーが間違っているか、余分なスペースや引用符が付いています。
- 404 エラー: ベース URL が
/v1で終わっていること、モデル ID がdeepseek-ai/プレフィックス付きの完全なものであることを確認してください。API 401 または 404: キー、ベース URL、モデル IDで順を追って説明しています。 - コンパイラが
create_byotを見つけられない:byotフィーチャーが有効になっていません。セットアップのcargo add行をもう一度実行してください。
これらに当てはまらない接続問題については、一般的な接続エラーをご覧ください。
同じ最初のリクエストは他の言語にもあります: Go と Ruby です。API 自体の詳細については、CheapTokens ドキュメントを開いてください。


