API & SDK가이드
async-openai로 Rust에서 첫 요청: 기본 URL, 키, 사용량
tokio와 async-openai로 CheapTokens에 채팅 완료 요청 하나를 보내고 응답과 토큰 수를 출력하는 작은 Rust 프로그램입니다.
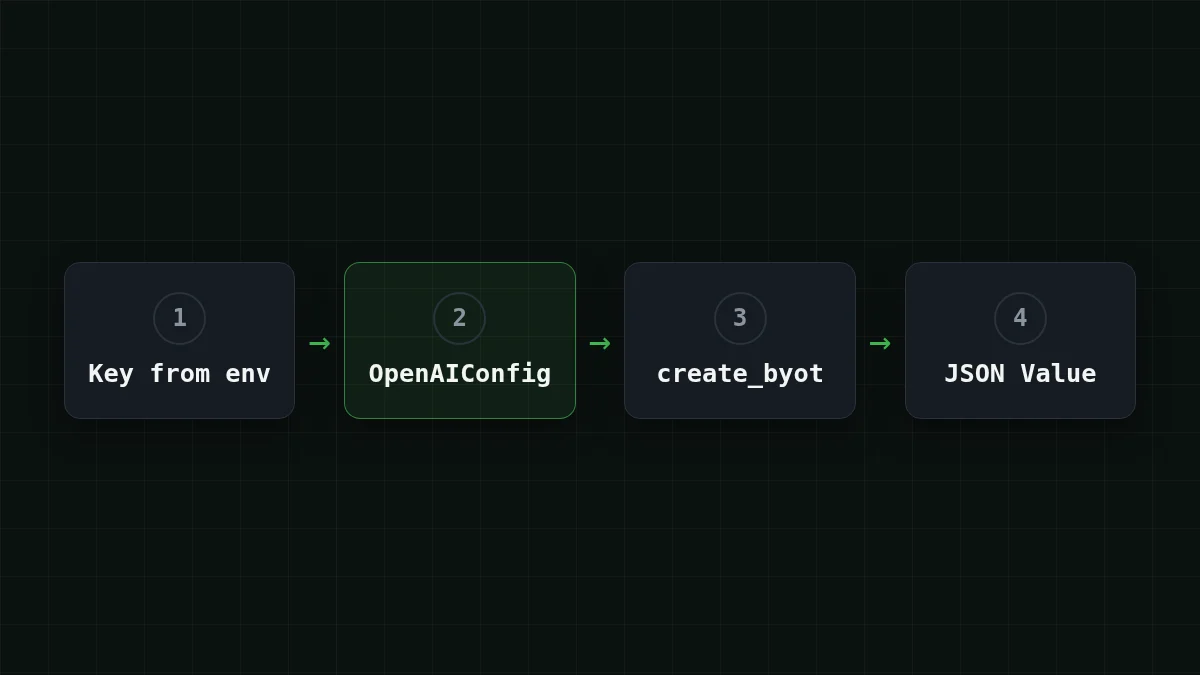
Rust에서 async-openai로 CheapTokens를 호출하려면 기본 URL https:/과 키로 OpenAIConfig를 만들고, create_byot와 JSON 본문으로 요청을 보내면 됩니다. 응답 텍스트와 토큰 수는 돌아온 JSON에서 꺼냅니다. 코드는 약 25줄이며, 문자열 하나만 바꾸면 CheapTokens 모델 페이지의 어떤 모델에서도 같은 프로그램이 동작합니다.
이 크레이트의 docs.rs 페이지(2026년 11월 8일 확인)에는 MIT 라이선스로 버전 0.43.0이 표시되어 있으며, 이 가이드는 그 버전을 따릅니다.
타입 지정 요청 대신 create_byot을 쓰는 이유#
async-openai는 보통 타입이 지정된 요청 빌더를 제공합니다. 구조체를 채우면 구조체를 돌려받죠. 게이트웨이가 구조체가 모르는 필드를 반환하기 전까지는 편리합니다. byot 기능("bring your own types")은 어떤 JSON 본문이든 받아서 역직렬화할 수 있는 어떤 타입이든, 심지어 일반 serde_까지 반환하는 *_byot 메서드를 추가합니다.
첫 요청에는 이것이 딱 맞습니다. curl 호출에 넣을 JSON을 그대로 작성하고, 조회할 타입 없이 응답에서 usage을 바로 읽습니다.
프로젝트 설정#
단계별로
프로젝트를 만들고 키를 설정하세요
크레이트 추가
새 프로젝트(cargo new cheaptokens-)에서 의존성 세 개를 추가합니다. async-openai에는 여기서 두 가지 기능이 필요합니다. create_byot 메서드를 위한 byot과 채팅 섹션을 위한 chat-completion입니다.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
키를 환경 변수에 넣기
CheapTokens 계정에서 키를 만들고 소스 코드 밖에 보관하세요. 자세한 내용은 API 키를 안전하게 저장하는 방법을 참고하세요.
export CHEAPTOKENS_API_KEY="paste-your-key-here"Windows PowerShell에서는 같은 줄이 $env:CHEAPTOKENS_입니다.
프로그램 실행
다음 섹션의 코드를 src/main.rs에 붙여넣고 실행하세요.
cargo run프로그램#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
세 줄이 핵심을 담고 있습니다. with_api_base는 CheapTokens가 들어가는 곳입니다. 기본 URL은 /v1로 끝나고, async-openai가 엔드포인트 경로를 스스로 추가합니다. with_api_key는 환경에서 읽은 값을 받습니다. 그리고 model는 전체 id deepseek-입니다. 가격표의 짧은 이름은 API가 받지 않습니다.
Value을 없는 키로 인덱싱하면 패닉 대신 null이 나오므로, 필드 이름의 오타는 크래시가 아니라 출력의 null로 나타납니다. 응답을 탐색할 때 유용합니다.
돌아오는 응답#
게이트웨이는 OpenAI Chat Completions 형식을 사용하므로 응답은 일반적인 모양입니다(여기서는 잘라냈으며, ...은 생략한 필드를 표시합니다):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}usage의 숫자는 요청에 대한 실제 카운트이므로 실행하면 0을 대체합니다. prompt_tokens는 보낸 내용이고 completion_는 모델이 쓴 내용입니다. 둘은 서로 다른 가격으로 청구되며, 이것이 이들을 출력하는 이유입니다. 차이가 낯설다면 입력 vs 출력 토큰이 5분 만에 설명해 줍니다.
직접 해보기해 보세요: "max_tokens"를 5로 설정하고 다시 실행하세요. finish_reason은 무엇이라고 나오나요?정답 보기
OpenAI Chat Completions 형식에서는 length이라고 나옵니다. 모델이 상한에 걸려 문장이 중간에 잘린 것입니다. 정상적인 답변에서는 stop이라고 나옵니다. 실제 작업에서 length이 보이면 max_tokens을 올리세요. 이 글에서 해결 방법을 다룹니다.
요청 한 번의 비용#
이 호출을 루프에서 실행한다고 가정해 봅시다. 작은 질문이 들어가고 짧은 답변이 나오며, 매번 입력 300 토큰, 출력 200 토큰입니다. DeepSeek-V4-Flash에서는 1M 입력 토큰당 $0.015, 1M 출력 토큰당 $0.10의 실시간 가격 기준으로 요청당 $0.000025입니다. 입력과 출력을 합쳐 계산하면 OpenRouter보다 저렴하며, 모델은 380K 컨텍스트를 유지하고 최대 32,768 토큰까지 답합니다.
아래 표는 같은 요청을 모든 모델에서 1,000번 곱한 값입니다.
| 모델 | 입력 $/1M | 출력 $/1M | 요청당 | 1,000회 요청 | OpenRouter, 1,000회 요청 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
요청당 입력 300개 및 출력 200개 토큰입니다. 100만 토큰당 가격은 현재 기준이며 당사 요금제에 따라 함께 변경됩니다. OpenRouter 열은 동일한 작업량에 대한 참고 가격을 보여줍니다.
가격은 가격 페이지에 있습니다.
모델 전환#
모델이 바뀌어도 코드는 바뀌지 않습니다. "model"의 문자열만 바뀝니다. 예를 들어 zai-은 390K 컨텍스트를 가지며 최대 8,192 토큰까지 답합니다. 코드를 아예 수정하지 않으려면 std::env::var("CHEAPTOKENS_로 두 번째 변수에서 id를 읽으세요. 키가 어떤 id를 보는지 확실하지 않다면 GET /v1/models로 모델 목록 조회를 하세요.
동작하지 않을 때#
- 맨 처음에
environment variable not found: 이 터미널에서 키를 export하지 않았습니다.cargo run를 실행하는 같은 창에서 다시 export하세요. - API에서 401 오류: 키가 잘못되었거나 주변에 공백이나 따옴표가 붙어 있습니다.
- 404 오류: 기본 URL이
/v1로 끝나는지, 모델 id가deepseek-ai/접두사가 붙은 전체 id인지 확인하세요. API 401 또는 404: 키, 기본 URL, 모델 id에서 단계별로 설명합니다. - 컴파일러가
create_byot을 찾지 못함:byot기능이 활성화되지 않았습니다. 설정의cargo add줄을 다시 실행하세요.
위에 해당하지 않는 연결 문제라면 일반적인 연결 오류를 참고하세요.
같은 첫 요청이 다른 언어에도 있습니다: Go와 Ruby입니다. API 자체에 대한 자세한 내용은 CheapTokens 문서를 여세요.


