API at SDKGabay
Unang request sa Rust gamit ang async-openai: base URL, key, usage
Isang maliit na Rust program na may tokio at async-openai na nagpapadala ng isang chat completion sa CheapTokens at nagpi-print ng reply at mga token count.
Sa pahinang ito
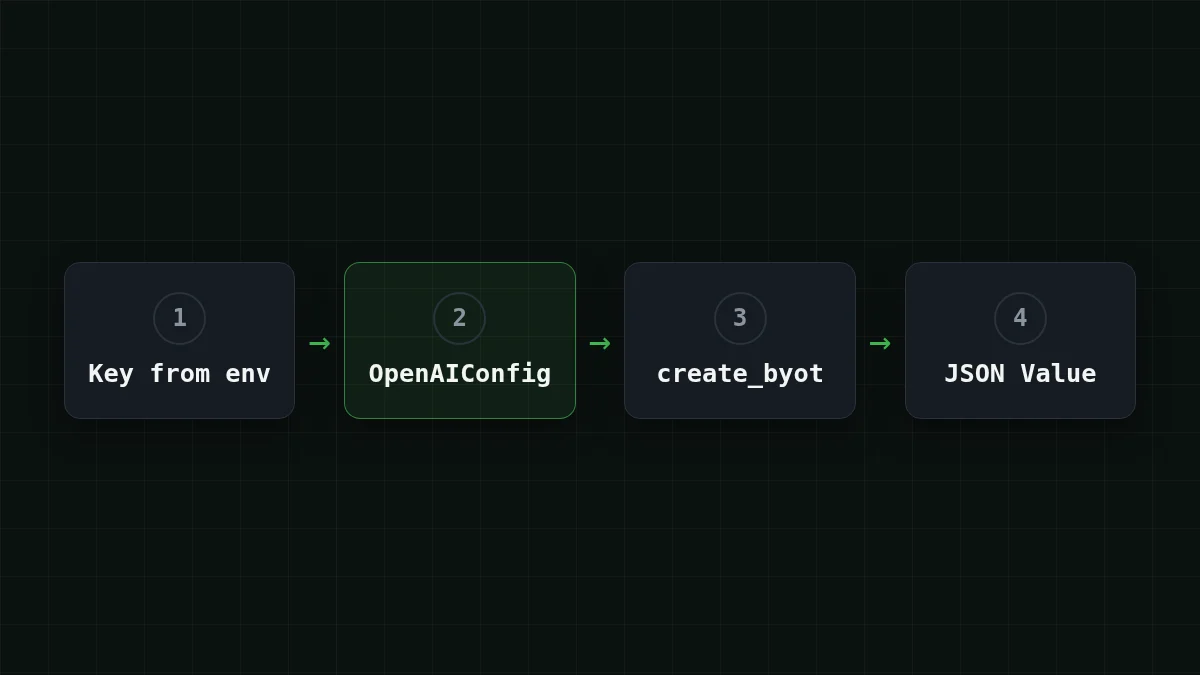
Para tumawag sa CheapTokens mula sa Rust gamit ang async-openai, bumuo ng OpenAIConfig gamit ang base URL na https:/ at ang iyong key, pagkatapos ipadala ang request gamit ang create_byot at isang JSON body. Ang text ng reply at ang mga token count ay lumalabas mula sa JSON na bumabalik. Mga 25 linya lang ng code iyon, at gumagana ang parehong programa para sa kahit anong modelo sa pahina ng mga modelo ng CheapTokens kapag binago mo ang isang string.
Ang docs.rs page ng crate (sinuri noong 8 Nobyembre 2026) ay naglilista ng bersyon 0.43.0 sa ilalim ng MIT license, at iyon ang bersyong sinusundan ng gabay na ito.
Bakit create_byot sa halip na mga typed request#
Karaniwang nagbibigay ang async-openai ng typed request builder: pinupuno mo ang isang struct, ibinabalik nito ang isang struct. Komportable iyon hanggang sa magbalik ang isang gateway ng field na hindi alam ng mga struct. Ang byot feature ("bring your own types") ay nagdadagdag ng mga *_byot method na tumatanggap ng kahit anong JSON body at nagbabalik ng kahit anong type na maaari mong i-deserialize, kasama na ang plain serde_.
Para sa unang request, iyon talaga ang kailangan mo. Isusulat mo ang parehong JSON na ilalagay mo sa isang curl call, at babasahin mo ang usage diretso mula sa response, na walang type na hahanapin.
I-set up ang proyekto#
Hakbang-hakbang
Gumawa ng proyekto at itakda ang key
Idagdag ang mga crate
Sa isang bagong proyekto (cargo new cheaptokens-), magdagdag ng tatlong dependency. Kailangan ng async-openai ng dalawang feature dito: byot para sa mga create_byot method at chat-completion para sa chat section.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Ilagay ang key sa isang environment variable
Gumawa ng key sa iyong CheapTokens account at ilayo ito sa source code. Kung gusto mo ang mahabang bersyon, tingnan ang paano mag-imbak ng API key nang ligtas.
export CHEAPTOKENS_API_KEY="paste-your-key-here"Sa Windows PowerShell, ang parehong linya ay $env:CHEAPTOKENS_.
Patakbuhin ang programa
I-paste ang code mula sa susunod na seksyon sa src/main.rs at simulan ito.
cargo runAng programa#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Tatlong linya ang nagdadala ng buong ideya. Ang with_api_base ang pinapasok ng CheapTokens: nagtatapos ang base URL sa /v1, at ang async-openai mismo ang nagdadagdag ng endpoint path. Kinukuha ng with_api_key ang value na binasa namin mula sa environment. At ang model ay ang buong id na deepseek- — hindi tinatanggap ng API ang mga maiikling pangalan mula sa mga price table.
Ang pag-index ng Value na kulang ang key ay nagbibigay ng null sa halip na panic, kaya ang typo sa pangalan ng field ay lumalabas bilang null sa output sa halip na crash. Kapaki-pakinabang iyon kapag nag-e-explore ka ng response.
Ano ang bumabalik#
Nagsasalita ang gateway ng OpenAI Chat Completions format, kaya ang response ay may karaniwang hugis (pinaikli dito, ang ... ay nagmamarka ng mga field na nilalaktawan namin):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
Ang mga numero sa usage ay totoong count para sa iyong request, kaya pinapalitan nila ang mga zero kapag pinatakbo mo ito. Ang prompt_tokens ay ang ipinadala mo, ang completion_ ay ang isinulat ng modelo. Magkaiba ang presyo ng singil sa kanila, at iyon ang dahilan ng pag-print sa kanila. Kung bago sa iyo ang pagkakaiba, ipinapaliwanag ng input vs output tokens iyon sa limang minuto.
Subukan mo mismoSubukan ito: itakda ang "max_tokens" sa 5 at patakbuhin muli. Ano ang sinasabi ng finish_reason?Ipakita ang sagot
Sa OpenAI Chat Completions format, sinasabi nitong length. Naabot ng modelo ang iyong cap at naputol ang pangungusap sa gitna. Sa normal na sagot, sinasabi nitong stop. Kung makakita ka ng length sa isang totoong trabaho, taasan ang max_tokens — tinatalakay ng artikulong ito ang solusyon.
Magkano ang isang request#
Sabihin nating pinapatakbo mo ang call na ito sa isang loop, maliit na tanong ang papasok at maikling sagot ang lalabas: 300 input tokens at 200 output tokens bawat isa. Sa DeepSeek-V4-Flash, iyon ay $0.000025 bawat request, mula sa live na presyo na $0.015 kada 1M input tokens at $0.10 kada 1M output tokens. Kung pagsasamahin, input at output, mas mura iyon kaysa OpenRouter, at pinapanatili ng modelo ang 380K context at sumasagot ng hanggang 32,768 tokens.
Ipinapakita ng talahanayan sa ibaba ang parehong request sa bawat modelo, pinarami ng 1,000.
| Modelo | Input $/1M | Output $/1M | Bawat kahilingan | 1,000 mga kahilingan | OpenRouter, 1,000 mga kahilingan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 input at 200 output na token bawat kahilingan. Ang mga presyo kada 1M token ay kasalukuyan at nagbabago kasabay ng aming mga taripa; ang column ng OpenRouter ay nagpapakita ng reference na presyo para sa parehong workload.
Nasa pricing page ang mga presyo.
Pagpapalit ng modelo#
Hindi nagbabago ang code kapag nagbago ang modelo; ang string lang sa "model" ang nagbabago. Halimbawa, ang zai- ay may 390K context at sumasagot ng hanggang 8,192 tokens. Para hindi na mag-edit ng code, basahin ang id mula sa pangalawang variable gamit ang std::env::var("CHEAPTOKENS_. Kung hindi ka sigurado kung aling mga id ang nakikita ng iyong key, ilista ang mga modelo gamit ang GET /v1/models.
Kung hindi ito gumana#
environment variable not foundsa pinakasimula: hindi naka-export ang key sa terminal na ito. I-export itong muli sa parehong window kung saan mo pinapatakbo angcargo run.- Isang 401 error mula sa API: mali ang key o may sumamang space o quote sa paligid nito.
- Isang 404 error: tiyakin na nagtatapos ang base URL sa
/v1at ang model id ay ang buo, kasama angdeepseek-ai/prefix. Dinadaanan ng API 401 o 404: key, base URL, model id iyon. - Hindi mahanap ng compiler ang
create_byot: hindi naka-enable angbyotfeature. Patakbuhin muli angcargo addlinya mula sa setup.
Para sa problema sa koneksyon na wala sa mga iyon, tingnan ang mga karaniwang error sa koneksyon.
May parehong unang request para sa ibang mga wika: Go at Ruby. Para sa higit pa tungkol sa API mismo, buksan ang mga doc ng CheapTokens.


