API та SDKПосібник
Перший запит у Rust з async-openai: базова URL-адреса, ключ, використання
Невелика програма на Rust з tokio та async-openai, яка надсилає одне чат-завершення до CheapTokens і виводить відповідь та кількість токенів.
На цій сторінці
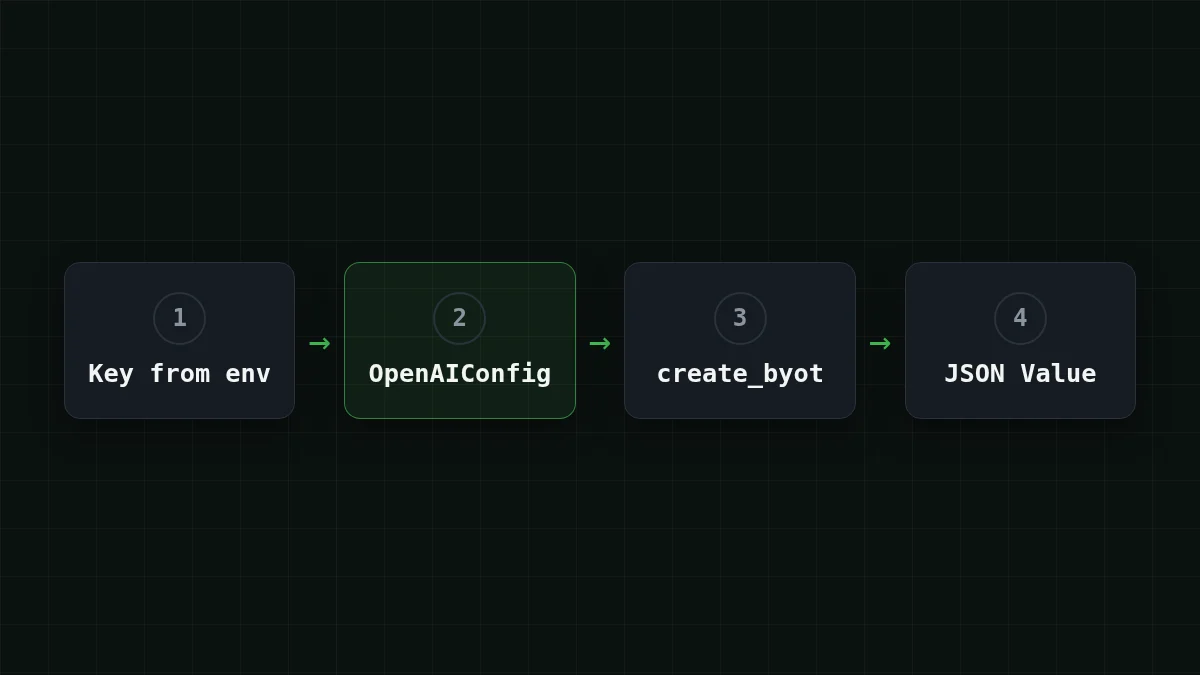
Щоб викликати CheapTokens із Rust через async-openai, створіть OpenAIConfig з базовою URL-адресою https:/ і своїм ключем, а потім надішліть запит за допомогою create_byot та JSON-тіла. Текст відповіді та кількість токенів беруться з JSON, що повертається. Це близько 25 рядків коду, і та сама програма працює для будь-якої моделі на сторінці моделей CheapTokens, щойно ви зміните один рядок.
Сторінка docs.rs цього крейта (перевірено 8 листопада 2026 року) вказує версію 0.43.0 під ліцензією MIT, і саме цієї версії дотримується цей посібник.
Чому create_byot замість типізованих запитів#
async-openai зазвичай надає типізований конструктор запитів: ви заповнюєте структуру, і він повертає структуру. Це зручно, доки шлюз не поверне поле, якого структури не знають. Функція byot ("bring your own types") додає методи *_byot, які приймають будь-яке JSON-тіло і повертають будь-який тип, у який ви можете десеріалізувати, включно з простим serde_.
Для першого запиту це саме те, що потрібно. Ви пишете той самий JSON, який вставили б у виклик curl, і читаєте usage безпосередньо з відповіді, без потреби шукати тип.
Налаштування проєкту#
Крок за кроком
Створіть проєкт і задайте ключ
Додайте крейти
У новому проєкті (cargo new cheaptokens-) додайте три залежності. async-openai потребує тут двох функцій: byot для методів create_byot і chat-completion для розділу чату.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Помістіть ключ у змінну середовища
Створіть ключ у своєму обліковому записі CheapTokens і тримайте його поза вихідним кодом. Якщо хочете довшу версію, дивіться як безпечно зберігати API-ключ.
export CHEAPTOKENS_API_KEY="paste-your-key-here"У Windows PowerShell той самий рядок — $env:CHEAPTOKENS_.
Запустіть програму
Вставте код із наступного розділу в src/main.rs і запустіть його.
cargo runПрограма#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Три рядки містять усю ідею. with_api_base — це місце, куди підставляється CheapTokens: базова URL-адреса закінчується на /v1, а async-openai додає шлях ендпоінта сам. with_api_key бере значення, яке ми прочитали з середовища. А model — це повний ідентифікатор deepseek- — короткі назви з таблиць цін API не приймає.
Індексація Value із відсутнім ключем дає null замість паніки, тож друкарська помилка в назві поля з'являється як null у виводі, а не як збій. Це зручно, коли ви досліджуєте відповідь.
Що повертається#
Шлюз розмовляє форматом OpenAI Chat Completions, тож відповідь має звичайну форму (тут обрізано, позначки ... вказують на поля, які ми пропускаємо):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
Числа в usage — це реальні підрахунки для вашого запиту, тож вони замінюють нулі, коли ви запускаєте програму. prompt_tokens — це те, що ви надіслали, completion_ — те, що написала модель. Вони тарифікуються за різними цінами, і саме в цьому сенс їх виведення. Якщо різниця для вас нова, вхідні vs вихідні токени пояснює це за п'ять хвилин.
Спробуйте саміСпробуйте: встановіть "max_tokens" у 5 і запустіть знову. Що каже finish_reason?Показати відповідь
У форматі OpenAI Chat Completions він каже length. Модель досягла вашого ліміту, і речення обірвано посередині. Із нормальною відповіддю він каже stop. Якщо ви бачите length у реальній роботі, збільште max_tokens — ця стаття описує виправлення.
Скільки коштує один запит#
Скажімо, ви запускаєте цей виклик у циклі, маленьке запитання на вході й коротка відповідь на виході: 300 вхідних токенів і 200 вихідних токенів щоразу. На DeepSeek-V4-Flash це $0.000025 за запит, виходячи з актуальної ціни $0.015 за 1M вхідних токенів і $0.10 за 1M вихідних токенів. Разом, вхідні та вихідні, це дешевше за OpenRouter, а модель зберігає контекст 380K і відповідає до 32 768 токенів.
Таблиця нижче показує той самий запит на кожній моделі, помножений на 1 000.
| Модель | Вхід $/1М | Вихід $/1М | За запит | 1 000 запитів | OpenRouter, 1 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 вхідних і 200 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Ціни живуть на сторінці цін.
Перемикання моделі#
Код не змінюється, коли змінюється модель; змінюється лише рядок у "model". Наприклад, zai- має контекст 390K і відповідає до 8 192 токенів. Щоб взагалі не редагувати код, читайте ідентифікатор із другої змінної за допомогою std::env::var("CHEAPTOKENS_. Якщо ви не впевнені, які ідентифікатори бачить ваш ключ, перелічіть моделі через GET /v1/models.
Якщо не працює#
environment variable not foundодразу на початку: ключ не експортовано в цьому терміналі. Експортуйте його знову в тому самому вікні, де ви запускаєтеcargo run.- Помилка 401 від API: ключ неправильний або має зайвий пробіл чи лапку навколо.
- Помилка 404: перевірте, що базова URL-адреса закінчується на
/v1і що ідентифікатор моделі повний, із префіксомdeepseek-ai/. API 401 або 404: ключ, базова URL-адреса, ідентифікатор моделі проводить через це. - Компілятор не може знайти
create_byot: функціяbyotне ввімкнена. Запустіть рядокcargo addз налаштування знову.
Для проблеми зі з'єднанням, яка не є жодною з цих, дивіться поширені помилки з'єднання.
Той самий перший запит існує для інших мов: Go і Ruby. Щоб дізнатися більше про сам API, відкрийте документацію CheapTokens.


