API & SDKAnleitung
Erste Anfrage in Rust mit async-openai: Basis-URL, Key, Usage
Ein kleines Rust-Programm mit tokio und async-openai, das eine Chat-Completion an CheapTokens sendet und die Antwort sowie die Token-Zahlen ausgibt.
Auf dieser Seite
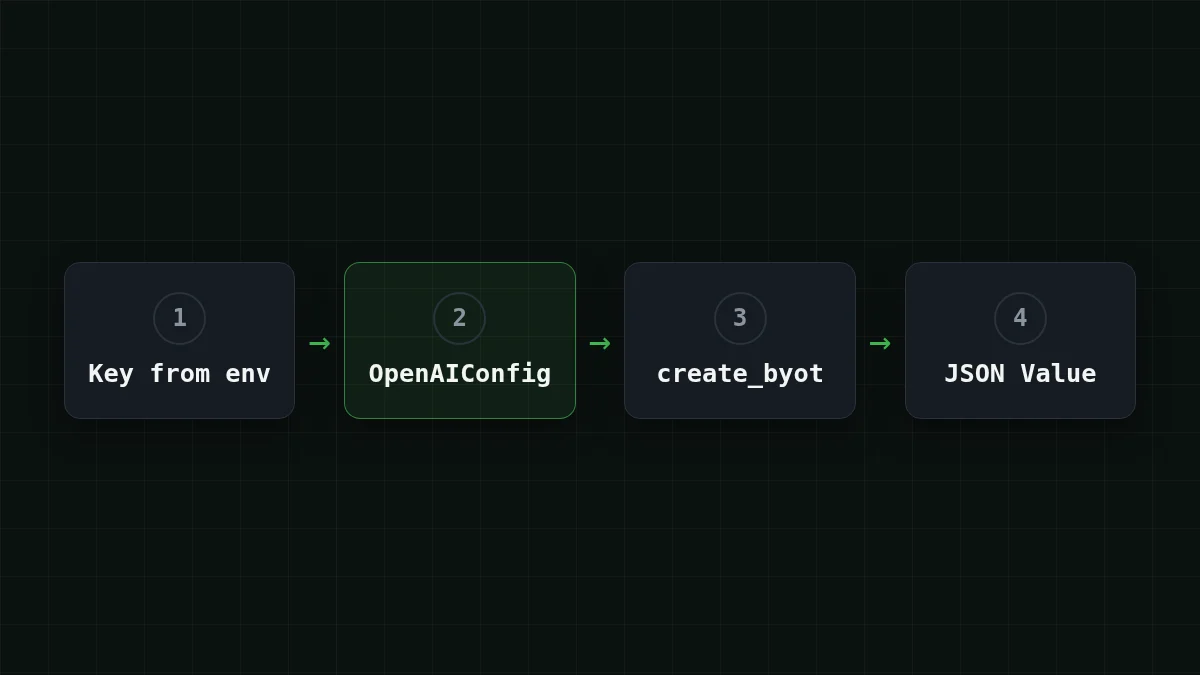
Um CheapTokens aus Rust mit async-openai aufzurufen, baust du einen OpenAIConfig mit der Basis-URL https:/ und deinem Key und sendest dann die Anfrage mit create_byot und einem JSON-Body. Der Antworttext und die Token-Zahlen kommen aus dem zurückgegebenen JSON. Das sind etwa 25 Zeilen Code, und dasselbe Programm funktioniert für jedes Modell auf der CheapTokens-Modellseite, sobald du einen String änderst.
Die docs.rs-Seite des Crates (geprüft am 8. November 2026) listet Version 0.43.0 unter der MIT-Lizenz, und dieser Version folgt diese Anleitung.
Warum create_byot statt typisierter Anfragen#
async-openai gibt dir normalerweise einen typisierten Request-Builder: Du füllst eine Struct, und du bekommst eine Struct zurück. Das ist bequem, bis ein Gateway ein Feld zurückgibt, das die Structs nicht kennen. Das Feature byot ("bring your own types") fügt *_byot-Methoden hinzu, die jeden JSON-Body annehmen und jeden Typ zurückgeben, in den du deserialisieren kannst, einschließlich eines einfachen serde_.
Für eine erste Anfrage ist das genau das Richtige. Du schreibst dasselbe JSON, das du in einen curl-Aufruf packen würdest, und liest usage direkt aus der Antwort, ohne einen Typ nachschlagen zu müssen.
Projekt einrichten#
Schritt für Schritt
Erstelle das Projekt und setze den Key
Die Crates hinzufügen
In einem frischen Projekt (cargo new cheaptokens-) fügst du drei Abhängigkeiten hinzu. async-openai braucht hier zwei Features: byot für die create_byot-Methoden und chat-completion für den Chat-Bereich.
cargo add async-openai --features byot,chat-completion
cargo add tokio --features macros,rt-multi-thread
cargo add serde_json
Den Key in eine Umgebungsvariable legen
Erstelle den Key in deinem CheapTokens-Konto und halte ihn aus dem Quellcode heraus. Wenn du die lange Version willst, siehe wie man einen API-Key sicher speichert.
export CHEAPTOKENS_API_KEY="paste-your-key-here"Unter Windows PowerShell lautet dieselbe Zeile $env:CHEAPTOKENS_.
Das Programm ausführen
Füge den Code aus dem nächsten Abschnitt in src/main.rs ein und starte es.
cargo runDas Programm#
use async_openai::{config::OpenAIConfig, Client};
use serde_json::{json, Value};

#[tokio::main]
async fn main() -> Result<(), Box<dyn std::error::Error>> {
    let key = std::env::var("CHEAPTOKENS_API_KEY")?;

    let config = OpenAIConfig::new()
        .with_api_key(key)
        .with_api_base("https://api.cheaptokens.dev/v1");
    let client = Client::with_config(config);

    let response: Value = client
        .chat()
        .create_byot(json!({
            "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
            "messages": [
                {"role": "user", "content": "Explain what a token is in one sentence."}
            ],
            "max_tokens": 100
        }))
        .await?;

    let choice = &response["choices"][0];
    println!("{}", choice["message"]["content"].as_str().unwrap_or("(no text)"));
    println!("finish_reason: {}", choice["finish_reason"]);
    println!("input tokens:  {}", response["usage"]["prompt_tokens"]);
    println!("output tokens: {}", response["usage"]["completion_tokens"]);
    Ok(())
}
Drei Zeilen tragen die ganze Idee. with_api_base ist der Punkt, an dem CheapTokens ins Spiel kommt: Die Basis-URL endet auf /v1, und async-openai fügt den Endpoint-Pfad selbst hinzu. with_api_key nimmt den Wert, den wir aus der Umgebung gelesen haben. Und model ist die vollständige ID deepseek- — die Kurznamen aus den Preistabellen werden von der API nicht akzeptiert.
Das Indizieren eines Value mit einem fehlenden Key liefert null statt eines Panics, sodass ein Tippfehler in einem Feldnamen als null in der Ausgabe auftaucht statt als Absturz. Das ist praktisch, wenn du eine Antwort erkundest.
Was zurückkommt#
Das Gateway spricht das OpenAI-Chat-Completions-Format, also hat die Antwort die übliche Form (hier gekürzt, die ... markieren Felder, die wir überspringen):
{
  "choices": [
    { "message": { "role": "assistant", "content": "..." }, "finish_reason": "stop" }
  ],
  "usage": { "prompt_tokens": 0, "completion_tokens": 0 }
}
Die Zahlen in usage sind echte Zählungen für deine Anfrage, sie ersetzen also die Nullen, wenn du das Programm ausführst. prompt_tokens ist das, was du gesendet hast, completion_ ist das, was das Modell geschrieben hat. Sie werden zu unterschiedlichen Preisen abgerechnet, und genau deshalb werden sie ausgegeben. Wenn dir der Unterschied neu ist, erklärt Input vs. Output Tokens ihn in fünf Minuten.
Probier es selbstProbier es aus: Setze "max_tokens" auf 5 und führe es erneut aus. Was sagt finish_reason?Antwort anzeigen
Im OpenAI-Chat-Completions-Format sagt es length. Das Modell hat dein Limit erreicht und der Satz ist mittendrin abgeschnitten. Bei einer normalen Antwort sagt es stop. Wenn du length in einem echten Job siehst, erhöhe max_tokens — dieser Artikel behandelt die Lösung.
Was eine Anfrage kostet#
Angenommen, du führst diesen Aufruf in einer Schleife aus, eine kleine Frage rein und eine kurze Antwort raus: 300 Input-Tokens und 200 Output-Tokens jeweils. Bei DeepSeek-V4-Flash sind das $0.000025 pro Anfrage, aus dem Live-Preis von $0.015 pro 1M Input-Tokens und $0.10 pro 1M Output-Tokens. Zusammengerechnet, Input und Output, ist das günstiger als OpenRouter, und das Modell behält einen 380K-Kontext und antwortet mit bis zu 32.768 Tokens.
Die folgende Tabelle zeigt dieselbe Anfrage auf jedem Modell, mal 1.000.
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000014 | $0.014 | $0.0267 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000025 | $0.0245 | $0.049 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000045 | $0.045 | $0.54 |
300 Input- und 200 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Die Preise stehen auf der Preisseite.
Das Modell wechseln#
Der Code ändert sich nicht, wenn das Modell sich ändert; nur der String in "model" ändert sich. Zum Beispiel hat zai- einen 390K-Kontext und antwortet mit bis zu 8.192 Tokens. Um Code-Änderungen ganz zu vermeiden, lies die ID aus einer zweiten Variable mit std::env::var("CHEAPTOKENS_. Wenn du nicht sicher bist, welche IDs dein Key sieht, liste die Modelle mit GET /v1/models auf.
Wenn es nicht funktioniert#
environment variable not foundganz am Anfang: Der Key ist in diesem Terminal nicht exportiert. Exportiere ihn erneut im selben Fenster, in dem ducargo runausführst.- Ein 401-Fehler von der API: Der Key ist falsch oder hat ein überflüssiges Leerzeichen oder Anführungszeichen drumherum.
- Ein 404-Fehler: Prüfe, dass die Basis-URL auf
/v1endet und dass die Modell-ID die vollständige ist, mit dem Präfixdeepseek-ai/. API 401 oder 404: Key, Basis-URL, Modell-ID führt dich durch. - Der Compiler findet
create_byotnicht: Das Featurebyotist nicht aktiviert. Führe die Zeilecargo addaus dem Setup erneut aus.
Bei einem Verbindungsproblem, das keines davon ist, siehe die häufigen Verbindungsfehler.
Dieselbe erste Anfrage gibt es für andere Sprachen: Go und Ruby. Mehr zur API selbst findest du in der CheapTokens-Dokumentation.


