API & SDKAnleitung
Erste Anfrage in Ruby mit dem openai-Gem: base_url, Key, Usage
Ein kurzes Ruby-Skript: das offizielle openai-Gem, eine eigene base_url und ein Key aus der Umgebung. Gibt den Antworttext und die Token-Nutzung aus.
Auf dieser Seite
Ja, das offizielle openai-Gem funktioniert mit CheapTokens: Übergib base_ und deinen Key an OpenAI::Client., rufe client. auf und lies den Text aus choices.. Der Rest dieser Seite ist das vollständige Skript, wie du liest, was zurückkommt, und was du prüfst, wenn es nicht läuft.
Angenommen, du hast eine Rake-Task, die Support-Tickets labelt, oder einen Background-Job, der eine Notiz zusammenfasst, bevor er sie speichert. Du willst das offizielle SDK, kein handgeschriebenes HTTP, und du willst sehen, wie viele Tokens jeder Aufruf verbraucht hat. Genau das ist dieses Skript.
Was du vor dem Start brauchst#
Die Gem-Seite auf RubyGems (geprüft am 8. November 2026) listet openai 0.120.0, veröffentlicht am 5. November 2026, Apache-2.0. Es benötigt Ruby 3.3.0 oder neuer; wenn du auf Ruby 3.2 feststeckst, verweisen die Hinweise des Gems selbst auf die 0.75.x-Linie. Das Paket ist noch 0.x und bewegt sich schnell, also pinne die Version.
In deiner Gemfile:
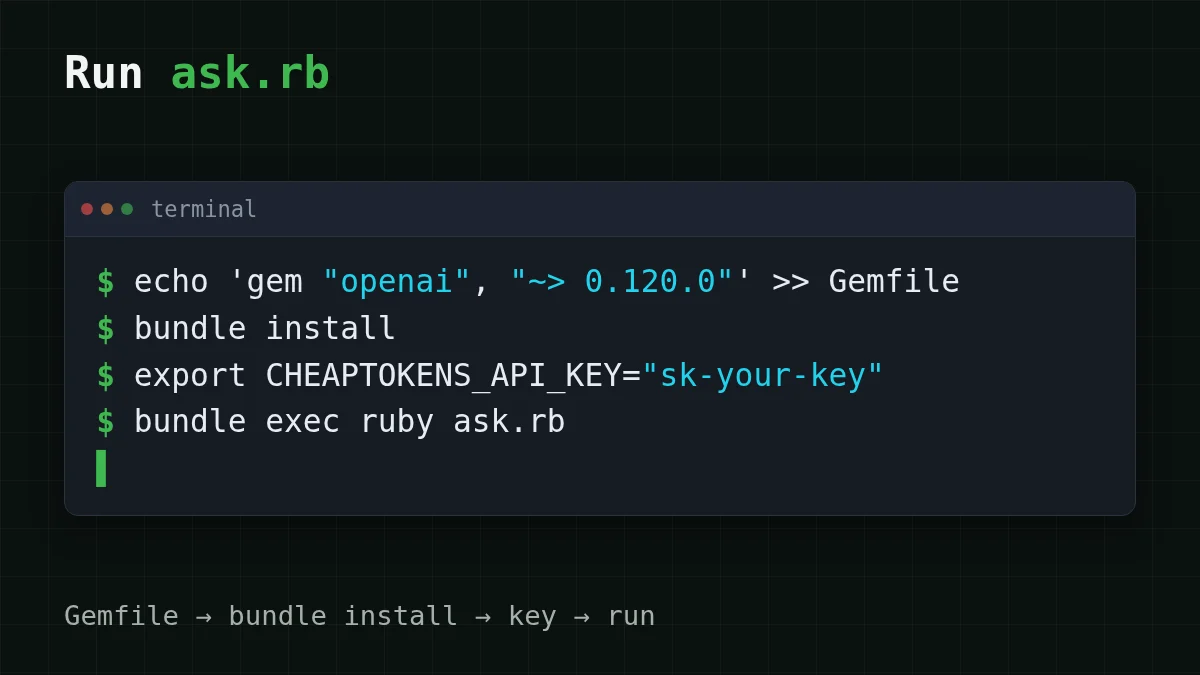
gem "openai", "~> 0.120.0"Dann bundle install. Ohne Bundler macht gem install openai - dasselbe.
Du brauchst außerdem einen API-Key aus deinem CheapTokens-Konto. Halte ihn aus dem Code heraus: Pack ihn in eine Umgebungsvariable, und falls das Wort .gitignore neu für dich ist, ist diese Anleitung zum sicheren Umgang mit Keys eine Lektüre von fünf Minuten.
export CHEAPTOKENS_API_KEY="sk-your-key"Das Skript#
Erstelle ask.rb:
require "openai"

client = OpenAI::Client.new(
  api_key: ENV.fetch("CHEAPTOKENS_API_KEY"),
  base_url: "https://api.cheaptokens.dev/v1"
)

completion = client.chat.completions.create(
  model: "deepseek-ai/DeepSeek-V4-Flash-0731",
  messages: [
    { role: "user", content: "Explain in one sentence what a token is." }
  ]
)

choice = completion.choices.first
puts choice.message.content
puts "finish_reason: #{choice.finish_reason}"
puts completion.usage
Führe es mit ruby ask.rb aus. Drei Dinge lohnen einen zweiten Blick.
ENV.fetch statt ENV[...]. Wenn die Variable fehlt, bricht fetch sofort mit einem KeyError ab, das sie benennt. ENV[...] übergibt stillschweigend nil, und du bekommst ein paar Zeilen später einen verwirrenden Authentifizierungsfehler.
base_url: ist die einzige Zeile, die sich von den OpenAI-Beispielen im README des Gems unterscheidet. Alles andere ist derselbe Code, und genau das ist der Sinn einer OpenAI-kompatiblen API. Falls die Idee neu ist, erklärt was base_url ist und wie man wechselt es mit einem Restaurant-Vergleich.
Die Model-ID ist die vollständige, deepseek-. Der Kurzname aus einer Preistabelle wird von der API nicht akzeptiert; nimm IDs aus der CheapTokens-Doku oder aus GET /v1/models.
Lesen, was zurückkommt#
Die Antwort ist ein Objekt, kein Hash, also rufst du Methoden darauf auf. Der Text liegt unter completion.; das ist auch der Pfad, den das README des Gems verwendet.
Zwei weitere Zeilen lohnen sich ab dem ersten Tag:
finish_reasonsagt dir, warum das Modell gestoppt hat.stopist ein normales Ende.lengthbedeutet, dass ein Längenlimit die Antwort abgeschnitten hat. Falls du das je siehst, warum Antworten abgeschnitten werden und wie man das behebt.usageenthält die Tokens, für die der Aufruf abgerechnet wurde: was du gesendet hast und was das Modell geschrieben hat. Das Skript gibt das ganze Objekt mitputs completion.aus, sodass du beide Zahlen so siehst, wie die API sie zurückgegeben hat.usage
Warum sie loggen? Weil Tokens die Rechnung sind. Eine Frage mit einem Satz und eine Antwort mit einem Satz sind winzig, aber ein Job, der tausendmal am Tag läuft, ist es nicht. Input vs Output Tokens erklärt, warum die zweite Zahl pro Token meist mehr kostet.
Was ein solcher Aufruf kostet#
DeepSeek-V4-Flash auf CheapTokens kostet $0.015 pro 1M Input-Tokens und $0.10 pro 1M Output-Tokens, zum gleichen Preis zu jeder Tageszeit. Nimm einen Ticket-Labeling-Job: etwa 300 Tokens rein, 150 Tokens raus pro Ticket. Ein Ticket kostet $0.00002. Tausend Tickets sehen so aus, mit OpenRouters Referenzpreis in der nächsten Spalte:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0225 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.042 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.45 |
300 Input- und 150 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Das Modell nimmt bis zu 380K Tokens Kontext und bis zu 32.768 Tokens in einer Antwort, sodass ein zusammenfassender Job selten an eine Grenze stößt. Wenn du lieber ein zweites Modell mit demselben Skript ausprobieren möchtest, ändere nur den model:-String zu zai- (390K Kontext, bis zu 8.192 Output-Tokens).
Wenn es nicht läuft#
Die meisten Fehler beim ersten Lauf sind eines von fünf Dingen. Wähle das, was zu deinem Bildschirm passt.
Wähle deinen Fall
Was siehst du?
Wähle eine Option, um die Antwort zu sehen
KeyError: key not found: "CHEAPTOKENS_API_KEY"
Die Variable ist in diesem Terminal nicht gesetzt. Führe die export-Zeile erneut aus, oder öffne eine neue Shell und prüfe mit echo $CHEAPTOKENS_.
401 Unauthorized
Der Key ist da, aber falsch: ein verirrtes Leerzeichen oder Anführungszeichen, ein abgeschnittenes Einfügen oder ein alter Key. Kopiere ihn erneut aus deinem Konto.
404 Not Found
Prüfe zuerst die base_url: Sie endet mit /v1 und hat keinen zusätzlichen Pfad danach. Prüfe dann die Model-ID: Es ist die vollständige ID mit dem Präfix deepseek-ai/.
cannot load such file -- openai
Das Gem ist für dieses Ruby nicht installiert. Führe bundle install aus und starte das Skript mit bundle exec ruby ask..
Bundler can't find a version that works
Prüfe ruby -v. Die 0.120.x-Linie benötigt Ruby 3.3.0 oder neuer; auf 3.2 pinne stattdessen die 0.75.x-Linie.
Die 401- und 404-Fälle treten bei jedem SDK auf, nicht nur bei Ruby; API 401 oder 404: falscher Key, falsche base URL oder falsche Model-ID geht sie der Reihe nach durch.
Kurzer Check
Was sagt dir finish_reason "length"?
Antwort anzeigen
Antwort: Die Antwort wurde durch ein Längenlimit abgeschnitten
stop ist ein normales Ende; length bedeutet, dass die Antwort ein Limit erreicht hat, bevor das Modell fertig war.
Wie es weitergeht#
Du hast jetzt die kleinste nützliche Schleife: senden, den Text lesen, die Tokens loggen. Wickle von hier aus den Aufruf in eine Methode und füge die usage-Zahlen zu deinem Logger hinzu. Dasselbe Muster gibt es in anderen Sprachen, falls dein Stack gemischt ist: Go, Java und C#. Die vollständige Liste der Modelle und Preise steht auf der Modellseite, und die API-Referenz findest du in der Doku.


