API & SDKGuide
Première requête en Ruby avec la gem openai : base_url, clé, usage
Un court script Ruby : la gem openai officielle, un base_url personnalisé et une clé depuis l'env. Affiche le texte de la réponse et l'usage des tokens.
Sur cette page
Oui, la gem officielle openai fonctionne avec CheapTokens : passez base_ et votre clé à OpenAI::Client., appelez client., et lisez le texte depuis choices.. Le reste de cette page est le script complet, comment lire ce qui revient, et quoi vérifier quand ça ne tourne pas.
Imaginez une rake task qui étiquette des tickets de support, ou un job en arrière-plan qui résume une note avant de l'enregistrer. Vous voulez le SDK officiel, pas du HTTP fait main, et vous voulez voir combien de tokens chaque appel a consommés. C'est exactement ce script.
Ce qu'il vous faut avant de commencer#
La page de la gem sur RubyGems (vérifiée le 8 novembre 2026) indique openai 0.120.0, publiée le 5 novembre 2026, Apache-2.0. Elle nécessite Ruby 3.3.0 ou plus récent ; si vous êtes bloqué sur Ruby 3.2, les notes de la gem renvoient vers la branche 0.75.x. Le paquet est encore en 0.x et évolue vite, donc épinglez la version.
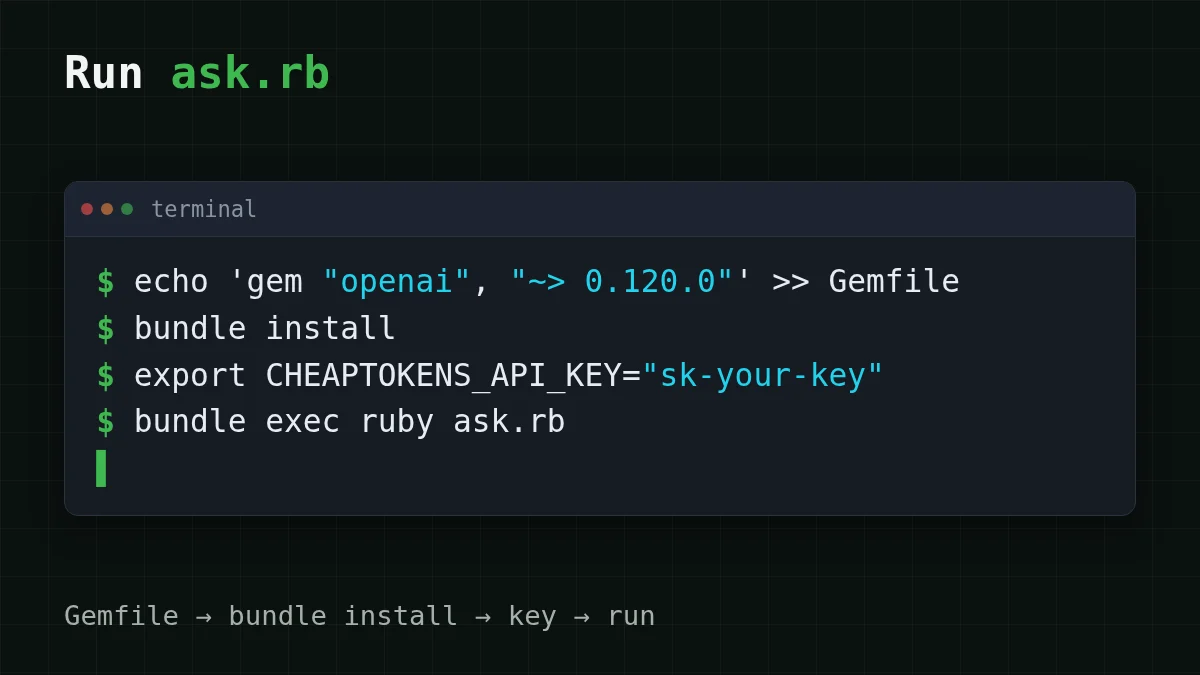
Dans votre Gemfile :
gem "openai", "~> 0.120.0"Puis bundle install. Sans Bundler, gem install openai - fait la même chose.
Il vous faut aussi une clé API depuis votre compte CheapTokens. Gardez-la hors du code : mettez-la dans une variable d'environnement, et si le mot .gitignore vous est nouveau, ce guide pour garder vos clés en sécurité se lit en cinq minutes.
export CHEAPTOKENS_API_KEY="sk-your-key"Le script#
Créez ask.rb :
require "openai"

client = OpenAI::Client.new(
  api_key: ENV.fetch("CHEAPTOKENS_API_KEY"),
  base_url: "https://api.cheaptokens.dev/v1"
)

completion = client.chat.completions.create(
  model: "deepseek-ai/DeepSeek-V4-Flash-0731",
  messages: [
    { role: "user", content: "Explain in one sentence what a token is." }
  ]
)

choice = completion.choices.first
puts choice.message.content
puts "finish_reason: #{choice.finish_reason}"
puts completion.usage
Lancez-le avec ruby ask.rb. Trois choses méritent un second regard.
ENV.fetch au lieu de ENV[...]. Si la variable est absente, fetch s'arrête immédiatement avec une KeyError qui la nomme. ENV[...] passe silencieusement nil et vous obtenez une erreur d'authentification déroutante quelques lignes plus loin.
base_url: est la seule ligne qui diffère des exemples OpenAI du README de la gem. Tout le reste est le même code, ce qui est tout l'intérêt d'une API compatible OpenAI. Si l'idée est nouvelle, ce qu'est base_url et comment basculer l'explique avec une analogie de restaurant.
L'id du modèle est le complet, deepseek-. Le nom court d'un tableau de prix n'est pas accepté par l'API ; prenez les ids dans la documentation CheapTokens ou via GET /v1/models.
Lire ce qui revient#
La réponse est un objet, pas un hash, donc vous appelez des méthodes dessus. Le texte se trouve à completion. ; c'est aussi le chemin utilisé par le README de la gem.
Deux lignes de plus valent la peine d'être affichées dès le premier jour :
finish_reasonvous dit pourquoi le modèle s'est arrêté.stopest une fin normale.lengthsignifie qu'une limite de longueur a coupé la réponse. Si cela vous arrive, pourquoi les réponses sont coupées et comment corriger.usagecontient les tokens facturés pour l'appel : ce que vous avez envoyé et ce que le modèle a écrit. Le script affiche l'objet entier avecputs completion., donc vous voyez les deux nombres tels que l'API les a renvoyés.usage
Pourquoi les journaliser ? Parce que les tokens, c'est la facture. Une question d'une phrase avec une réponse d'une phrase, c'est minuscule, mais un job qui tourne mille fois par jour, non. Tokens d'entrée vs de sortie explique pourquoi le second nombre coûte généralement plus cher par token.
Combien coûte un appel comme celui-ci#
DeepSeek-V4-Flash sur CheapTokens est à $0.015 par 1M de tokens d'entrée et $0.10 par 1M de tokens de sortie, au même prix à toute heure de la journée. Prenons un job d'étiquetage de tickets : environ 300 tokens en entrée, 150 tokens en sortie par ticket. Un ticket coûte $0.00002. Mille tickets donnent ceci, avec le prix de référence d'OpenRouter dans la colonne suivante :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000012 | $0.012 | $0.0225 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00002 | $0.0195 | $0.042 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000038 | $0.0375 | $0.45 |
300 tokens d'entrée et 150 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Le modèle accepte jusqu'à 380K tokens de contexte et jusqu'à 32 768 tokens dans une réponse, donc un job de résumé atteint rarement une limite. Si vous préférez essayer un second modèle avec le même script, changez uniquement la chaîne model: en zai- (390K de contexte, jusqu'à 8 192 tokens de sortie).
Si ça ne tourne pas#
La plupart des échecs au premier lancement relèvent de cinq cas. Choisissez celui qui correspond à votre écran.
Choisissez votre cas
Que voyez-vous ?
Choisissez une option pour voir la réponse
KeyError: key not found: "CHEAPTOKENS_API_KEY"
La variable n'est pas définie dans ce terminal. Relancez la ligne export, ou ouvrez un nouveau shell et vérifiez avec echo $CHEAPTOKENS_.
401 Unauthorized
La clé est là mais fausse : un espace ou un guillemet en trop, un copier-coller tronqué, ou une ancienne clé. Recopiez-la depuis votre compte.
404 Not Found
Vérifiez d'abord le base_url : il se termine par /v1 et n'a pas de chemin supplémentaire après. Vérifiez ensuite l'id du modèle : c'est l'id complet avec le préfixe deepseek-ai/.
cannot load such file -- openai
La gem n'est pas installée pour ce Ruby. Lancez bundle install et démarrez le script avec bundle exec ruby ask..
Bundler can't find a version that works
Vérifiez ruby -v. La branche 0.120.x nécessite Ruby 3.3.0 ou plus récent ; sur 3.2, épinglez plutôt la branche 0.75.x.
Les cas 401 et 404 apparaissent avec tous les SDK, pas seulement Ruby ; API 401 ou 404 : mauvaise clé, base URL ou id de modèle les parcourt dans l'ordre.
Vérification rapide
Que vous dit finish_reason "length" ?
Afficher la réponse
Réponse: La réponse a été coupée par une limite de longueur
stop est une fin normale ; length signifie que la réponse a atteint une limite avant que le modèle ait fini.
Où aller ensuite#
Vous avez maintenant la plus petite boucle utile : envoyer, lire le texte, journaliser les tokens. À partir de là, encapsulez l'appel dans une méthode et ajoutez les nombres usage à votre logger. Le même schéma existe dans d'autres langages si votre stack est mixte : Go, Java et C#. La liste complète des modèles et des prix est sur la page des modèles, et la référence de l'API est dans la documentation.


