API & SDKGuide
Première requête en Go avec openai-go : base URL, clé, usage
Un programme Go complet qui appelle un modèle CheapTokens via openai-go et affiche la réponse, finish_reason et l'usage des tokens, avec retries et timeout.
Sur cette page
Vous avez déjà du code Go qui parle à une API de style OpenAI, ou vous êtes sur le point d'en écrire. Pour l'envoyer à CheapTokens, vous changez deux options sur le client et une chaîne, l'id du modèle. Le SDK reste le même : le package officiel openai-go, v3.
Ci-dessous le programme complet, puis ce que fait chaque ligne, comment lire la réponse et les compteurs de tokens, et comment empêcher une requête bloquée de suspendre votre service. Versions vérifiées par rapport au README d'openai-go le 3 novembre 2026 : le dernier tag sur cette page est v3.91.1, et il nécessite Go 1.26 ou plus récent.
Ce qu'il vous faut avant de commencer#
- Go 1.26 ou plus récent. Sur Go 1.25, épinglez
v3.74.0; sur Go 1.22–1.24, épinglezv3.44.0(le README indique que l'ancienne branche ne reçoit aucune correction garantie). - Une clé API CheapTokens. Gardez-la dans une variable d'environnement, pas dans le fichier source.
- L'adresse de l'API :
https:/. Elle parle le format OpenAI Chat Completions, donc openai-go fonctionne sans wrapper. La documentation contient la même adresse et la page des clés./ api. cheaptokens. dev/ v1 - Un id de modèle. Nous utilisons
deepseek-: 380K de contexte et jusqu'à 32 768 tokens dans une réponse. Utilisez l'id complet ; le nom court des tableaux de prix n'est pas accepté par l'API.ai/ DeepSeek- V4- Flash- 0731
Étape par étape
Configurer le projet
Installer le SDK
Dans un dossier vide :
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Le chemin d'import est github., le nom du package est openai.
Placer la clé dans l'environnement
export CHEAPTOKENS_API_KEY="paste-your-key-here"Sur Windows PowerShell : $env:CHEAPTOKENS_. Le placeholder n'est pas une vraie clé.
Créer main.go et l'exécuter
Collez le programme de la section suivante dans main.go, puis lancez go run ..
Le programme complet#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}
Les éléments qui comptent :
option.est la seule ligne qui fait passer le SDK d'OpenAI à CheapTokens. Utilisez l'adresse exactement comme dans la documentation.WithBaseURL(. . . ) option.passe la clé explicitement. Sans elle, le client litWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, ce qui est pratique quand vous portez du code existant : définissez cette variable sur une clé CheapTokens et le code n'a besoin d'aucun changement de clé. Il en va de même pourOPENAI_BASE_URL, mais unWithBaseURLexplicite le remplace, donc pas de surprise si les deux existent.Modelest une simple chaîne dans le SDK (ChatModelest un alias destring), donc n'importe quel id de modèle fonctionne, pas seulement les constantes montrées dans le README.openai.est un tour utilisateur. L'exemple du README utiliseUserMessage(. . . ) DeveloperMessageet une constante GPT ; ici un message utilisateur et un id sous forme de chaîne suffisent.
Lire la réponse, finish_reason et usage#
Les trois proviennent de champs que le SDK analyse déjà pour vous :
resp.est le texte (unChoices[0]. Message. Content string).resp.est aussi unChoices[0]. FinishReason string.stopsignifie que le modèle a terminé de lui-même ;lengthsignifie que la réponse a atteint la limite de tokens et a été coupée. Si vous voyezlength, lisez pourquoi une réponse s'arrête en milieu de phrase.resp.UsagecontientPromptTokens(ce que vous avez envoyé),CompletionTokens(ce que le modèle a écrit) etTotalTokens, tous desint64.
La sortie ressemblera à ceci : la réponse, puis finish_reason: avec une valeur, puis trois compteurs de tokens. Les chiffres diffèrent à chaque exécution, donc journalisez-les. C'est ce que vous payez, et les tokens de sortie sont le côté le plus cher.
Essayez vous-mêmeEssayez : que change le remplacement du modèle ?Afficher la réponse
Changez la chaîne Model en zai- et relancez. Rien d'autre dans le programme ne bouge. Le texte de la réponse et les trois chiffres d'usage différeront, ce qui est le moyen le plus rapide de comparer deux modèles sur votre propre prompt. GLM-5.3-Flash a un contexte de 390K et jusqu'à 8 192 tokens dans une réponse.
Retries et timeouts : trois limites différentes#
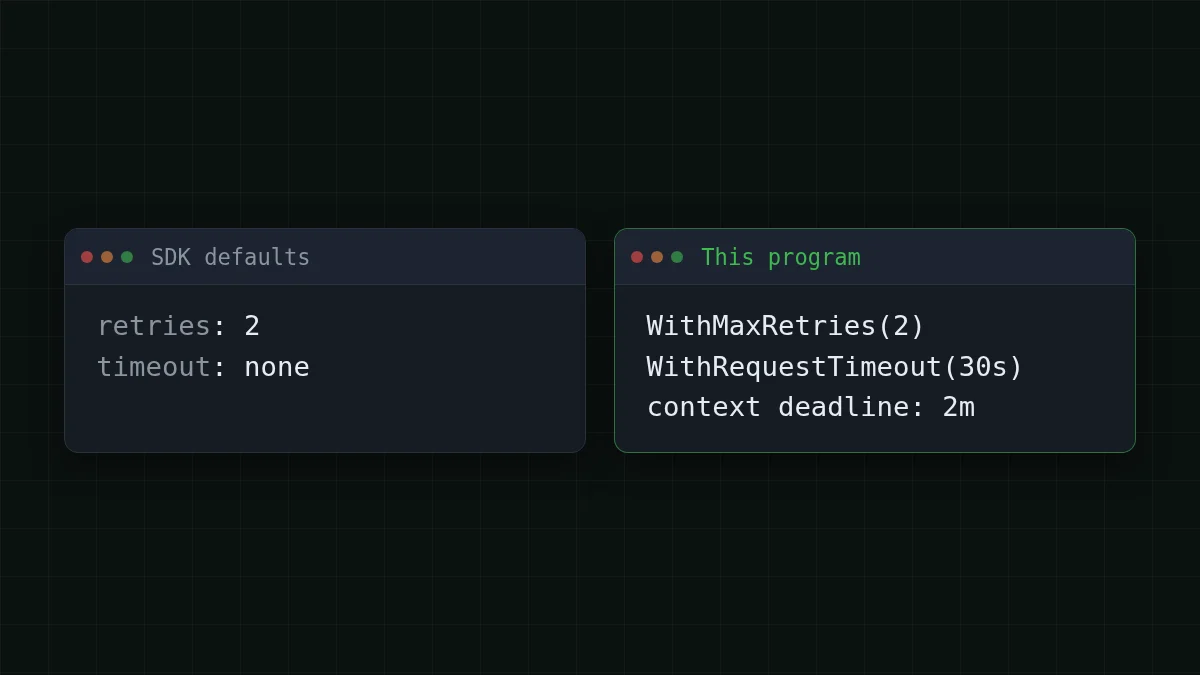
C'est là que les services Go souffrent généralement : par défaut, le SDK n'a aucun timeout, donc une connexion bloquée peut attendre indéfiniment. Trois réglages corrigent cela, et ils agissent à des niveaux différents :
option.: le SDK réessaie les erreurs de connexion, 408, 409, 429 et 5xx avec une courte attente exponentielle. Deux retries est déjà la valeur par défaut ;WithMaxRetries(2) 0désactive les retries. Vous pouvez le définir sur le client, ou sur un appel unique.option.: la limite pour une tentative.WithRequestTimeout(30*time. Second) - La deadline du
context: la limite pour l'appel entier, retries et attentes inclus.
Donc avec 2 retries, il peut y avoir jusqu'à 3 tentatives : 3 × 30 = 90 secondes d'attente au pire, plus les courtes pauses entre les tentatives. Un contexte de deux minutes couvre cela. Si vous voulez une règle stricte de réponse en 20 secondes pour un handler web, raccourcissez le contexte, pas seulement le timeout par tentative.
Pour un contexte plus long sur le choix de ces chiffres, la version Python du même conseil se trouve dans OpenAI Python SDK timeout and retries. La logique se transpose en Go.
Combien coûtent mille de ces appels#
Disons que vous exploitez un petit service qui fait 1 000 requêtes par jour, chacune avec environ 800 tokens d'entrée et 300 tokens de sortie. Sur deepseek-, cette journée coûte $0.042 (1 000 × 800 tokens d'entrée, 1 000 × 300 tokens de sortie). Le tableau montre la même charge sur nos modèles ; compté au total, entrée et sortie ensemble, c'est moins cher qu'OpenRouter.
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 tokens d'entrée et 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Mettez vos propres chiffres. Votre première exécution affiche les vrais PromptTokens et CompletionTokens, donc vous n'avez pas à deviner la moyenne :
Calculateur de coût
Une journée d'un petit service Go
Tokens d'entrée par requête: 800 · Tokens de sortie par requête: 300 · Requêtes par jour: 1 000
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
Les prix sur la page de tarification et la page des modèles sont à jour et utilisent un prix fixe par modèle, sans heures de pointe.
Si ça ne fonctionne pas#
- L'erreur mentionne 401 : la clé est vide ou incorrecte.
os.Getenvrenvoie une chaîne vide pour une variable non définie, donc vérifiezecho $CHEAPTOKENS_dans le même terminal où vous lancezAPI_ KEY go run .. - L'erreur mentionne 404 ou un modèle inconnu : l'id. Copiez-le en entier, avec le préfixe
deepseek-ai/. Vous pouvez lister les ids dans l'appel de liste des modèles. go: module requires Go 1.: votre toolchain est plus ancien. Épinglez un tag SDK plus ancien comme indiqué en haut.26 - L'appel se bloque puis échoue : c'est le timeout qui fait son travail. Vérifiez d'abord le chemin réseau, puis augmentez
WithRequestTimeoutsi le modèle a vraiment besoin de plus de temps pour une longue réponse.
Si l'idée de base URL est nouvelle pour vous, ce qu'est base_url et comment basculer l'explique sans code.


