API e SDKGuida
Prima richiesta in Go con openai-go: base URL, chiave, usage
Un programma Go completo che chiama un modello CheapTokens tramite openai-go e stampa la risposta, finish_reason e l'usage dei token, con retry e timeout.
In questa pagina
Hai già del codice Go che parla con un'API in stile OpenAI, oppure stai per scriverne. Per inviarlo a CheapTokens cambi due opzioni sul client e una stringa, l'id del modello. L'SDK resta lo stesso: il pacchetto ufficiale openai-go, v3.
Qui sotto c'è il programma completo, poi cosa fa ogni riga, come leggere la risposta e i conteggi dei token, e come evitare che una richiesta bloccata blocchi il tuo servizio. Versioni verificate rispetto al README di openai-go il 3 novembre 2026: l'ultimo tag su quella pagina è v3.91.1, e richiede Go 1.26 o superiore.
Cosa ti serve prima di iniziare#
- Go 1.26 o superiore. Su Go 1.25 fissa
v3.74.0; su Go 1.22–1.24 fissav3.44.0(il README dice che la linea più vecchia non riceve correzioni garantite). - Una chiave API CheapTokens. Tienila in una variabile d'ambiente, non nel file sorgente.
- L'indirizzo dell'API:
https:/. Parla il formato OpenAI Chat Completions, quindi openai-go funziona senza wrapper. La documentazione ha lo stesso indirizzo e la pagina della chiave./ api. cheaptokens. dev/ v1 - Un id di modello. Usiamo
deepseek-: contesto da 380K e fino a 32.768 token in una risposta. Usa l'id completo; il nome breve delle tabelle dei prezzi non è accettato dall'API.ai/ DeepSeek- V4- Flash- 0731
Passo dopo passo
Prepara il progetto
Installa l'SDK
In una cartella vuota:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
Il percorso di import è github., il nome del pacchetto è openai.
Metti la chiave nell'ambiente
export CHEAPTOKENS_API_KEY="paste-your-key-here"Su Windows PowerShell: $env:CHEAPTOKENS_. Il segnaposto non è una chiave reale.
Crea main.go ed eseguilo
Incolla il programma della sezione successiva in main.go, poi esegui go run ..
Il programma completo#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}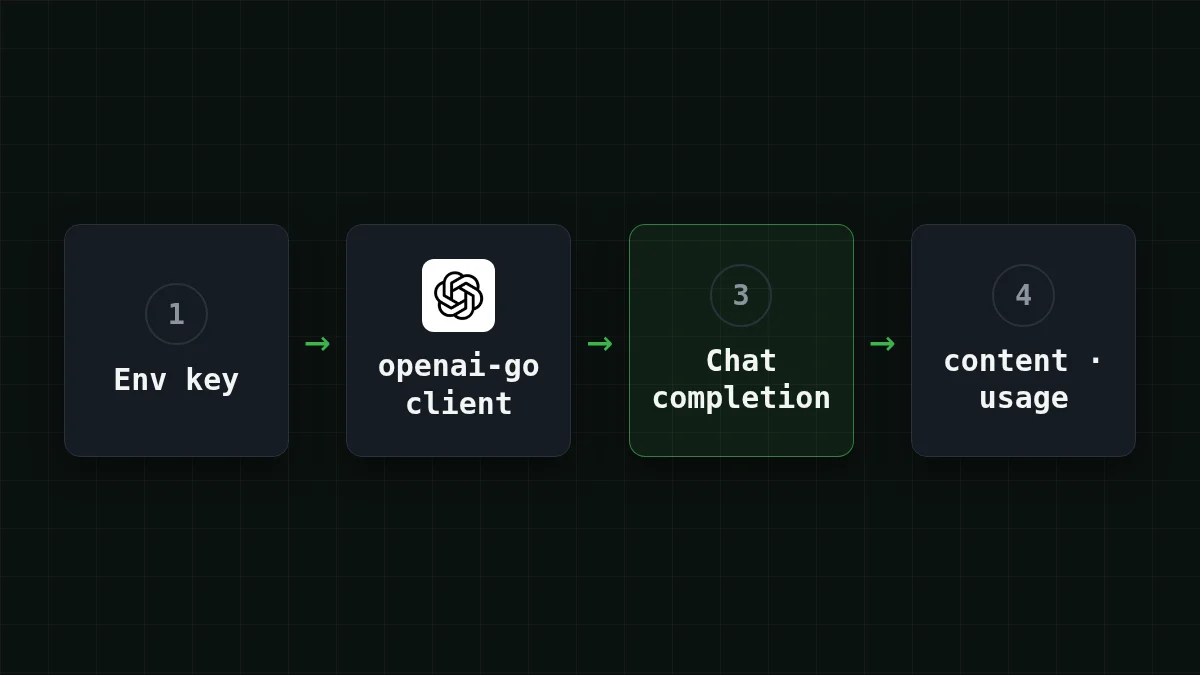
I pezzi che contano:
option.è l'unica riga che sposta l'SDK da OpenAI a CheapTokens. Usa l'indirizzo esattamente come nella documentazione.WithBaseURL(. . . ) option.passa la chiave esplicitamente. Senza di essa il client leggeWithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY, comodo quando porti codice esistente: imposta quella variabile a una chiave CheapTokens e il codice non richiede modifiche alla chiave. Lo stesso vale perOPENAI_BASE_URL, ma unWithBaseURLesplicito lo sovrascrive, quindi nessuna sorpresa se esistono entrambi.Modelè una stringa semplice nell'SDK (ChatModelè un alias distring), quindi qualsiasi id di modello funziona, non solo le costanti mostrate nel README.openai.è un turno utente. L'esempio del README usaUserMessage(. . . ) DeveloperMessagee una costante GPT; qui bastano un messaggio utente e un id stringa.
Leggi la risposta, finish_reason e usage#
Tutti e tre provengono da campi che l'SDK analizza già per te:
resp.è il testo (unaChoices[0]. Message. Content string).resp.è anch'esso unaChoices[0]. FinishReason string.stopsignifica che il modello ha finito da solo;lengthsignifica che la risposta ha raggiunto il limite di token ed è stata troncata. Se vedilength, leggi perché una risposta si interrompe a metà frase.resp.UsagecontienePromptTokens(quello che hai inviato),CompletionTokens(quello che ha scritto il modello) eTotalTokens, tuttiint64.
L'output sarà simile a questo: la risposta, poi finish_reason: con un valore, poi tre conteggi di token. I numeri cambiano a ogni esecuzione, quindi registrali. Sono ciò per cui paghi, e i token di output sono la parte più costosa.
Provalo tu stessoProva: cosa cambia se scambi il modello?Mostra risposta
Cambia la stringa Model in zai- ed esegui di nuovo. Nient'altro nel programma si muove. Il testo della risposta e i tre numeri di usage saranno diversi, ed è il modo più rapido per confrontare due modelli sul tuo prompt. GLM-5.3-Flash ha un contesto da 390K e fino a 8.192 token in una risposta.
Retry e timeout: tre limiti diversi#
È qui che i servizi Go di solito si fanno male: per impostazione predefinita l'SDK non ha alcun timeout, quindi una connessione bloccata può attendere per sempre. Tre impostazioni lo risolvono, e agiscono a livelli diversi:
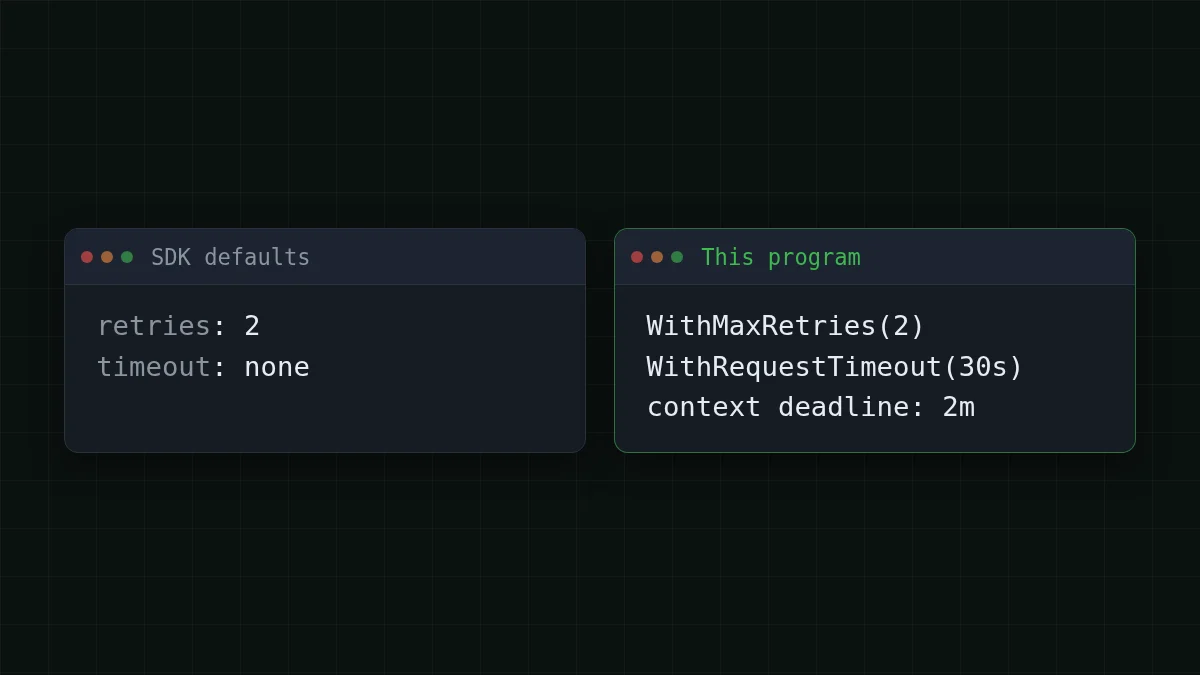
option.: l'SDK riprova gli errori di connessione, 408, 409, 429 e 5xx con una breve attesa esponenziale. Due retry sono già il default;WithMaxRetries(2) 0disattiva i retry. Puoi impostarlo sul client, o su una singola chiamata.option.: il limite per un singolo tentativo.WithRequestTimeout(30*time. Second) - La scadenza del
context: il limite per l'intera chiamata, retry e attese inclusi.
Quindi con 2 retry ci possono essere fino a 3 tentativi: 3 × 30 = 90 secondi di attesa nel caso peggiore, più le brevi pause tra i tentativi. Un contesto di due minuti lo copre. Se vuoi una regola rigida di risposta entro 20 secondi per un handler web, accorcia il contesto, non solo il timeout per tentativo.
Per un approfondimento più lungo sulla scelta di questi numeri, la versione Python dello stesso consiglio è in OpenAI Python SDK timeout and retries. La logica vale anche per Go.
Quanto costano mille di queste chiamate#
Supponiamo che tu gestisca un piccolo servizio che fa 1.000 richieste al giorno, ciascuna con circa 800 token di input e 300 di output. Su deepseek- quel giorno costa $0.042 (1.000 × 800 token di input, 1.000 × 300 token di output). La tabella mostra lo stesso carico sui nostri modelli; contato in totale, con input e output insieme, è più economico di OpenRouter.
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
800 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Inserisci i tuoi numeri. La prima esecuzione stampa i PromptTokens e i CompletionTokens reali, così non devi indovinare la media:
Calcolatore di costi
Un giorno di un piccolo servizio Go
Token di input per richiesta: 800 · Token di output per richiesta: 300 · Richieste al giorno: 1000
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
I prezzi sulla pagina dei prezzi e sulla pagina dei modelli sono aggiornati e usano un prezzo fisso per modello, senza ore di punta.
Se non funziona#
- L'errore menziona 401: la chiave è vuota o sbagliata.
os.Getenvrestituisce una stringa vuota per una variabile non impostata, quindi controllaecho $CHEAPTOKENS_nello stesso terminale in cui eseguiAPI_ KEY go run .. - L'errore menziona 404 o un modello sconosciuto: l'id. Copialo per intero, con il prefisso
deepseek-ai/. Puoi elencare gli id con la chiamata di elenco modelli. go: module requires Go 1.: il tuo toolchain è più vecchio. Fissa un tag SDK precedente come mostrato all'inizio.26 - La chiamata si blocca e poi fallisce: è il timeout che fa il suo lavoro. Controlla prima il percorso di rete, poi aumenta
WithRequestTimeoutse il modello ha davvero bisogno di più tempo per una risposta lunga.
Se l'idea di base URL è nuova per te, cos'è base_url e come cambiarlo lo spiega senza codice.


