使用 openai-go 在 Go 中发出第一个请求:base URL、密钥、usage
一个完整的 Go 程序,通过 openai-go 调用 CheapTokens 模型,并打印答案、finish_reason 和 token usage,带有重试和超时。
你已经有与 OpenAI 风格 API 通信的 Go 代码,或者即将编写一些。要把它发送到 CheapTokens,你只需更改客户端上的两个选项和一个字符串,即模型 id。SDK 保持不变:官方 openai-go 包,v3。
下面是完整程序,然后说明每一行做什么、如何读取答案和 token 计数,以及如何阻止卡住的请求挂起你的服务。版本已对照 2026 年 11 月 3 日的 openai-go README 检查:该页面上最新的标签是 v3.91.1,它需要 Go 1.26 或更新版本。
开始前你需要什么#
- Go 1.26 或更新版本。在 Go 1.25 上固定
v3.74.0;在 Go 1.22–1.24 上固定v3.44.0(README 说较旧的行不保证修复)。 - 一个 CheapTokens API 密钥。把它放在环境变量中,而不是源文件中。
- API 地址:
https:/。它使用 OpenAI Chat Completions 格式,因此 openai-go 无需包装器即可工作。文档 有相同的地址和密钥页面。/ api. cheaptokens. dev/ v1 - 一个模型 id。我们使用
deepseek-:380K 上下文,一次回答最多 32,768 个 token。使用完整 id;价格表中的短名称不被 API 接受。ai/ DeepSeek- V4- Flash- 0731
分步操作
设置项目
安装 SDK
在一个空文件夹中:
go mod init example.com/first-request
go get -u 'github.com/openai/openai-go/[email protected]'
导入路径是 github.,包名是 openai。
将密钥放入环境
export CHEAPTOKENS_API_KEY="paste-your-key-here"在 Windows PowerShell 上:$env:CHEAPTOKENS_。占位符不是真实密钥。
创建 main.go 并运行它
将下一节中的程序粘贴到 main.go,然后运行 go run .。
完整程序#
package main

import (
	"context"
	"fmt"
	"log"
	"os"
	"time"

	"github.com/openai/openai-go/v3"
	"github.com/openai/openai-go/v3/option"
)

func main() {
	client := openai.NewClient(
		option.WithBaseURL("https://api.cheaptokens.dev/v1"),
		option.WithAPIKey(os.Getenv("CHEAPTOKENS_API_KEY")),
		option.WithMaxRetries(2),
		option.WithRequestTimeout(30*time.Second),
	)

	ctx, cancel := context.WithTimeout(context.Background(), 2*time.Minute)
	defer cancel()

	resp, err := client.Chat.Completions.New(ctx, openai.ChatCompletionNewParams{
		Model: "deepseek-ai/DeepSeek-V4-Flash-0731",
		Messages: []openai.ChatCompletionMessageParamUnion{
			openai.UserMessage("Explain in two sentences what a token is."),
		},
	})
	if err != nil {
		log.Fatal(err)
	}
	if len(resp.Choices) == 0 {
		log.Fatal("no choices in the response")
	}

	fmt.Println(resp.Choices[0].Message.Content)
	fmt.Println("finish_reason:", resp.Choices[0].FinishReason)
	fmt.Println("input tokens:", resp.Usage.PromptTokens)
	fmt.Println("output tokens:", resp.Usage.CompletionTokens)
	fmt.Println("total tokens:", resp.Usage.TotalTokens)
}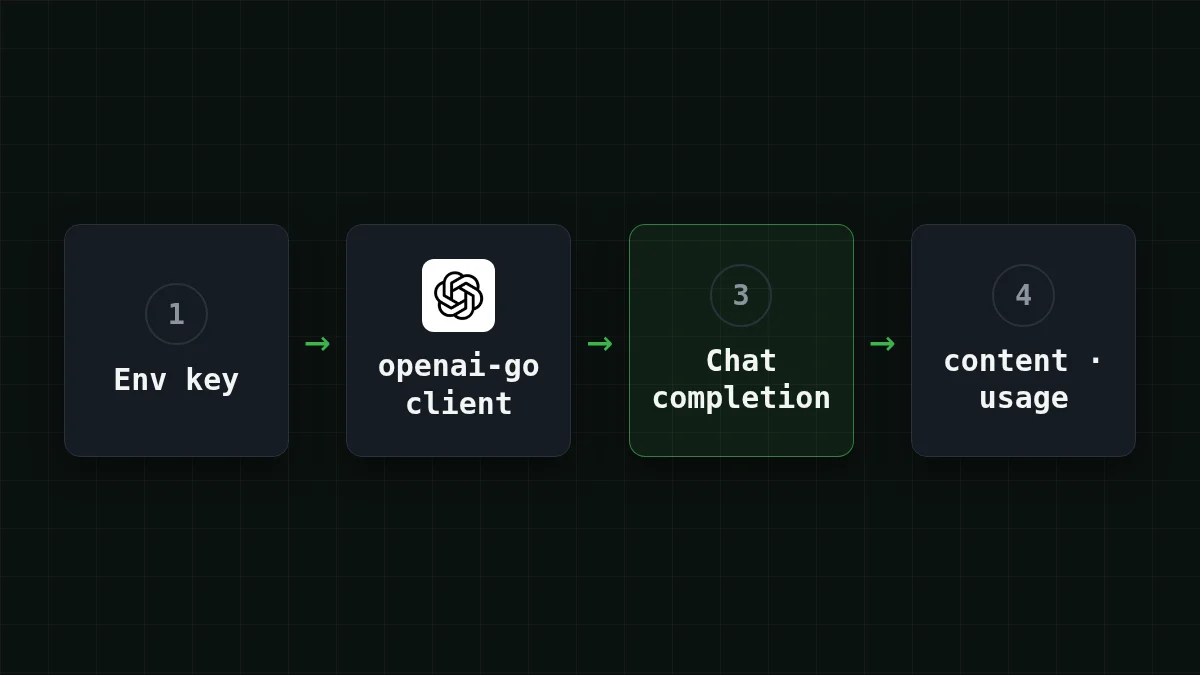
重要的部分:
option.是唯一将 SDK 从 OpenAI 移到 CheapTokens 的行。完全按照文档中的地址使用。WithBaseURL(. . . ) option.显式传递密钥。没有它,客户端会读取WithAPIKey(os. Getenv(. . . )) OPENAI_API_KEY,这在移植现有代码时很方便:将该变量设置为 CheapTokens 密钥,代码无需更改密钥。OPENAI_BASE_URL也是如此,但显式的WithBaseURL会覆盖它,因此如果两者都存在,也不会有意外。Model在 SDK 中是一个普通字符串(ChatModel是string的别名),因此任何模型 id 都可以工作,而不仅仅是 README 中显示的常量。openai.是一个用户轮次。README 示例使用UserMessage(. . . ) DeveloperMessage和一个 GPT 常量;这里一个用户消息和一个字符串 id 就足够了。
读取答案、finish_reason 和 usage#
这三者都来自 SDK 已经为你解析的字段:
resp.是文本(一个Choices[0]. Message. Content string)。resp.也是一个Choices[0]. FinishReason string。stop表示模型自行完成;length表示答案达到 token 限制并被截断。如果你看到length,请阅读 为什么答案在句子中间停止。resp.Usage包含PromptTokens(你发送的内容)、CompletionTokens(模型写的内容)和TotalTokens,都是int64。
输出将如下所示:答案,然后是带值的 finish_reason:,然后是三个 token 计数。每次运行的数字都不同,所以记录它们。它们是你付费的内容,而输出 token 是更昂贵的一侧。
自己试试试一试:如果更换模型会有什么变化?显示答案
将 Model 字符串改为 zai- 并再次运行。程序中没有其他变化。答案文本和三个 usage 数字会不同,这是在你自己的提示上比较两个模型的最快方法。GLM-5.3-Flash 有 390K 上下文,一次回答最多 8,192 个 token。
重试和超时:三个不同的限制#
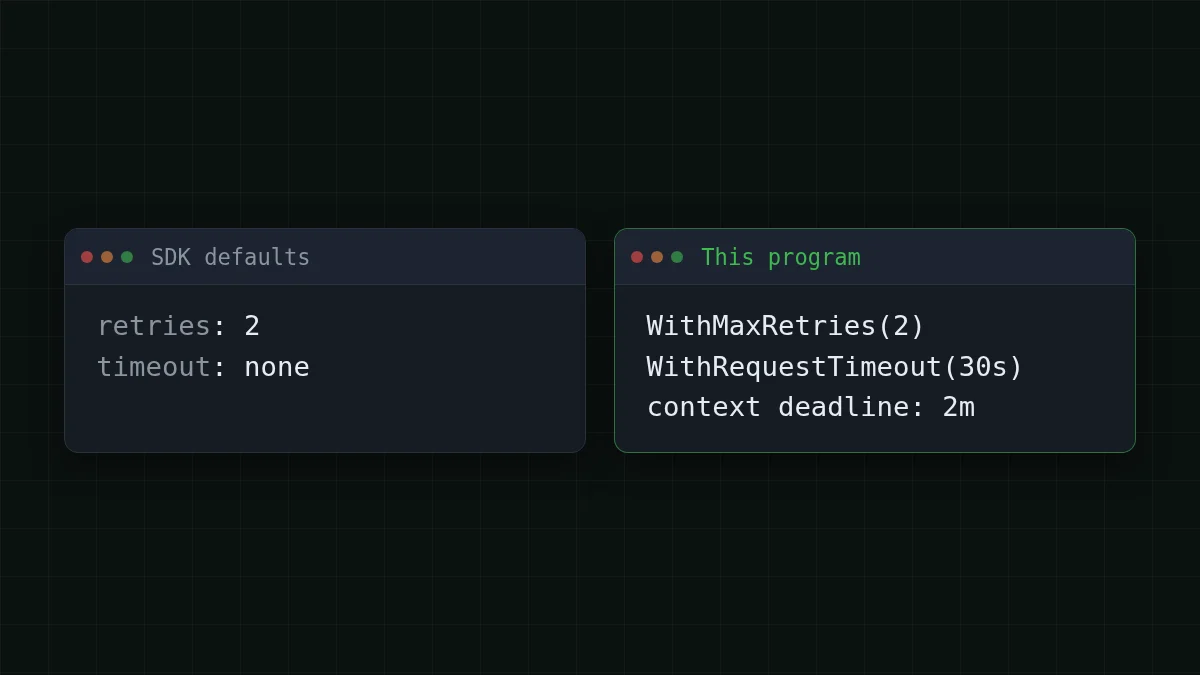
这是 Go 服务通常受到伤害的地方:默认情况下 SDK 根本没有超时,因此停滞的连接可以永远等待。三个设置可以解决这个问题,它们在不同级别工作:
option.:SDK 以短暂的指数等待重试连接错误、408、409、429 和 5xx。两次重试已经是默认值;WithMaxRetries(2) 0关闭重试。你可以在客户端上设置,也可以在单次调用上设置。option.:单次尝试的限制。WithRequestTimeout(30*time. Second) context截止时间:整个调用的限制,包括重试和等待。
因此,有 2 次重试时,最多可能有 3 次尝试:最坏情况下等待 3 × 30 = 90 秒,加上尝试之间的短暂停顿。两分钟的上下文可以覆盖这一点。如果你想要一个 Web 处理程序的硬性规则“20 秒内回答”,请缩短上下文,而不仅仅是每次尝试的超时。
关于选择这些数字的更长背景,相同建议的 Python 版本在 OpenAI Python SDK 超时和重试 中。逻辑可以沿用到 Go。
一千次这样的调用要花多少钱#
假设你运行一个小服务,每天发出 1,000 个请求,每个请求大约有 800 个输入 token 和 300 个输出 token。在 deepseek- 上,那天的费用是 $0.042(1,000 × 800 输入 token,1,000 × 300 输出 token)。表格显示了我们的模型上的相同负载;按总量计算,输入和输出加在一起,它比 OpenRouter 更便宜。
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 1,000 次请求 | OpenRouter,1,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000028 | $0.028 | $0.0517 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000042 | $0.042 | $0.098 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000085 | $0.085 | $1.02 |
每次请求 800 个输入 token 和 300 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
填入你自己的数字。你的第一次运行会打印真实的 PromptTokens 和 CompletionTokens,因此你不必猜测平均值:
成本计算器
一个小型 Go 服务的一天
每次请求的输入 token 数: 800 · 每次请求的输出 token 数: 300 · 每日请求数: 1,000
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.028 | $0.84 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.042 | $1.26 |
| MiniMax-M2.7$0.05$0.15 | $0.085 | $2.55 |
定价页面 和 模型页面 上的价格是实时的,每个模型使用一个固定价格,没有高峰时段。
如果它不工作#
- 错误提到 401: 密钥为空或错误。
os.Getenv对未设置的变量返回空字符串,因此在运行go run .的同一终端中检查echo $CHEAPTOKENS_。API_ KEY - 错误提到 404 或未知模型: id。完整复制它,带有
deepseek-ai/前缀。你可以在 模型列表调用 中列出 id。 go: module requires Go 1.: 你的工具链较旧。如顶部所示固定一个较旧的 SDK 标签。26 - 调用挂起然后失败: 那是超时在起作用。先检查网络路径,然后如果模型确实需要更多时间来完成长答案,请提高
WithRequestTimeout。
如果 base URL 概念对你来说是新的,什么是 base_url 以及如何切换 无需代码即可解释。


