API & SDKAnleitung
Erste Anfrage in Java mit openai-java: Basis-URL, Schlüssel, Nutzung
Ein ausführbares Java-8+-Programm: openai-java auf CheapTokens gerichtet, eine Chat-Completion, und die Antwort, finish_reason und Token-Nutzung ausgegeben.
Auf dieser Seite
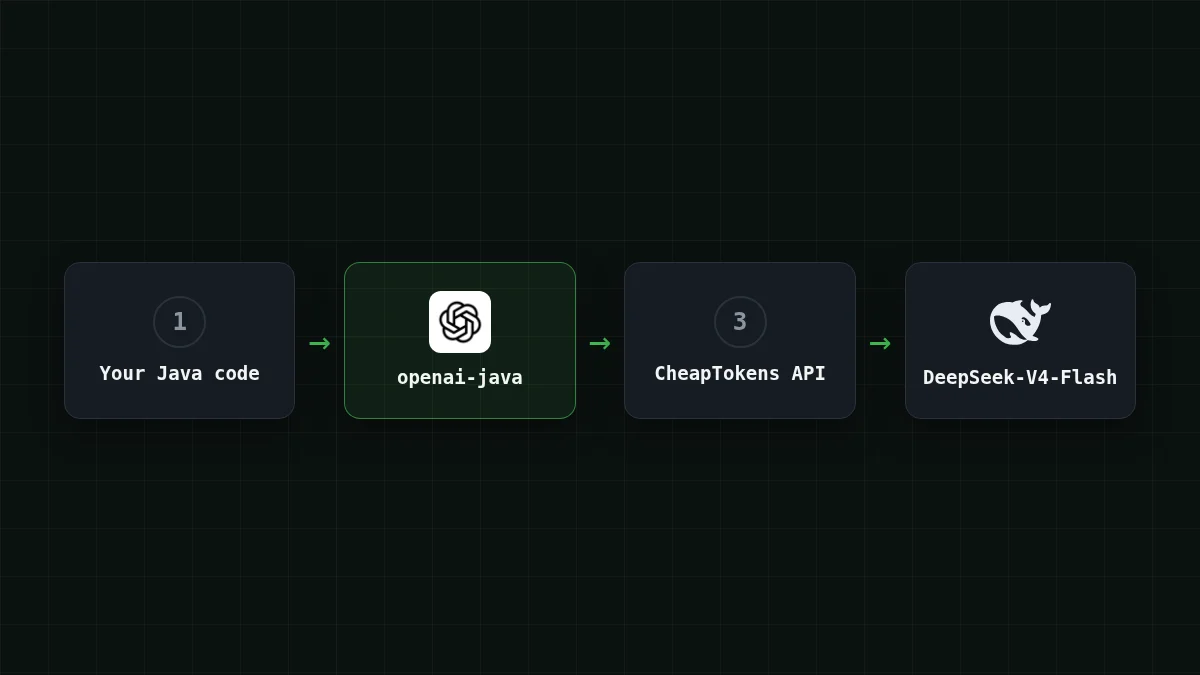
Um CheapTokens aus Java aufzurufen, behalte das offizielle openai-java SDK und ändere drei Dinge: die Basis-URL (https:/), den API-Schlüssel und die Modell-ID, die als einfacher String übergeben wird. Das folgende Programm sendet eine Chat-Completion und gibt die Antwort, den finish_reason und die Token-Nutzung aus. Es benötigt Java 8 oder neuer.
Wenn dein Team bereits einen Spring-Service hat, der mit OpenAI spricht, ist das die gesamte Migration: kein neuer Client, keine neuen Request-Klassen.
Die Abhängigkeit hinzufügen#
Die README des SDK (github.com/openai/openai-java, geprüft am 4. November 2026) zeigt Version 4.99.0, Gruppe com.openai, Artefakt openai-java. Die README gibt kein Veröffentlichungsdatum an, also schau im Repository nach der neuesten Version, bevor du das hier kopierst.
openai-java zum Build hinzufügen
Maven
<dependency>
  <groupId>com.openai</groupId>
  <artifactId>openai-java</artifactId>
  <version>4.99.0</version>
</dependency>
Gradle
implementation("com.openai:openai-java:4.99.0")Die framework-neutralen Artefakte laufen auf Java 8+, ein älteres Firmen-JDK ist also kein Hindernis.
Schlüssel und Basis-URL außerhalb des Codes setzen#
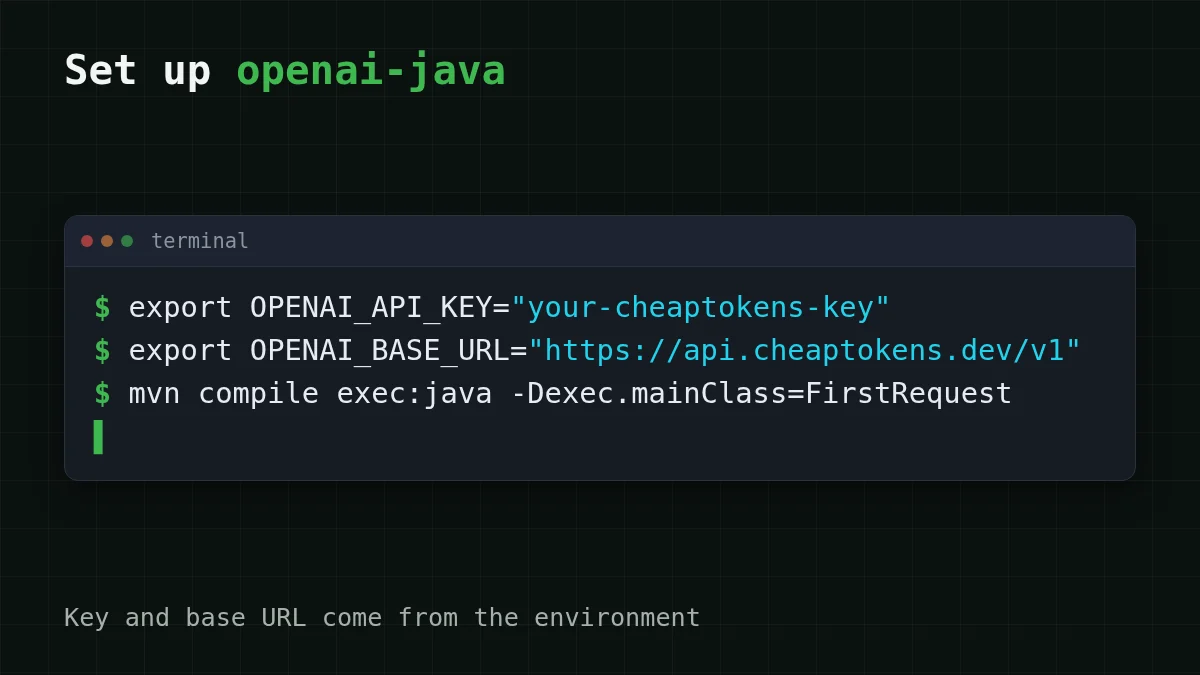
Das SDK liest zwei Umgebungsvariablen: OPENAI_API_KEY und OPENAI_BASE_URL. OpenAIOkHttpClient. übernimmt beide, sodass der Schlüssel nie in deinen Quelldateien landet. (System-Properties openai.apiKey und openai.baseUrl funktionieren ebenfalls und haben Vorrang vor den Variablen.)
export OPENAI_API_KEY="your-cheaptokens-key"
export OPENAI_BASE_URL="https://api.cheaptokens.dev/v1"
Die Standard-Basis-URL des SDK ist https:/. Lass die zweite Zeile weg, und deine Anfrage geht dorthin, mit einem CheapTokens-Schlüssel, den es nicht kennt. Das ist ein Weg, beim ersten Lauf einen 401 zu bekommen. Wo du den Schlüssel aufbewahrst und wie du ihn aus git heraushältst, steht unter einen API-Schlüssel sicher speichern.
Das Programm#
Erstelle FirstRequest.:
import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.chat.completions.ChatCompletion;
import com.openai.models.chat.completions.ChatCompletionCreateParams;

public class FirstRequest {
  public static void main(String[] args) {
    OpenAIClient client = OpenAIOkHttpClient.fromEnv();

    ChatCompletionCreateParams params = ChatCompletionCreateParams.builder()
        .model("deepseek-ai/DeepSeek-V4-Flash-0731")
        .addUserMessage("Explain in two sentences what a token is.")
        .maxCompletionTokens(300L)
        .build();

    ChatCompletion completion = client.chat().completions().create(params);
    ChatCompletion.Choice choice = completion.choices().get(0);

    System.out.println(choice.message().content().orElse("(no text)"));
    System.out.println("finish_reason: " + choice.finishReason());
    completion.usage().ifPresent(u ->
        System.out.println("input " + u.promptTokens()
            + ", output " + u.completionTokens()));
  }
}
Ein paar Zeilen verdienen einen zweiten Blick.
.. Die README-Beispiele des SDK verwenden typisierte Konstanten wiemodel("deepseek- ai/ DeepSeek- V4- Flash- 0731") ChatModel., aber der Builder hat auch eineGPT_ 5_ 2 model(String)-Überladung, sodass jede ID funktioniert. Verwende die vollständige ID aus der CheapTokens-Dokumentation: Der Kurznamedeepseek-ist die Bezeichnung, unter der Preise auf der Website stehen; die API will die vollständige ID mit dem Präfixv4- flash- 0731 deepseek-ai/. Unsicher bei einer ID? Modelle mit GET /v1/models auflisten... Eine Obergrenze für die Antwortlänge, alsmaxCompletionTokens(300L) long. DeepSeek-V4-Flash erlaubt bis zu 32.768 Ausgabe-Token pro Antwort, 300 hier ist also eine Entscheidung, um die Demo kurz zu halten, keine Grenze des Modells.content()ist einOptional. Deshalb hat das ProgrammorElse. Eine Antwort, die nur aus Tool-Aufrufen besteht, hat keinen Text.usage()ist ebenfalls einOptional.ifPresentgibt ihn aus, wenn der Server ihn sendet.
Kompiliere und führe es so aus, wie es dein Build tut (mvn compile exec:java -, oder eine JavaExec-Aufgabe in Gradle). Du solltest die Erklärung eines Tokens erhalten, dann eine Zeile finish_reason: … mit stop darin, dann eine Zeile mit den Eingabe- und Ausgabe-Token-Zahlen. Wenn finish_reason length sagt, hat die Antwort deine 300-Token-Grenze erreicht und wurde abgeschnitten: Erhöhe die Zahl (warum das passiert).
usage() gibt die Token-Zahlen für Prompt, Completion und Gesamt zurück (promptTokens(), completionTokens(), totalTokens()).
Die Werte explizit mit dem Builder setzen#
Tests oder ein Service mit mehreren Clients brauchen manchmal explizite Werte. Derselbe Client, von Hand gebaut:
OpenAIClient client = OpenAIOkHttpClient.builder()
    .apiKey(System.getenv("OPENAI_API_KEY"))
    .baseUrl("https://api.cheaptokens.dev/v1")
    .build();
Alles nach dieser Zeile, die Parameter und der create-Aufruf, bleibt genau wie oben. Lies den Schlüssel auch hier aus der Umgebung; ein String-Literal in einer .java-Datei landet in deinem Repository.
Drei Fehler, die dir zuerst begegnen werden#
Paare zuordnen
Ordne das Symptom der Ursache zu
Tippe auf ein Element links, dann auf sein Paar
- 401 Unauthorizedder Schlüssel ist leer oder falsch, oder die Anfrage ging an api.openai.com, weil
OPENAI_BASE_URLnicht gesetzt ist - 404 Not Foundder Basis-URL fehlt
/v1, oder die Modell-ID existiert nicht - finish_reason sagt length
maxCompletionTokensist niedriger als die Antwort benötigt
Eine leere Umgebungsvariable übersieht man in einer IDE leicht: Eine Run-Konfiguration, die über die Toolbar gestartet wird, erbt möglicherweise nicht die Variablen, die du im Terminal exportiert hast. Wenn der Schlüssel „gesetzt ist“, du aber trotzdem 401 bekommst, füge die Variablen zur Run-Konfiguration hinzu. Mehr zu diesen Codes: API 401 oder 404: Schlüssel, Basis-URL, Modell-ID.
Was eine Anfrage kostet#
Weil du usage ausgibst, kannst du die Anfrage bepreisen, bevor du skalierst. Angenommen, dein Service sendet etwa 200 Eingabe-Token und bekommt 300 zurück. Zu heutigen Preisen kostet diese Anfrage $0.000033 bei DeepSeek-V4-Flash. Eingabe und Ausgabe werden zusammen abgerechnet, und insgesamt ist das günstiger als OpenRouter. Die Tabelle wiederholt es für 1.000 Anfragen über unsere Modelle:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000016 | $0.016 | $0.0316 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000033 | $0.033 | $0.056 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.000055 | $0.055 | $0.66 |
200 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Jetzt setze deinen eigenen Traffic ein. Ziehe die Schieberegler auf die Zahlen aus deiner ersten ausgegebenen usage-Zeile:
Kostenrechner
Ein Support-Service mit 2.000 Anfragen pro Tag
Eingabe-Tokens pro Anfrage: 200 · Ausgabe-Tokens pro Anfrage: 300 · Anfragen pro Tag: 2.000
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.032 | $0.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.066 | $1.98 |
| MiniMax-M2.7$0.05$0.15 | $0.11 | $3.30 |
Für mehr Spielraum pro Antwort oder eine andere Form von Workload bietet DeepSeek-V4-Flash ein 380K-Kontextfenster und einen Preis zu jeder Tageszeit; GLM-5.3-Flash (zai-) ist ein Drop-in-Ersatz im selben Programm: Ändere die ID, sonst nichts. Aktuelle Preise für alle Modelle stehen auf der Preisseite, und die Dokumentation zeigt dieselbe Anfrage in anderen Sprachen. Machst du das in Go? Siehe die openai-go-Version.


