शुरुआत करेंगाइड
Postman में OpenAI-संगत API के लिए पहली request
Postman से chat/completions request भेजें, Bearer key को एक variable में रखें, और उत्तर तथा usage फ़ील्ड पढ़ें।
इस पृष्ठ पर
आपके पास API key है और आप कोड की एक पंक्ति लिखने से पहले यह देखना चाहते हैं कि वास्तव में wire पर क्या जाता है। Postman ठीक इसी के लिए अच्छा है: आप एक URL, एक key और एक JSON body भरते हैं, Send दबाते हैं, और उत्तर ठीक नीचे दिखाई देता है। CheapTokens के लिए request POST https:/ है, जिसमें Authorization: Bearer key और एक JSON body होती है जो model का नाम बताती है।
नीचे दिए गए चरण Postman के अपने docs (v12, docs साइट पर नवीनतम संस्करण, 31 अक्टूबर 2026 को जाँचा गया) का पालन करते हैं। यदि आप terminal पसंद करते हैं, तो वही request Your first API request with CheapTokens में है।
इसे चार चालों में सेट करें#
आपको बस कुछ चीज़ें चाहिए: base URL, आपकी key, एक model id और एक message। Postman पहली दो को variables में रखता है, इसलिए key कभी request में सीधे paste नहीं होती।
क्रम में लगाएँ
Postman सेटअप को क्रम में रखें
आइटम खींचें या तीरों का उपयोग करें
- base_url और api_key variables परिभाषित करें
- एक HTTP request बनाएँ: {{base_url}}/chat/completions पर POST
- Authorization टैब पर Bearer Token चुनें और {{api_key}} दर्ज करें
- Body टैब पर raw > JSON चुनें, body paste करें, Send दबाएँ
प्रत्येक चाल के लिए कुछ विवरण।
Request बनाएँ। बाएँ sidebar में Add आइकन पर क्लिक करें और HTTP चुनें। method dropdown डिफ़ॉल्ट रूप से GET होता है, इसलिए इसे POST पर स्विच करें और URL दर्ज करें। Postman variables {{variable_ के रूप में लिखे जाते हैं; docs उदाहरण के रूप में {{base_url}} का उपयोग करते हैं। base_url को https:/ के रूप में परिभाषित करें और URL फ़ील्ड {{base_ बन जाता है। Postman variables को strings के रूप में संग्रहीत करता है, जो यहाँ ठीक है।
Key जोड़ें। Authorization टैब खोलें, Auth Type dropdown में Bearer Token चुनें और Token फ़ील्ड में {{api_key}} डालें। Postman इसे Bearer प्रारूप में Authorization header के रूप में भेजता है। docs ठीक इसी की सलाह देते हैं: token को एक variable में रखें और नाम से संदर्भित करें। यह आदत क्यों मायने रखती है, यह Store an API key safely में है।
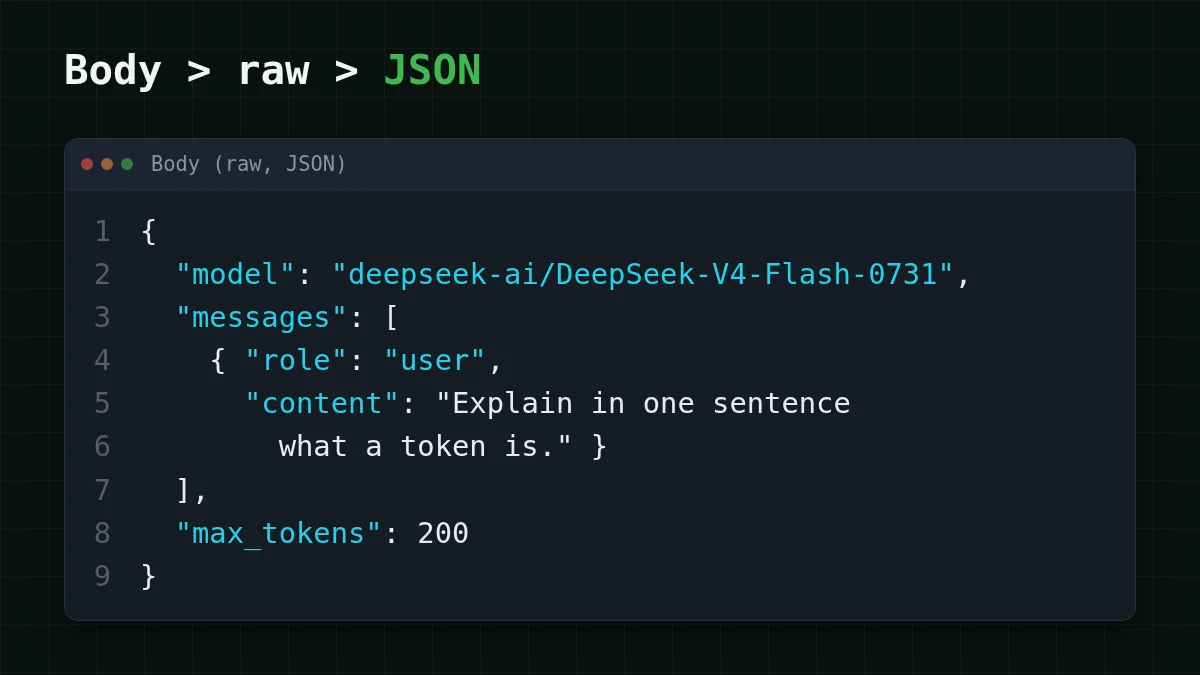
Body लिखें। Body टैब पर raw चुनें, फिर dropdown में JSON। raw bodies के लिए Postman स्वयं मिलान वाला Content-Type सेट करता है, इसलिए आप वह header नहीं जोड़ते। यह paste करें:
{
  "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
  "messages": [
    { "role": "user", "content": "Explain in one sentence what a token is." }
  ],
  "max_tokens": 200
}
model id CheapTokens docs से पूरा gateway_id है; deepseek-flash जैसा छोटा नाम स्वीकार नहीं किया जाता। max_tokens उत्तर की लंबाई सीमित करता है, इसलिए पहला परीक्षण लंबा नहीं चल सकता। एक और Postman विवरण: JSON body में // और /* */ comments भेजने से पहले हटा दिए जाते हैं, इसलिए आप साथी के लिए body पर टिप्पणी कर सकते हैं।
Send दबाएँ और response पढ़ें#
यदि सब कुछ सही है, तो response pane OpenAI Chat Completions प्रारूप में एक JSON object दिखाता है। दो जगहें मायने रखती हैं:
choices[0].उत्तर का पाठ है।message. content usageमेंprompt_tokens(जो आपने भेजा) औरcompletion_(जो model ने लिखा) होता है। इसी के लिए आपसे शुल्क लिया जाता है, इसलिए इसे पहली request पर ही देखें।tokens
choices[0]. भी जाँचें। stop का अर्थ है कि model ने स्वयं समाप्त किया; length का अर्थ है कि उत्तर max_tokens तक पहुँच गया और काट दिया गया। यदि आप ऐसा देखते हैं, तो सीमा बढ़ाएँ या AI answer cut off? Fix finish_reason "length" पढ़ें।
उत्तर खोलने से पहले इसे आज़माएँ:
स्वयं आज़माएँआज़माएँ: आप max_tokens को 5 पर सेट करते हैं और Send दबाते हैं। finish_reason में आप क्या अपेक्षा करते हैं?उत्तर दिखाएँ
आपको length मिलता है: पाँच tokens एक पूरे वाक्य के लिए पर्याप्त नहीं हैं, इसलिए उत्तर काट दिया जाता है। 200 वापस रखें और यह stop बन जाता है।
पहली request की लागत#
मान लें कि ऊपर की request लगभग 30 input tokens का उपयोग करती है और उत्तर लगभग 100 output tokens लेता है (एक उदाहरण, माप नहीं; आपका usage फ़ील्ड वास्तविक संख्याएँ दिखाता है)। DeepSeek-V4-Flash पर वर्तमान मूल्य पर यह $0.00001 है, और मूल्य किसी भी घंटे समान रहता है। प्रति 1M tokens की कीमतें the pricing page पर लाइव तालिका में हैं।
वही Postman request किसी अन्य model को आज़मा सकती है। केवल model पंक्ति बदलें, उदाहरण के लिए zai- के साथ (390K context, 8,192 output tokens तक), और फिर से Send दबाएँ। एक balance सभी models को कवर करता है, इसलिए और कुछ नहीं बदलता: वही URL, वही key।
यदि यह काम न करे#
Postman response के बगल में status code दिखाता है। ये आम संदिग्ध हैं:
जोड़े मिलाएँ
लक्षण को उसके कारण से मिलाएँ
बाईं ओर एक आइटम पर टैप करें, फिर उसका जोड़ा
- 401 UnauthorizedKey गायब है, गलत टाइप की गई है, या {{api_key}} खाली है क्योंकि variable परिभाषित नहीं है
- 404 Not FoundURL गलत है: जाँचें कि base_url /v1 पर समाप्त होता है और path /chat/completions है
- model का उल्लेख करने वाली त्रुटिmodel id छोटा कर दिया गया है; deepseek-ai/DeepSeek-V4-Flash-0731 जैसा पूरा id उपयोग करें
Postman-विशिष्ट दो चीज़ें जाँचने योग्य हैं। यदि आपको 401 मिलता है या URL गलत लगता है, तो जाँचें कि base_url और api_key उस environment में परिभाषित हैं जिसे आपने चुना है। और यदि key सही लगती है लेकिन फिर भी 401 मिलता है, तो Authorization टैब फिर से खोलें: Auth Type Bearer Token होना चाहिए, No Auth नहीं। इन codes के बारे में अधिक: API 401 or 404 error। निश्चित नहीं कि कौन सा id उपयोग करें? List models with GET /v1/models सभी लौटाता है।
जब आप इससे संतुष्ट हों, तो Save दबाएँ, request को एक नाम दें और एक collection चुनें। अगली बार आप केवल content फ़ील्ड संपादित करते हैं, या उत्तरों की तुलना करने के लिए model पंक्ति। पूरा API संदर्भ the CheapTokens docs में है।


