AI 入门深度解析
通过与 AI agent 对话搭建网站:HackerTube 示例
Karpathy 的 HackerTube 如何分为四个阶段,哪三个步骤 agent 无法替你完成,以及如何估算批量筛选阶段的成本。
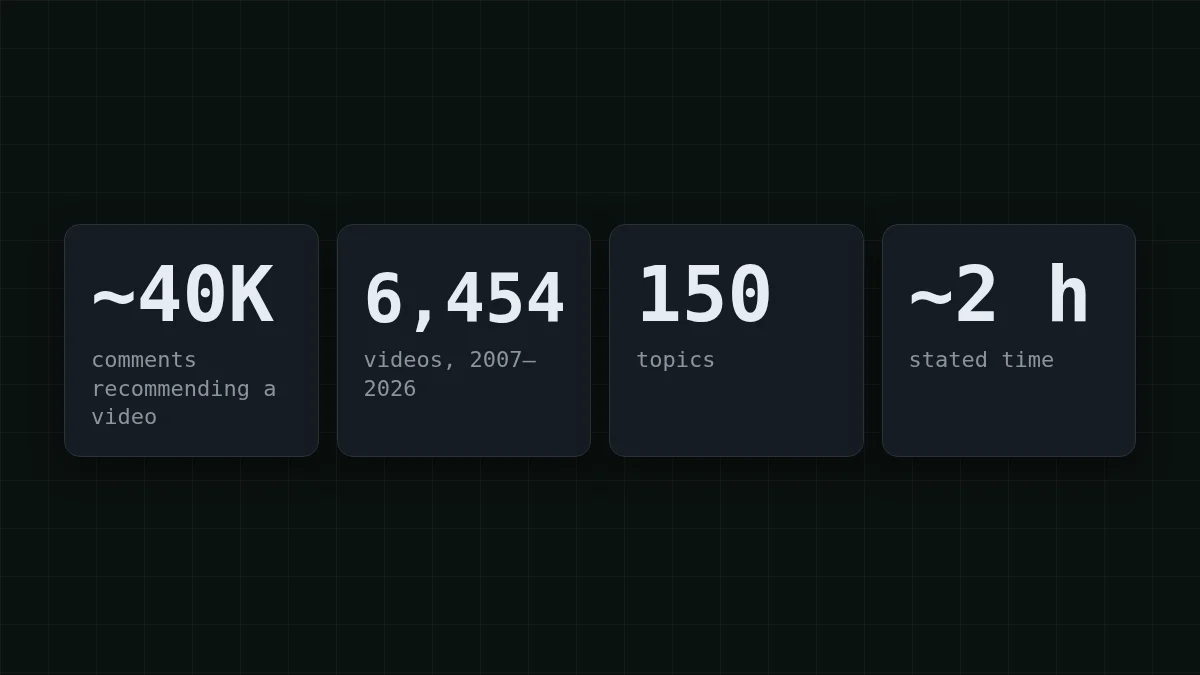
AI agent 可以为你搭建整个网站,但有三件事除外:API 密钥、服务器和域名。这正是 HackerTube 的分工方式——Andrej Karpathy 表示,他仅通过与 Claude 对话,在大约两小时内就做出了这个 YouTube 风格的网站。下面介绍:该项目经历的四个阶段、你需要自己准备什么,以及如何估算重复性的中间阶段在你自己的数据上会花费多少。
四个阶段,按此顺序#
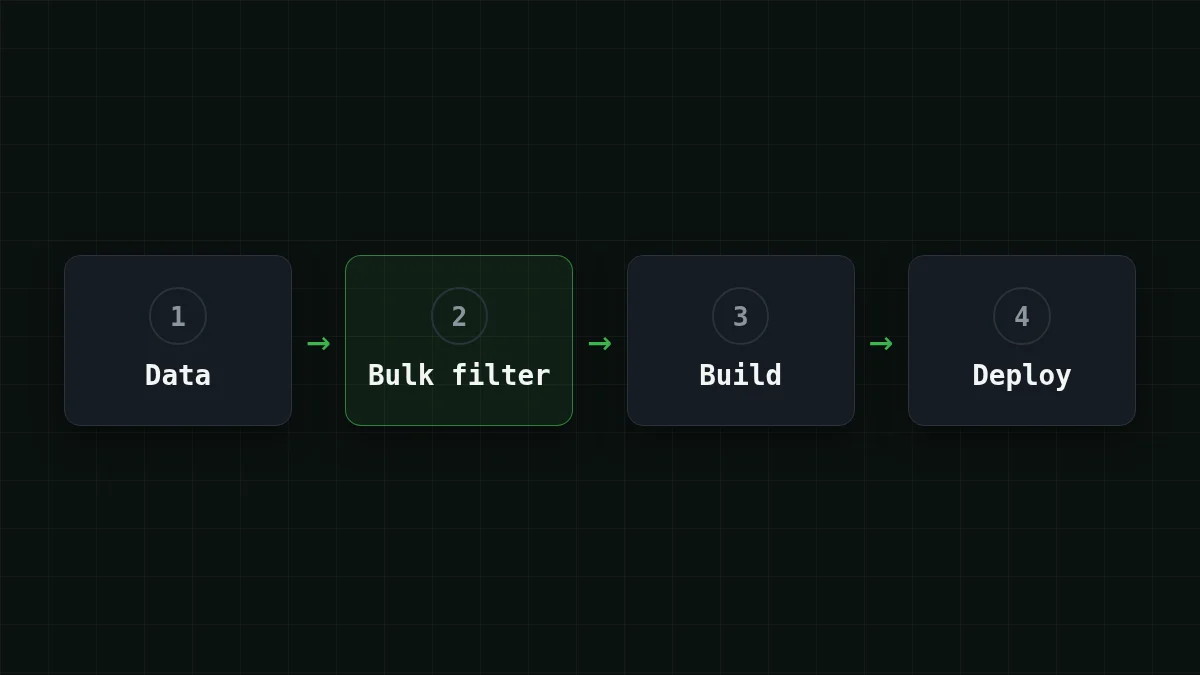
Karpathy(AI 研究员、OpenAI 联合创始人、前特斯拉 AI 总监、Eureka Labs 创始人)于 2026 年 10 月 31 日发布了这篇记录:HackerTube on his blog。该网站收集 Hacker News 中推荐 YouTube 视频的评论,并让你浏览这些评论。其背后是一个几乎每个“只和 agent 对话”项目都共有的骨架。试着自己把它们排好顺序:
排序
将数据到网站项目的各个阶段排序
拖动项目或使用箭头
- 下载原始数据集
- 用较小的模型逐条处理:保留或丢弃
- 用剩下的内容构建界面
- 部署到服务器
第二阶段与众不同。下载、构建和部署各发生一次。而“保留还是丢弃”这个问题要对每一条内容问一次,总共数万次。记住这一点,等我们谈到钱时会再回来。
agent 做了什么,用数字说话#
以下是 Karpathy 描述的这次运行。他在 Claude Code 桌面应用中工作。Opus 5.5 以中等强度(他的默认设置)从 Hugging Face 下载了 Hacker News 评论数据集并进行了筛选。Sonnet 在 Claude Code Workflow 中处理了这些评论。结果:约 4 万条推荐 YouTube 视频的评论,2007 年至 2026 年的 6,454 个视频,分为 150 个主题。然后 Opus 构建了界面并部署到 VPS。网站有无需账户的“ForYou”推荐(状态保存在浏览器会话中)、键盘快捷键和数据导出,这样其他人可以把数据交给自己的 agent。
帖子没有告诉你的是:任何成本或 token 数量,以及哪些步骤是纯代码、哪些是模型调用。所以“两小时”是时间,不是价格。如果你想了解为什么这个区别很重要,do agents need the model at every step? 有相关讨论。
三件始终由你负责的事#
Karpathy 手动完成了三个步骤:创建 Google Cloud API 密钥(用于 YouTube 元数据)、启动 VPS 和购买域名。看看它们的共同点。每一个都绑定到你自己的账户:登录信息、账单资料、你的身份。agent 可以写出每一条命令,但它不能以你的身份站在收银台前。这就像雇一个建筑工:他们会把房子盖起来,但土地要你来签字。
配对
将每个步骤与它为何由你负责匹配起来
点击左侧项目,然后点击其配对项
- 创建 YouTube 元数据 API 密钥它存在于你的 Google Cloud 账户中
- 启动服务器它计入你的托管账户账单
- 购买域名它注册在你名下
- 编写筛选脚本和界面这部分由 agent 完成
实际上 agent 会停下来问你。密钥你自己来做,把它放进环境变量,只把变量名告诉 agent,绝不要给密钥本身。如果你对密钥还不熟悉,what an API key is and how to store it safely 只需五分钟。
在你自己的数据上试试同样的形状#
假设你有 reviews.csv,包含 40,000 条产品评论,你想要一个小的可搜索页面,只包含关于电池续航的评论。一个 HackerTube 风格的提示词:
I have reviews.csv (40000 rows, column: text). Goal: a small searchable web page with only the reviews about battery life.

1. Look at the file and tell me what is in it. Change nothing yet.
2. Write a script that sends each review to a model and gets back keep or drop. Use an OpenAI-compatible API: base URL https://api.cheaptokens.dev/v1, key from the environment variable CHEAPTOKENS_API_KEY, model deepseek-ai/DeepSeek-V4-Flash-0731.
3. Run it on the first 100 reviews, show me the results and the tokens used. Wait for my OK before the full run.
4. Build the page from the kept reviews.
Whenever you need an account, a key or a payment from me, stop and tell me what to do.
第 3 步是值得借鉴的习惯。一百行几乎不花什么钱,而且你能在模型花四万条的钱之前看到它的错误。最后一行是上一节交接内容的书面形式。基础 URL 和模型 id 来自 CheapTokens docs;密钥你在那里自己创建。
批量阶段要花多少钱#
回到重复的那个阶段。假设每条评论加一行指令约 150 个 token,答案(“保留”或“丢弃”)约 10 个。对于 40,000 条评论,就是 40000 × 150 = 6000000 个输入 token 和 40000 × 10 = 400000 个输出 token。在 DeepSeek-V4-Flash 上,整个处理过程是 $0.13,在 GLM-5.3-Flash 上是 $0.136。把输入和输出加在一起算,两者都比 OpenRouter 便宜。每个请求都很小,所以 380K 和 390K 的上下文窗口根本用不上;重要的是每 token 价格乘以非常大量的调用。
把数字换成你自己的数据看看:
成本计算器
一次批量筛选:40,000 条
每次请求的输入 token 数: 150 · 每次请求的输出 token 数: 10 · 每日请求数: 40,000
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.136 | $4.08 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.13 | $3.90 |
| MiniMax-M2.7$0.05$0.15 | $0.36 | $10.80 |
这只是一个阶段。构建和部署是与 agent 的单独会话,而你真正的筛选提示词会比一行更长。Filter 40K comments with an LLM 展示了一个完整的保留/丢弃提示词,model routing 解释了如何先把简单的条目发给便宜的模型。每个模型的最新价格在 pricing page 上。
快速检查
像这样的项目中哪个阶段运行次数最多?
显示答案
答案: 判断每条内容:保留还是丢弃
保留或丢弃的判断对每条内容运行一次,所以 40,000 条内容意味着 40,000 次调用。这就是为什么它的单次调用价格是首先要检查的数字。
你的第一步:把那 100 行通过 first-request setup 发出去,读一读答案,然后才让 agent 运行剩下的。


