工具与集成指南
将 OpenHands 连接到 CheapTokens:模型、Base URL、密钥
在 OpenHands Settings > LLM(Advanced)中填写三个字段,即可让 agent 运行在 CheapTokens 模型上,并学会解读三种常见故障。
在 Settings > LLM 中打开 Advanced 后填写三个字段,即可让 OpenHands 运行在 CheapTokens 模型上:Custom Model(openai/)、Base URL(https:/)和 API Key。整个配置就这些。本页其余内容说明每个字段的含义,以及其中一个填错时会出现什么情况。
字段名称和模型字符串规则来自 OpenHands 文档中关于 OpenAI 兼容端点的页面(查阅于 2026 年 11 月 8 日;该页面没有日期或版本)。该日期最新的 OpenHands 版本是 v1.37.0(2026 年 11 月 6 日)。如果你所用版本中的标签略有不同,请按位置判断:模型、Base URL、密钥。
打开 Settings 之前#
手边准备好三样东西可以省去一次来回:密钥、模型 id 和 Settings 的访问权限。
清单
准备好配置了吗?
刚接触密钥和 Base URL?What base_url is and how to switch 几分钟就能讲清楚,list models with GET /v1/models 则展示如何自行查找 id。
三个字段#
打开 Settings > LLM,开启 Advanced。Base URL 字段位于 Advanced 开关下方。
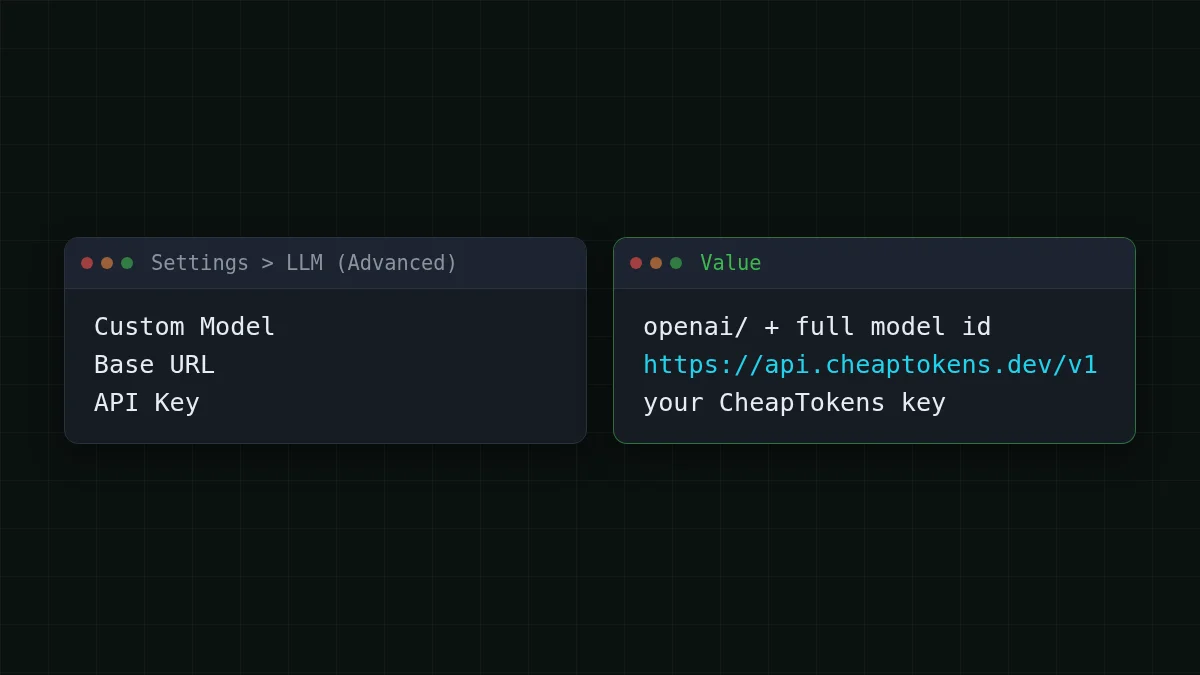
文档对模型规则的描述是:Custom Model 为 openai/ 后接模型名称;如果你通过带有自己前缀的代理,则为 openai/。openai/ 之后的部分就是模型名称。对于 CheapTokens,id 是 deepseek-,因此完整字符串是 openai/。
向右滚动表格 →
| 字段 | 值 |
|---|---|
| Custom Model | openai/ |
| Base URL | https:/ |
| API Key | 你的 CheapTokens 密钥 |
为什么给 agent 选这个模型?DeepSeek-V4-Flash 有 380K 上下文窗口,每次回答最多 32,768 个输出 token,并且任何时段都是同一价格,因此长会话不会在高峰时段变贵。编码 agent 在每一步都会重新发送大量上下文,这正是该窗口的用途。
更喜欢 GLM?在同一个字段中使用 openai/(390K 上下文,最多 8,192 个输出 token),其他什么都不用改。同样的余额、同样的密钥、同样的 Base URL。
先在 OpenHands 之外检查各部分#
在归咎于 agent 之前,先用相同的 URL、密钥和 id 发送一个请求。如果这个请求成功,剩下的任何问题都在于你填写字段的方式。
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model":"deepseek-ai/DeepSeek-V4-Flash-0731","messages":[{"role":"user","content":"Say ready"}],"max_tokens":20}'注意缺少了什么:model 值中没有 openai/。该前缀是给 OpenHands 用的,不是给 API 用的。回复中会带有一个 usage 块,包含 prompt_tokens 和 completion_——也就是你之后会在 agent 会话中看到累加的同样两个数字。
比较
模型字符串:一个前缀,两种结果
仅 id
deepseek-——用于 curl 和 API 的形式。
带前缀
openai/——用于 Custom Model 字段的形式。
字段填错时是什么样#
三个字段中的任何一个都可能是原因:
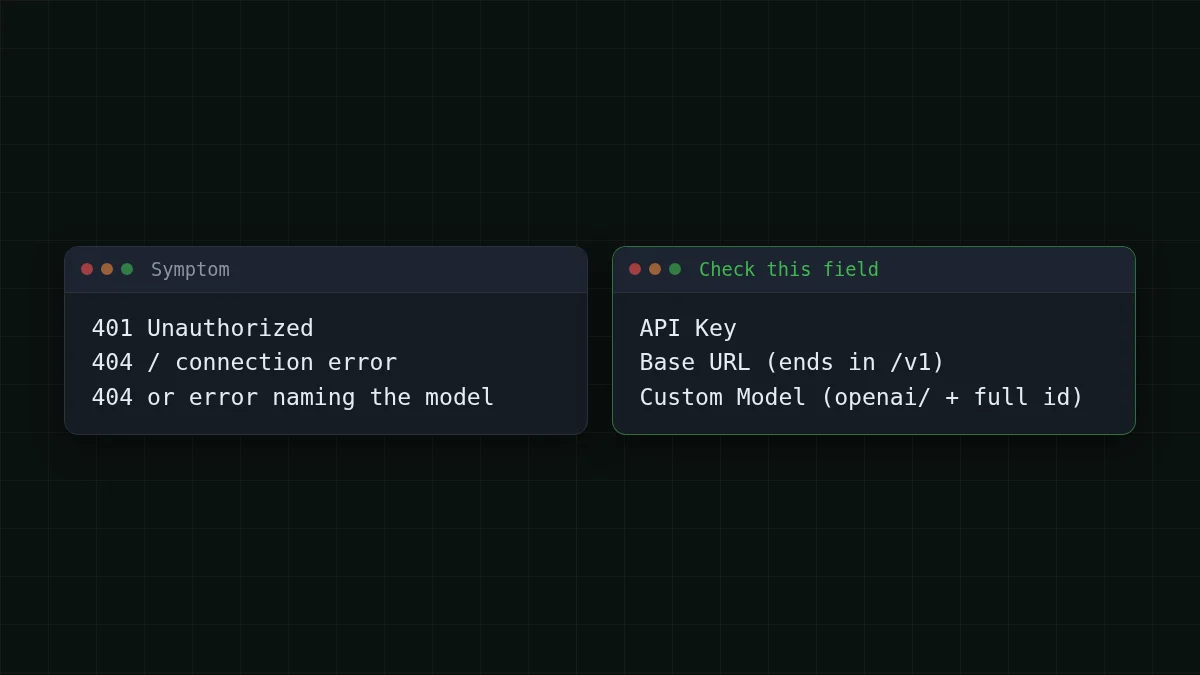
- 密钥错误。 API 返回 401——密钥缺失、输入错误,或复制时带了尾随空格。
- Base URL 错误。 请求发往了错误的位置,你会得到 404 或连接错误。地址必须以
/v1结尾,且不包含额外路径。 - 模型字符串错误。 要么缺少前缀,要么其后的 id 不是完整 id(API 只接受完整的
gateway_id,不接受像deepseek-这样的短 id)。v4- flash- 0731
关于 401 与 404 的完整推理见 API 401 or 404: wrong key, base URL or model id。
自己试试试一试:密钥正确,URL 正确,agent 仍在第一步失败。你会打开哪个字段?显示答案
Custom Model 字段。检查它以 openai/ 开头,并且其后的 id 与上表中的拼写完全一致。密钥和 URL 是容易用 curl 验证的部分。
一次会话的成本#
agent 在每一步都会为整个上下文计费,而不是只为你那一行任务计费。假设 OpenHands 处理一个 bug 用了 40 步,每步发送约 30,000 个 token,写回 1,500 个。在 DeepSeek-V4-Flash 上一步是 $0.0006;四十步的结果见下方,与其他模型和 OpenRouter 并列。
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 40 次请求 | OpenRouter,40 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0264 | $0.0452 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.024 | $0.0924 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.069 | $0.828 |
每次请求 30,000 个输入 token 和 1,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
总计,将输入和输出合并计算,对于此工作负载,DeepSeek-V4-Flash 比 OpenRouter 更便宜。这些假设由你自行调整:小修复可能只需 10 步,大重构则要 100 步。当前价格见定价页面,模型页面是cheap DeepSeek。
已经在用 OpenHands 搭配其他提供商?#
那么你只需替换三个值:Custom Model、Base URL、API Key。项目中的其他内容都不变,你也可以用同样的方式切回来。API 本身的分步连接说明见 CheapTokens docs;在其他工具中的类似设置见 connect Aider。


