模型与对比对比
Inkling 2 Small vs DeepSeek-V4.1-Flash:哪个模型更适合编码?
厂商的表格显示 DeepSeek-V4.1-Flash 在大多数编码行上领先。如何解读它、在你的仓库上运行 5 提示词检查并计算每任务成本。
简短回答:在 Thinking Machines 为 Inkling 2 Small 发布的表格中(发布日期为 2026 年 11 月 5 日,核查于 11 月 7 日),在同时列出两个模型成绩的六行编码任务中,DeepSeek-V4.1-Flash-1017 在五行上领先。Inkling 只在一行上领先,并且它在网页设计排名上表现很强。不过,这是厂商自己的表格,所以应把它当作在你的代码上做一次小规模验证的理由,而不是最终结论。
如果你看到过类似“Inkling 已接近 DeepSeek”的标题,并想知道是否该更换你的编码智能体,那么应该按这个顺序来:先读与你工作相符的行,看看表格无法展示的内容,用你自己的五个提示词跑一遍,再计算完成一个任务的实际成本。
Inkling 2 Small 是什么#
根据发布页面,Inkling 2 Small 是 Thinking Machines Lab 的第二代模型。它是一个混合专家(Mixture-of-Experts)模型,总参数为 594B,每个 token 激活 17B。它接受图像输入(不接受音频),并具有可变的努力程度设置。目前它运行在 Tinker 上,这是该实验室的无服务器推理服务,尚处于 Beta 阶段。
有两个细节容易被忽略。权重目前是闭源的:实验室计划在外部安全测试后“下周”以 Apache 2.0 许可证发布,并表示其他平台将在“未来几周”跟进。在文件真正发布之前,这只是一个计划,不是事实。还有上下文长度:Tinker 的模型列表显示最大为 256K。发布页面上的 512K 和 1M 数字是训练和评估设置,不是你今天可以发送的长度。
闪卡
本次对比中你会遇到的术语
点击卡片翻转
这里的日期比平时更重要,因为一半的承诺还只是计划:
时间线
Inkling 2 Small:厂商的说法与时间
- 2026 年 11 月 5 日发布页面上线,模型在 Tinker(Beta)上线
- “下周”计划在外部安全测试后以 Apache 2.0 发布开放权重
- “未来几周”在其他平台上线
逐行解读表格#
厂商将 Inkling 2 Small 与 DeepSeek-V4.1-Flash-1017 进行对比。DeepSeek 的文档称 deepseek-flash 别名现在由该版本提供服务(页面无日期,核查于 2026 年 11 月 7 日)。以下是两个模型都有数字的行。最后一列只是差值。
向右滚动表格 →
| 行 | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | 差距(百分点) |
|---|---|---|---|
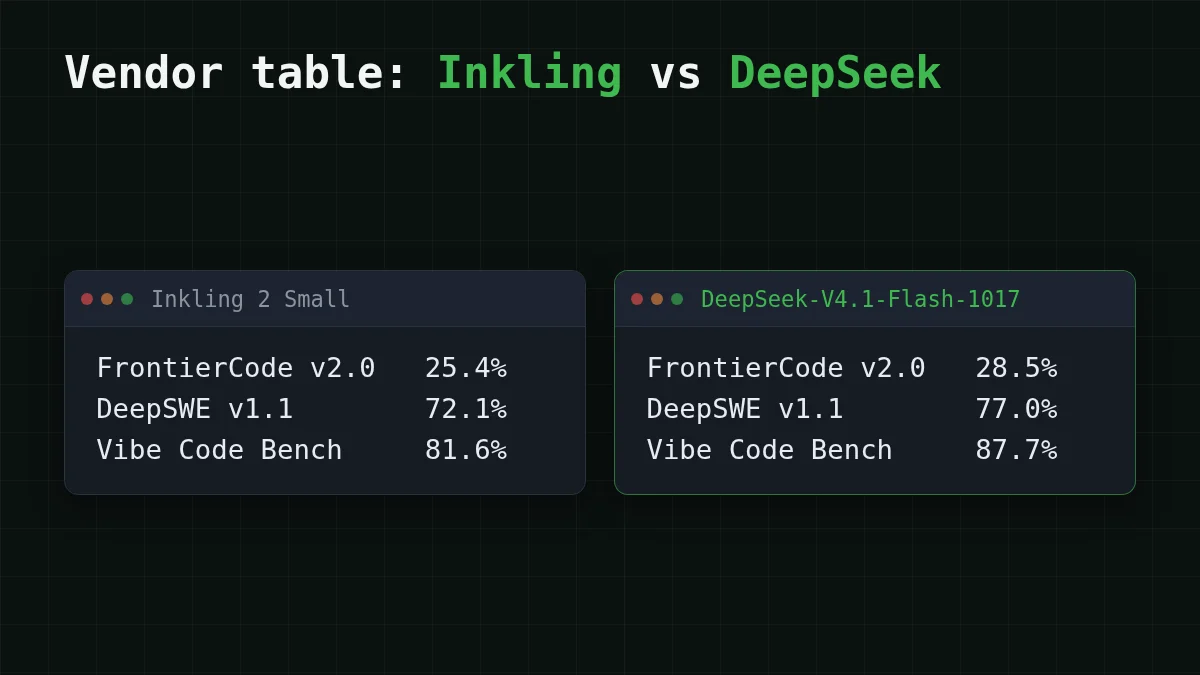
| FrontierCode v2.0 | 25.4% | 28.5% | DeepSeek +3.1 |
| DeepSWE v1.1 | 72.1% | 77.0% | DeepSeek +4.9 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% | DeepSeek +6.1 |
| Terminal Bench Science v0.1 | 5.7% | 12.9% | DeepSeek +7.2 |
| PostTrainBench v1.2 | 31.9% | 30.5% | Inkling +1.4 |
| PMPP-Hard (AUC) | 494.27 | 497.36 | DeepSeek +3.09 |
核对一下:77.0 - 72.1 = 4.9。数一下行数,DeepSeek 在五行上领先,Inkling 在一行上领先。
猜数字
在六行正面交锋中,DeepSeek-V4.1-Flash-1017 在多少行上领先?
你的猜测
06
显示答案
答案: 5
五行:FrontierCode、DeepSWE、Vibe Code Bench、Terminal Bench Science 和 PMPP-Hard。Inkling 仅在 PostTrainBench 上领先。
在向你的团队引用这张表之前,有几点需要注意。
- 最大的差距出现在最不成熟的行上。 Terminal Bench Science 的版本是 0.1,12.9% 对 5.7% 是两倍多。这是关于终端类工作的提示,不是定论。
- 有一行没有正面交锋。 SWEBench Pro v2 (Hard) 显示 Inkling 为 86.3%,DeepSeek 未报告。你无法将数字与空白进行比较。
- 小差距就是小。 在你从未运行过的基准上,1.4 或 3.1 个百分点的差距可能经不起更换仓库或提示词的考验。
- 页面有一处自相矛盾。 Artificial Analysis Intelligence Index 在正文中是 31,在表格中是 30.6(v5.0),没有解释。这是小事,但提醒你要读脚注。
这里的内容尚未经过独立复现;所有数字都来自 Inkling 厂商。
网页设计是另一行#
如果你的任务是生成网站而不是修复 bug,那么相关的数字是 DesignArena Website。在发布页面的 11 月 5 日快照中,Inkling 2 Small 得分为 1,340,排在 Muse Wonder(1,366)和 Muse Spark 1.3(1,351)之后,位列第三。厂商预计一旦权重发布,它将成为该榜单上排名最高的开放权重模型。与第一名的差距是 1,366 - 1,340 = 26 分。
这是一个由人们比较生成页面的排行榜,所以它确实反映了外观方面的一些真实情况。但页面没有给出 DeepSeek 在这一行上的数字,因此没有正面交锋可读。在依赖快照之前,请自行打开 DesignArena。
表格无法展示的内容#
假设你维护一个有着十年历史的 Django 单体应用,测试缓慢且有很多内部规则。由全新、整洁的仓库组成的基准几乎无法告诉你模型如何处理你那 3,000 行的 utils.py。任何厂商表格都缺少四样东西:
- 你的代码和你的习惯。 命名、测试风格、智能体绝不应触碰的文件。
- 智能体循环的行为方式。 同一个模型在一个工具中表现良好,在另一个工具中可能表现糟糕,因为工具向模型提供文件和错误的方式不同。
- 一个任务需要多少步。 一个每次尝试好 3 分但需要更多尝试的模型,对你来说不一定更好。
- 价格。 Inkling 的每 token 价格不在发布页面或 Tinker 模型列表中(核查于 2026 年 11 月 7 日)。查看 Tinker 的定价页面,并在你找到的任何信息旁标注日期。
如果你想更详细地了解如何阅读基准表格,有一篇单独的文章:如何阅读 AI 基准并运行 5 提示词测试。
在你自己的代码上做 5 提示词检查#
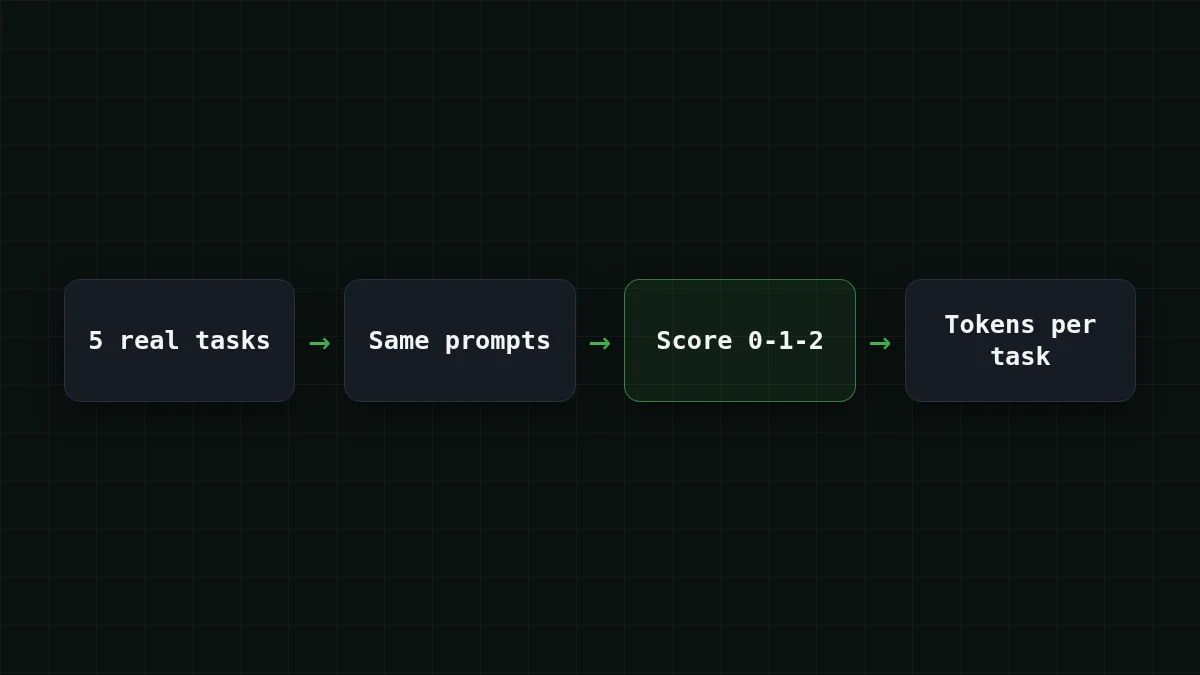
这需要一下午的时间,但对你的决策来说胜过任何排行榜。选择你过去两周实际做过的五个任务,每个任务都有判断答案是否正确的方法。将相同的文本发送给每个模型,并自己给结果打分。
清单
你的 5 提示词检查
对于可以通过 OpenAI 兼容 API 调用的模型,循环很短。将五个提示词放入 tasks.txt,用一行 ===== 分隔。阅读完整文档:CheapTokens 文档;地址是 https:/。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
你会看到五行 task number, input tokens, output tokens, finish_。stop 表示模型自行完成;length 表示 max_tokens 截断了答案。这里的模型 id 是完整 id:deepseek-。价格表中的短 id 无法使用。
CheapTokens 上的 DeepSeek-V4-Flash 具有 380K 上下文、单次回答最多 32,768 个 token、全天统一价格,并且还提供 Anthropic 兼容端点,因此同样的五个提示词也可以通过基于该格式构建的工具运行。来自你自己五个提示词的分数才是对你的仓库重要的分数。对于 Inkling 2 Small,通过 Tinker 发送同样的五个文本。
想在同一个天平上加入第三和第四个竞争者?GLM-5.3-Flash(zai-,390K 上下文)和 MiniMax-M2.7(MiniMaxAI/,180K 上下文)使用另一个 model 值进行同样的调用。如果你想了解 DeepSeek 模型在任务上与 MiniMax 的对比,有 MiniMax-M2.7 vs DeepSeek-V4-Flash。
每任务成本,而非每 token 成本#
每百万 token 的价格不是每个完成任务的成本。你支付的是步数乘以每步的 token 数,输入和输出一起计算。假设你的智能体在 20 步内解决一个 bug,每步发送约 30,000 个 token 的文件和历史,并得到约 1,500 个 token 的返回。DeepSeek-V4-Flash 上一步的成本是 $0.0006。整个任务,按实时价格计算:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 20 次请求 | OpenRouter,20 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
每次请求 30,000 个输入 token 和 1,500 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
该表还显示了 OpenRouter 的参考价格,总计(输入和输出一起计算),CheapTokens 上的 DeepSeek-V4-Flash 更便宜。每个模型的每 token 费率在定价页面上。
现在是对比中真正重要的点。如果模型 A 在 20 步内解决任务,而模型 B 需要 30 步,那么 30 / 20 = 1.5,所以在相同 token 价格下,B 的每任务成本是 A 的一倍半。基准上多出的几分很容易被额外的步数抵消,反之亦然。这就是为什么 5 提示词检查要记录 token:你会看到每任务的步数和 token,而不仅仅是一个分数。这个想法的详细版本在每 1M token 价格 vs 每任务成本。
将你自己的数字放入计算器。在下面的示例中,200 次运行是每天 10 个任务,每个任务 20 步;将每步 token 数改为你的检查显示的数字。
成本计算器
编码智能体的一天:10 个任务,每个 20 步
每次请求的输入 token 数: 30,000 · 每次请求的输出 token 数: 1,500 · 每日请求数: 200
| 模型 | 每天 | 每月 |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
该选哪个#
在真实仓库上使用编码智能体。 在厂商自己的编码行上,DeepSeek-V4.1-Flash-1017 在大多数行上领先。从 DeepSeek-V4-Flash(id 见上方代码)开始检查,并将 Inkling 加入同样的五个提示词。只有当 Inkling 在你的任务上获胜时才切换,而不是在厂商的任务上。如果你想了解 DeepSeek 发布本身的背景,请参阅 deepseek-flash 有哪些变化。
网站和前端生成。 Inkling 的 DesignArena Website 排名是发布中最强的声明。在两个模型上运行两三个你自己的页面提示词,看页面本身,而不是数字。
以后自托管。 Inkling 是有开放权重计划的模型,采用 Apache 2.0。在文件存在之前,它只是一个计划。在围绕它构建任何东西之前,再次查看发布页面,同时你可以用 CheapTokens 上的 DeepSeek 对托管模型运行相同的提示词。
再给一个提示,如果你按任务做决定:保留五个提示词和评分表。下次厂商发布表格时,你可以在一个小时内重新运行检查,而不是再次阅读排名。


