Modelos e comparaçõesComparação
Inkling 2 Small vs DeepSeek-V4.1-Flash: qual modelo para código?
A tabela do fornecedor coloca o DeepSeek-V4.1-Flash à frente na maioria das linhas de código. Como lê-la, rodar um teste de 5 prompts no seu repositório e contar o custo por tarefa.
Nesta página
Resposta curta: na tabela que a Thinking Machines publicou para o Inkling 2 Small (página de lançamento de 5 de novembro de 2026, verificada em 7 de novembro), o DeepSeek-V4.1-Flash-1017 está à frente em cinco das seis linhas de código que mostram os dois modelos. O Inkling lidera em uma, e tem um bom ranking em web design. Mas essa é a tabela do próprio fornecedor, então trate-a como motivo para fazer uma verificação pequena no seu código, não como veredito.
Se você viu uma manchete do tipo "Inkling está perto do DeepSeek" e ficou na dúvida se troca seu agente de código, esta é a ordem a seguir: leia as linhas que batem com o seu trabalho, veja o que a tabela não consegue mostrar, rode cinco prompts seus e coloque um custo em uma tarefa concluída.
O que é o Inkling 2 Small#
Segundo a página de lançamento, o Inkling 2 Small é o modelo de segunda geração do Thinking Machines Lab. É um modelo Mixture-of-Experts com 594B parâmetros no total e 17B ativos por token. Aceita imagens (não áudio) e tem um ajuste de esforço variável. No momento, roda no Tinker, o serviço de inferência serverless do laboratório, que está em Beta.
Dois detalhes passam fácil. Os pesos estão fechados por enquanto: o laboratório planeja liberá-los sob Apache 2.0 "na próxima semana" após testes externos de segurança, e diz que outras plataformas virão "nas próximas semanas". Isso é um plano, não um fato, até os arquivos saírem de verdade. E o contexto: a lista de modelos do Tinker mostra 256K como máximo. Os números de 512K e 1M na página de lançamento são configurações de treino e avaliação, não o que você pode enviar hoje.
Flashcards
Palavras que você vai encontrar nesta comparação
Toque num cartão para virar
As datas importam mais que o normal aqui, porque metade da oferta é uma promessa:
Linha do tempo
Inkling 2 Small: o que o fornecedor diz e quando
- 5 nov 2026página de lançamento publicada, modelo no ar no Tinker (Beta)
- "Próxima semana"lançamento planejado de pesos abertos sob Apache 2.0, após testes externos de segurança
- "Próximas semanas"disponibilidade em outras plataformas
Lendo a tabela linha por linha#
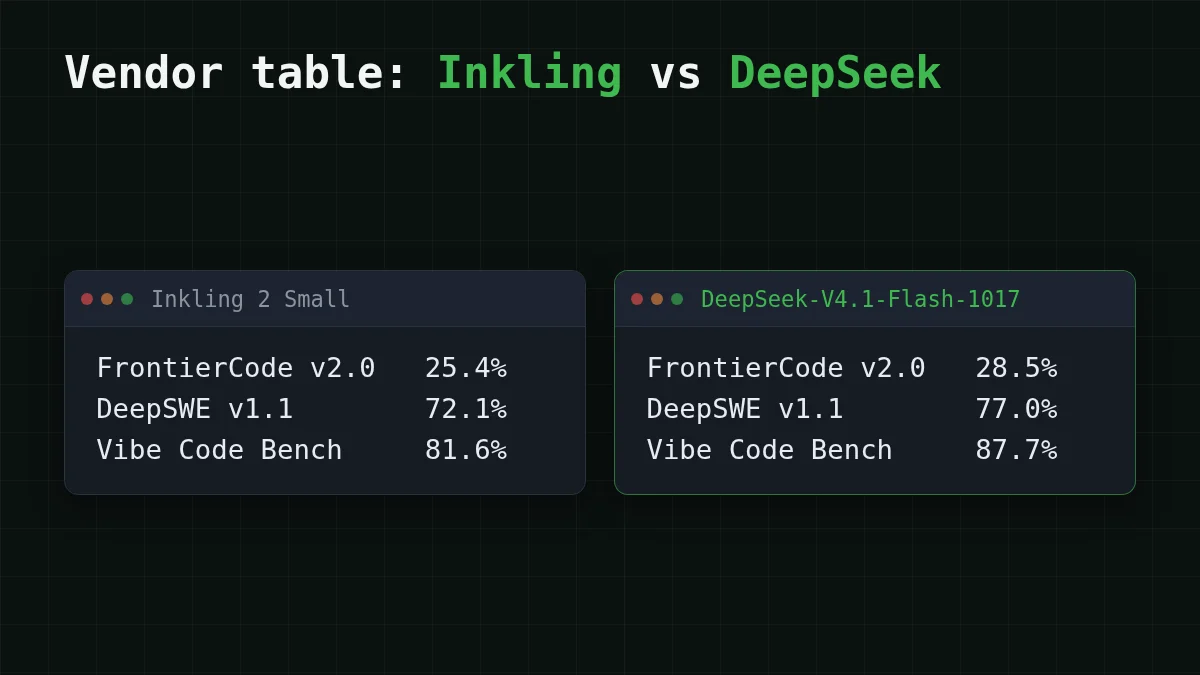
O fornecedor compara o Inkling 2 Small com o DeepSeek-V4.1-Flash-1017. A documentação do DeepSeek diz que o alias deepseek-flash agora é servido por essa versão (a página não tem data, verificada em 7 de novembro de 2026). Aqui estão as linhas em que os dois modelos têm um número. A última coluna é só a subtração.
Role a tabela para a direita →
| Linha | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | Diferença, pontos |
|---|---|---|---|
| FrontierCode v2.0 | 25,4% | 28,5% | DeepSeek +3,1 |
| DeepSWE v1.1 | 72,1% | 77,0% | DeepSeek +4,9 |
| Vibe Code Bench v1.1 | 81,6% | 87,7% | DeepSeek +6,1 |
| Terminal Bench Science v0.1 | 5,7% | 12,9% | DeepSeek +7,2 |
| PostTrainBench v1.2 | 31,9% | 30,5% | Inkling +1,4 |
| PMPP-Hard (AUC) | 494,27 | 497,36 | DeepSeek +3,09 |
Confira uma: 77,0 - 72,1 = 4,9. Conte as linhas e o DeepSeek está à frente em cinco, o Inkling em uma.
Adivinhar o número
Em quantas das seis linhas de confronto direto o DeepSeek-V4.1-Flash-1017 está à frente?
O seu palpite
06
Mostrar resposta
Resposta: 5
Cinco: FrontierCode, DeepSWE, Vibe Code Bench, Terminal Bench Science e PMPP-Hard. O Inkling está à frente apenas no PostTrainBench.
Algumas coisas para notar antes de citar esta tabela para o seu time.
- A maior diferença está na linha menos madura. Terminal Bench Science está na versão 0.1, e 12,9% contra 5,7% é mais que o dobro. É uma pista sobre trabalho no estilo terminal, não uma sentença.
- Uma linha não tem confronto direto. SWEBench Pro v2 (Hard) mostra o Inkling em 86,3% e o DeepSeek como não reportado. Você não pode comparar um número com um espaço em branco.
- Diferenças pequenas são pequenas. Uma diferença de 1,4 ou 3,1 pontos em um benchmark que você nunca rodou pode não sobreviver a uma troca de repositório ou de prompt.
- A página se contradiz uma vez. O Artificial Analysis Intelligence Index é 31 no texto e 30,6 (v5.0) na tabela, sem explicação. É um detalhe menor, mas é um lembrete para ler as notas de rodapé.
Nada aqui foi replicado de forma independente ainda; todos os números vêm do fornecedor do Inkling.
Web design é outra linha#
Se a sua tarefa é gerar sites em vez de corrigir bugs, o número relevante é o DesignArena Website. No snapshot de 5 de novembro na página de lançamento, o Inkling 2 Small marcou 1.340, terceiro atrás de Muse Wonder (1.366) e Muse Spark 1.3 (1.351). O fornecedor espera que ele seja o melhor modelo de pesos abertos ali quando os pesos saírem. A diferença para o primeiro lugar é 1.366 - 1.340 = 26 pontos.
Esse é um leaderboard de pessoas comparando páginas geradas, então diz algo real sobre aparência. Mas a página não dá número do DeepSeek para essa linha, então não há confronto direto para ler. Abra o próprio DesignArena antes de confiar no snapshot.
O que nenhuma tabela consegue mostrar#
Digamos que você mantém um monólito Django de dez anos, com testes lentos e muitas regras da casa. Um benchmark feito de repositórios novos e arrumados diz pouco sobre como um modelo lida com o seu utils.py de 3.000 linhas. Quatro coisas faltam em qualquer tabela de fornecedor:
- Seu código e seus hábitos. Nomenclatura, estilo de teste, quais arquivos o agente nunca deve tocar.
- Como o loop do agente se comporta. O mesmo modelo pode ir bem em uma ferramenta e mal em outra, porque as ferramentas diferem na forma como alimentam arquivos e erros.
- Quantos passos uma tarefa leva. Um modelo que é 3 pontos melhor por tentativa mas precisa de mais tentativas não é necessariamente melhor para você.
- Preço. O preço por token do Inkling não está na página de lançamento nem na lista de modelos do Tinker (verificado em 7 de novembro de 2026). Olhe a página de preços do Tinker e coloque a data ao lado do que encontrar.
Se você quer um guia mais longo sobre como ler tabelas de benchmark, há um artigo separado: como ler um benchmark de IA e rodar um teste de 5 prompts.
O teste de 5 prompts no seu próprio código#
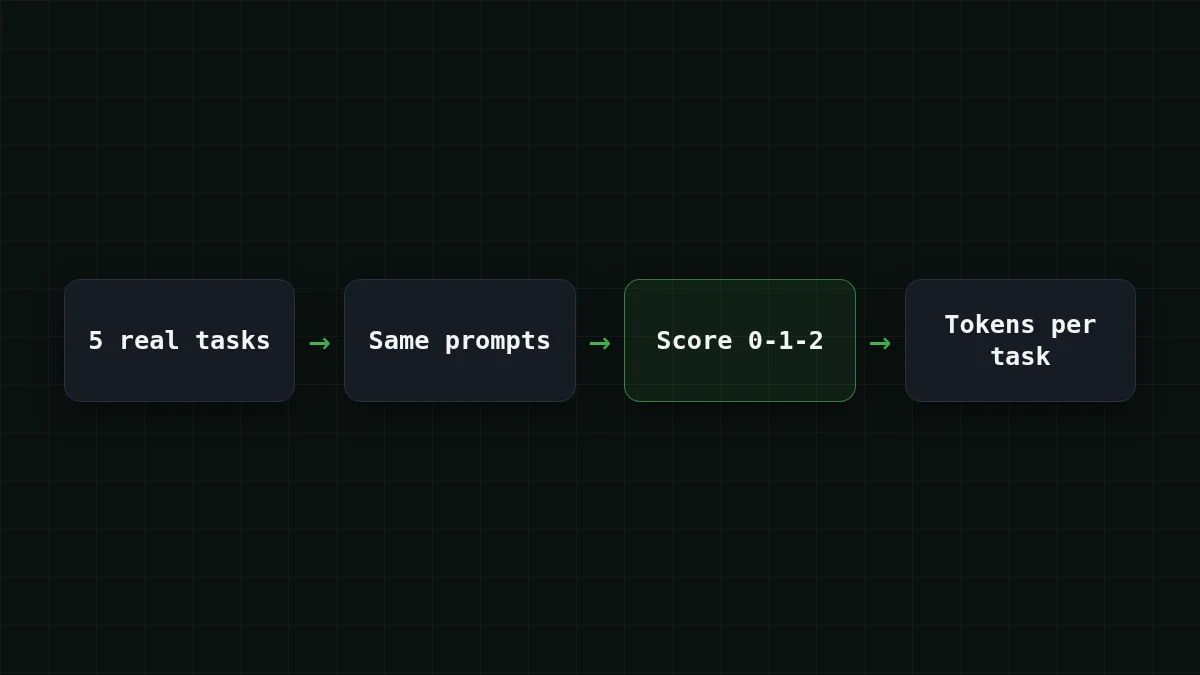
Isso leva uma tarde e vence qualquer leaderboard para a sua decisão. Escolha cinco tarefas que você realmente fez nas últimas duas semanas, cada uma com uma forma de saber se a resposta está certa. Envie o mesmo texto para cada modelo e pontue o resultado você mesmo.
Lista de verificação
Seu teste de 5 prompts
Para os modelos que você pode chamar por uma API compatível com OpenAI, o loop é curto. Coloque os cinco prompts em tasks.txt, separados por uma linha com =====. Leia a documentação completa em CheapTokens docs; o endereço é https:/.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
O que você vai ver são cinco linhas de task number, input tokens, output tokens, finish_. stop significa que o modelo terminou sozinho; length significa que max_tokens cortou a resposta. O id do modelo aqui é o completo: deepseek-. Um id curto de uma tabela de preços não vai funcionar.
O DeepSeek-V4-Flash no CheapTokens tem contexto de 380K, até 32.768 tokens em uma resposta, um preço a qualquer hora do dia e também um endpoint compatível com Anthropic, então os mesmos cinco prompts também rodam por ferramentas construídas nesse formato. As pontuações dos seus próprios cinco prompts são as que importam para o seu repositório. Para o Inkling 2 Small, envie os mesmos cinco textos pelo Tinker.
Quer um terceiro e um quarto concorrente no mesmo equilíbrio? GLM-5.3-Flash (zai-, contexto de 390K) e MiniMax-M2.7 (MiniMaxAI/, contexto de 180K) aceitam a mesma chamada com outro valor de model. Se você quer ver como o modelo DeepSeek se compara com o MiniMax em tarefas, há MiniMax-M2.7 vs DeepSeek-V4-Flash.
Custo por tarefa, não por token#
Um preço por milhão de tokens não é um preço por tarefa concluída. O que você paga é o número de passos vezes os tokens em cada passo, entrada e saída contadas juntas. Digamos que seu agente resolve um bug em 20 passos, e cada passo envia cerca de 30.000 tokens de arquivos e histórico e recebe cerca de 1.500 tokens de volta. Um passo no DeepSeek-V4-Flash custa $0.0006. A tarefa inteira, com preços ao vivo:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 20 solicitações | OpenRouter, 20 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
30.000 tokens de entrada e 1.500 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
Essa tabela também mostra o preço de referência do OpenRouter, e no total, com entrada e saída contadas juntas, o DeepSeek-V4-Flash no CheapTokens sai mais barato. As tarifas por token de todos os modelos estão na página de preços.
Agora o ponto que importa para a comparação. Se o modelo A resolve a tarefa em 20 passos e o modelo B precisa de 30, então 30 / 20 = 1,5, ou seja, B custa uma vez e meia mais por tarefa com o mesmo preço por token. Alguns pontos extras em um benchmark podem facilmente ser engolidos por passos extras, e vice-versa. É por isso que o teste de 5 prompts registra tokens: você vai ver passos e tokens por tarefa, não só uma pontuação. A versão mais longa dessa ideia está em preço por 1M de tokens vs custo por tarefa.
Coloque seus próprios números na calculadora. No exemplo abaixo, 200 execuções são 10 tarefas por dia a 20 passos cada; mude os tokens por passo para o que o seu teste mostrou.
Calculadora de custos
Um dia de um agente de código: 10 tarefas, 20 passos cada
Tokens de entrada por solicitação: 30.000 · Tokens de saída por solicitação: 1.500 · Solicitações por dia: 200
| Modelo | Por dia | Por mês |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
Qual escolher#
Um agente de código em um repositório real. Nas próprias linhas de código do fornecedor, o DeepSeek-V4.1-Flash-1017 está à frente na maioria. Comece o teste com o DeepSeek-V4-Flash (id no código acima) e adicione o Inkling aos mesmos cinco prompts. Troque só se o Inkling vencer nas suas tarefas, não nas do fornecedor. Se você quer o contexto do lançamento do DeepSeek em si, veja o que mudou no deepseek-flash.
Sites e geração de front-end. O ranking do Inkling no DesignArena Website é a alegação mais forte do lançamento. Rode dois ou três prompts de página seus nos dois modelos e olhe as páginas, não os números.
Auto-hospedagem depois. O Inkling é o que tem um plano de pesos abertos, sob Apache 2.0. Até os arquivos existirem, é um plano. Verifique a página de lançamento de novo antes de construir qualquer coisa em cima disso, e enquanto isso você pode rodar os mesmos prompts contra um modelo hospedado com DeepSeek no CheapTokens.
Mais uma dica, se você decide por tarefas: guarde os cinco prompts e a planilha de pontuação. Na próxima vez que um fornecedor publicar uma tabela, você refaz o teste em uma hora em vez de ler rankings de novo.


