Modelle & VergleicheVergleich
Inkling 2 Small vs. DeepSeek-V4.1-Flash: Welches Modell fürs Coding?
Die Tabelle des Anbieters setzt DeepSeek-V4.1-Flash in den meisten Coding-Zeilen vorn. Wie man sie liest, einen 5-Prompt-Test auf deinem Repo ausführt und die Kosten pro Aufgabe berechnet.
Auf dieser Seite
Kurze Antwort: In der Tabelle, die Thinking Machines für Inkling 2 Small veröffentlicht hat (Release-Seite vom 5. November 2026, geprüft am 7. November), liegt DeepSeek-V4.1-Flash-1017 in fünf der sechs Coding-Zeilen vorn, in denen beide Modelle aufgeführt sind. Inkling führt in einer Zeile und hat einen starken Webdesign-Rang. Das ist jedoch die Tabelle des Anbieters selbst, also betrachte sie als Grund für einen kleinen Test mit deinem Code, nicht als Urteil.
Wenn du eine Schlagzeile wie „Inkling ist nah an DeepSeek“ gesehen hast und dich gefragt hast, ob du deinen Coding-Agenten wechseln solltest, ist das die richtige Reihenfolge: Lies die Zeilen, die zu deiner Arbeit passen, sieh dir an, was die Tabelle nicht zeigen kann, führe fünf eigene Prompts aus und berechne die Kosten für eine abgeschlossene Aufgabe.
Was Inkling 2 Small ist#
Laut der Release-Seite ist Inkling 2 Small das Modell der zweiten Generation von Thinking Machines Lab. Es ist ein Mixture-of-Experts-Modell mit insgesamt 594B Parametern und 17B aktiven pro Token. Es akzeptiert Bilder (kein Audio) und hat eine variable Effort-Einstellung. Derzeit läuft es auf Tinker, dem serverlosen Inferenzdienst des Labs, der sich in der Beta befindet.
Zwei Details sind leicht zu übersehen. Die Gewichte sind vorerst geschlossen: Das Lab plant, sie „nächste Woche“ nach externen Sicherheitstests unter Apache 2.0 zu veröffentlichen, und sagt, andere Plattformen werden „in den kommenden Wochen“ folgen. Das ist ein Plan, keine Tatsache, bis die Dateien tatsächlich draußen sind. Und der Kontext: Die Tinker-Modellliste zeigt 256K als Maximum. Die 512K- und 1M-Angaben auf der Release-Seite sind Trainings- und Evaluierungseinstellungen, nicht das, was du heute senden kannst.
Lernkarten
Begriffe, die dir in diesem Vergleich begegnen
Tippe auf eine Karte, um sie umzudrehen
Die Daten sind hier wichtiger als sonst, denn die Hälfte des Angebots ist ein Versprechen:
Zeitstrahl
Inkling 2 Small: Was der Anbieter sagt und wann
- 5. Nov. 2026Release-Seite veröffentlicht, Modell live auf Tinker (Beta)
- „Nächste Woche“geplante Veröffentlichung der offenen Gewichte unter Apache 2.0, nach externen Sicherheitstests
- „Kommende Wochen“Verfügbarkeit auf anderen Plattformen
Die Tabelle Zeile für Zeile lesen#
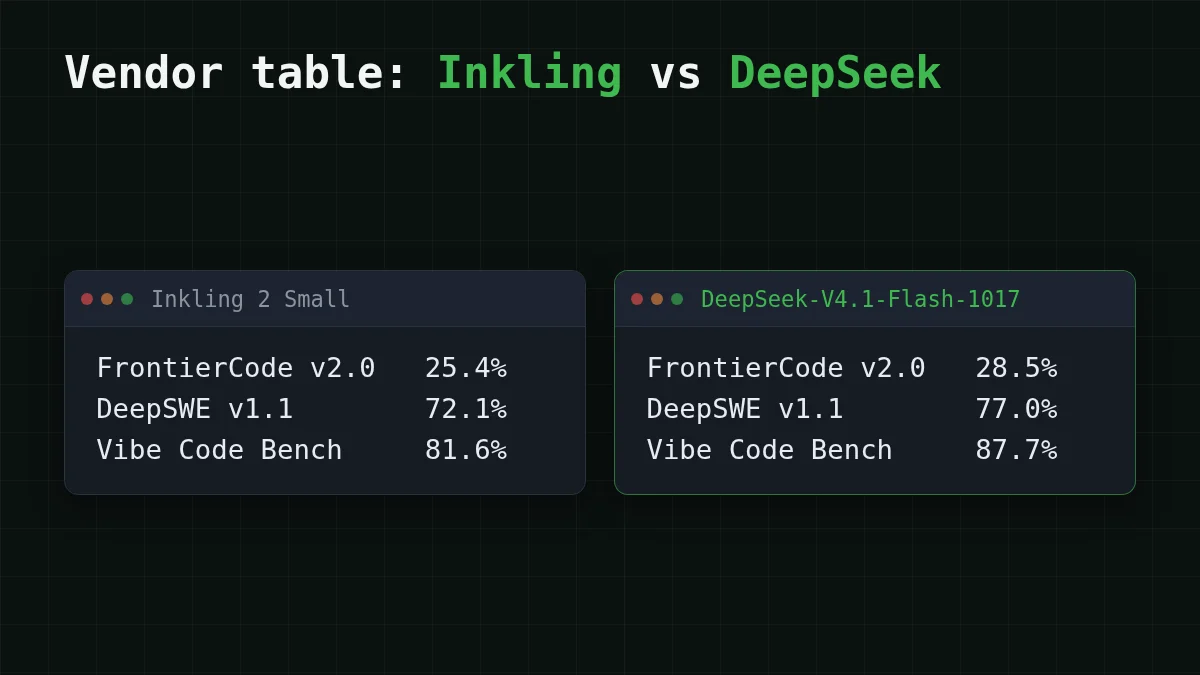
Der Anbieter vergleicht Inkling 2 Small mit DeepSeek-V4.1-Flash-1017. Die DeepSeek-Dokumentation besagt, dass der Alias deepseek-flash jetzt von dieser Version bedient wird (Seite ohne Datum, geprüft am 7. November 2026). Hier sind die Zeilen, in denen beide Modelle einen Wert haben. Die letzte Spalte ist nur die Subtraktion.
Tabelle nach rechts scrollen →
| Zeile | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | Differenz, Punkte |
|---|---|---|---|
| FrontierCode v2.0 | 25,4 % | 28,5 % | DeepSeek +3,1 |
| DeepSWE v1.1 | 72,1 % | 77,0 % | DeepSeek +4,9 |
| Vibe Code Bench v1.1 | 81,6 % | 87,7 % | DeepSeek +6,1 |
| Terminal Bench Science v0.1 | 5,7 % | 12,9 % | DeepSeek +7,2 |
| PostTrainBench v1.2 | 31,9 % | 30,5 % | Inkling +1,4 |
| PMPP-Hard (AUC) | 494,27 | 497,36 | DeepSeek +3,09 |
Prüfung eins: 77,0 - 72,1 = 4,9. Zähle die Zeilen, und DeepSeek liegt in fünf vorn, Inkling in einer.
Zahl erraten
In wie vielen der sechs direkten Vergleichszeilen liegt DeepSeek-V4.1-Flash-1017 vorn?
Deine Schätzung
06
Antwort anzeigen
Antwort: 5
Fünf: FrontierCode, DeepSWE, Vibe Code Bench, Terminal Bench Science und PMPP-Hard. Inkling liegt nur bei PostTrainBench vorn.
Ein paar Dinge solltest du beachten, bevor du diese Tabelle deinem Team zitierst.
- Die größte Lücke liegt in der am wenigsten ausgereiften Zeile. Terminal Bench Science ist bei Version 0.1, und 12,9 % gegenüber 5,7 % ist mehr als das Doppelte. Es ist ein Hinweis auf terminalartige Arbeit, kein Urteil.
- Eine Zeile hat keinen direkten Vergleich. SWEBench Pro v2 (Hard) zeigt Inkling bei 86,3 % und DeepSeek als nicht berichtet. Du kannst eine Zahl nicht mit einem leeren Feld vergleichen.
- Kleine Lücken sind klein. Eine Lücke von 1,4 oder 3,1 Punkten in einem Benchmark, den du nie ausgeführt hast, übersteht möglicherweise keinen Wechsel des Repos oder Prompts.
- Die Seite widerspricht sich einmal. Der Artificial Analysis Intelligence Index ist im Text 31 und in der Tabelle 30,6 (v5.0), ohne Erklärung. Es ist eine Kleinigkeit, aber eine Erinnerung, Fußnoten zu lesen.
Nichts davon ist bisher unabhängig repliziert; alle Zahlen stammen vom Inkling-Anbieter.
Webdesign ist eine andere Zeile#
Wenn deine Aufgabe darin besteht, Websites zu generieren, statt Bugs zu beheben, ist die relevante Zahl DesignArena Website. Im Snapshot vom 5. November auf der Release-Seite erzielte Inkling 2 Small 1.340 Punkte und lag damit auf Platz drei hinter Muse Wonder (1.366) und Muse Spark 1.3 (1.351). Der Anbieter erwartet, dass es dort das beste Modell mit offenen Gewichten sein wird, sobald die Gewichte draußen sind. Die Lücke zum ersten Platz beträgt 1.366 - 1.340 = 26 Punkte.
Das ist ein Leaderboard, in dem Leute generierte Seiten vergleichen, es sagt also etwas Echtes über das Aussehen aus. Aber die Seite gibt für diese Zeile keine DeepSeek-Zahl an, es gibt also keinen direkten Vergleich. Öffne DesignArena selbst, bevor du dich auf den Snapshot verlässt.
Was keine Tabelle zeigen kann#
Angenommen, du pflegst einen zehn Jahre alten Django-Monolithen mit langsamen Tests und vielen Hausregeln. Ein Benchmark aus frischen, aufgeräumten Repos sagt dir wenig darüber, wie ein Modell mit deiner utils.py mit 3.000 Zeilen umgeht. Vier Dinge fehlen in jeder Anbietertabelle:
- Dein Code und deine Gewohnheiten. Benennung, Teststil, welche Dateien der Agent niemals anfassen sollte.
- Wie sich die Agentenschleife verhält. Dasselbe Modell kann in einem Tool gut und in einem anderen schlecht abschneiden, weil sich die Tools darin unterscheiden, wie sie ihm Dateien und Fehler zuführen.
- Wie viele Schritte eine Aufgabe braucht. Ein Modell, das pro Versuch 3 Punkte besser ist, aber mehr Versuche braucht, ist für dich nicht unbedingt besser.
- Preis. Der Preis pro Token von Inkling steht weder auf der Release-Seite noch in der Tinker-Modellliste (geprüft am 7. November 2026). Sieh dir die Preisseite von Tinker an und schreibe das Datum neben das, was du findest.
Wenn du eine längere Anleitung zum Lesen von Benchmark-Tabellen möchtest, gibt es einen separaten Beitrag: how to read an AI benchmark and run a 5-prompt test.
Der 5-Prompt-Test mit deinem eigenen Code#
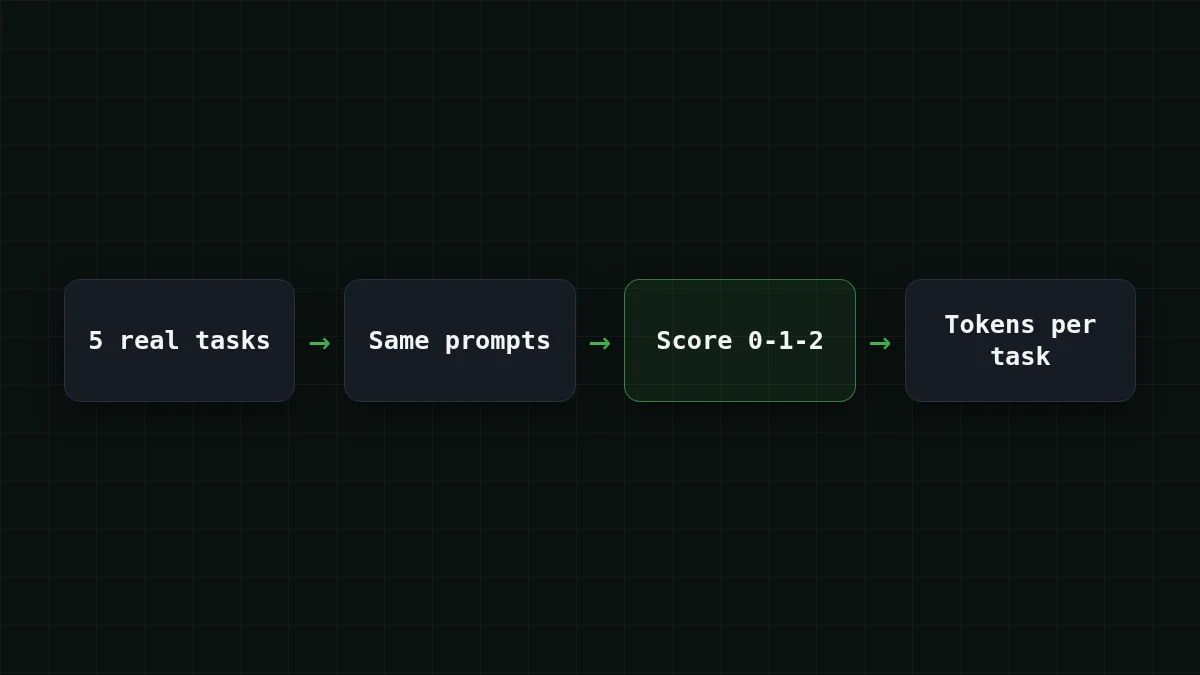
Das dauert einen Nachmittag und schlägt für deine Entscheidung jedes Leaderboard. Wähle fünf Aufgaben, die du in den letzten zwei Wochen tatsächlich erledigt hast, jede mit einer Möglichkeit festzustellen, ob die Antwort richtig ist. Sende denselben Text an jedes Modell und bewerte das Ergebnis selbst.
Checkliste
Dein 5-Prompt-Test
Für die Modelle, die du über eine OpenAI-kompatible API aufrufen kannst, ist die Schleife kurz. Lege die fünf Prompts in tasks.txt ab, getrennt durch eine Zeile mit =====. Die vollständige Dokumentation findest du in CheapTokens docs; die Adresse ist https:/.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
Was du sehen wirst, sind fünf Zeilen mit task number, input tokens, output tokens, finish_. stop bedeutet, dass das Modell von selbst fertig wurde; length bedeutet, dass max_tokens die Antwort abgeschnitten hat. Die Modell-ID hier ist die vollständige: deepseek-. Eine kurze ID aus einer Preistabelle funktioniert nicht.
DeepSeek-V4-Flash auf CheapTokens hat einen 380K-Kontext, bis zu 32.768 Token in einer Antwort, einen Preis zu jeder Tageszeit und zusätzlich einen Anthropic-kompatiblen Endpunkt, sodass dieselben fünf Prompts auch durch Tools laufen, die auf diesem Format aufbauen. Die Ergebnisse deiner eigenen fünf Prompts sind die, die für dein Repo zählen. Für Inkling 2 Small sende dieselben fünf Texte durch Tinker.
Möchtest du einen dritten und vierten Kandidaten auf derselben Waage? GLM-5.3-Flash (zai-, 390K Kontext) und MiniMax-M2.7 (MiniMaxAI/, 180K Kontext) nehmen denselben Aufruf mit einem anderen model-Wert. Wenn du sehen möchtest, wie das DeepSeek-Modell bei Aufgaben im Vergleich zu MiniMax abschneidet, gibt es MiniMax-M2.7 vs DeepSeek-V4-Flash.
Kosten pro Aufgabe, nicht pro Token#
Ein Preis pro Million Token ist kein Preis pro abgeschlossener Aufgabe. Was du zahlst, ist die Anzahl der Schritte mal die Token in jedem Schritt, Eingabe und Ausgabe zusammengerechnet. Angenommen, dein Agent löst einen Bug in 20 Schritten, und jeder Schritt sendet etwa 30.000 Token an Dateien und Verlauf und bekommt etwa 1.500 Token zurück. Ein Schritt auf DeepSeek-V4-Flash kostet $0.0006. Die ganze Aufgabe, zu Live-Preisen:
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 20 Anfragen | OpenRouter, 20 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
30.000 Input- und 1.500 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Diese Tabelle zeigt auch den Referenzpreis von OpenRouter, und insgesamt, mit Eingabe und Ausgabe zusammengerechnet, ist DeepSeek-V4-Flash auf CheapTokens günstiger. Die Preise pro Token für jedes Modell stehen auf der pricing page.
Nun der Punkt, der für den Vergleich zählt. Wenn Modell A die Aufgabe in 20 Schritten löst und Modell B 30 braucht, dann ist 30 / 20 = 1,5, also kostet B pro Aufgabe das Eineinhalbfache bei gleichem Tokenpreis. Ein paar zusätzliche Punkte in einem Benchmark können leicht durch zusätzliche Schritte aufgefressen werden, und umgekehrt. Deshalb zeichnet der 5-Prompt-Test Token auf: Du siehst Schritte und Token pro Aufgabe, nicht nur eine Punktzahl. Die längere Version dieser Idee steht in price per 1M tokens vs cost per task.
Setze deine eigenen Zahlen in den Rechner ein. Im folgenden Beispiel sind 200 Läufe 10 Aufgaben pro Tag bei je 20 Schritten; ändere die Token pro Schritt auf das, was dein Test gezeigt hat.
Kostenrechner
Ein Tag eines Coding-Agenten: 10 Aufgaben, je 20 Schritte
Eingabe-Tokens pro Anfrage: 30.000 · Ausgabe-Tokens pro Anfrage: 1.500 · Anfragen pro Tag: 200
| Modell | Pro Tag | Pro Monat |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
Was du wählen solltest#
Ein Coding-Agent auf einem echten Repo. In den Coding-Zeilen des Anbieters selbst liegt DeepSeek-V4.1-Flash-1017 in den meisten vorn. Beginne den Test mit DeepSeek-V4-Flash (ID im Code oben) und füge Inkling zu denselben fünf Prompts hinzu. Wechsle nur, wenn Inkling bei deinen Aufgaben gewinnt, nicht bei denen des Anbieters. Wenn du den Hintergrund zum DeepSeek-Release selbst möchtest, siehe what changed in deepseek-flash.
Websites und Frontend-Generierung. Inklings DesignArena-Website-Rang ist die stärkste Behauptung im Release. Führe zwei oder drei deiner eigenen Seiten-Prompts auf beiden Modellen aus und sieh dir die Seiten an, nicht die Zahlen.
Späteres Self-Hosting. Inkling ist das Modell mit einem Plan für offene Gewichte, unter Apache 2.0. Bis die Dateien existieren, ist es ein Plan. Prüfe die Release-Seite erneut, bevor du etwas darauf aufbaust, und in der Zwischenzeit kannst du dieselben Prompts gegen ein gehostetes Modell mit DeepSeek on CheapTokens ausführen.
Noch ein Tipp, wenn du nach Aufgaben entscheidest: Behalte die fünf Prompts und das Bewertungsblatt. Wenn ein Anbieter das nächste Mal eine Tabelle veröffentlicht, führst du den Test in einer Stunde erneut aus, statt wieder Ranglisten zu lesen.


