Modèles & comparaisonsComparaison
Inkling 2 Small vs DeepSeek-V4.1-Flash : quel modèle pour coder ?
Le tableau du fournisseur place DeepSeek-V4.1-Flash en tête sur la plupart des lignes de codage. Comment le lire, lancer un test à 5 prompts sur votre dépôt et calculer le coût par tâche.
Sur cette page
Réponse courte : dans le tableau publié par Thinking Machines pour Inkling 2 Small (page de publication du 5 novembre 2026, vérifiée le 7 novembre), DeepSeek-V4.1-Flash-1017 est en tête sur cinq des six lignes de codage qui affichent les deux modèles. Inkling mène sur une seule, et il a un bon classement en conception web. Mais c'est le tableau du fournisseur lui-même, alors traitez-le comme une raison de faire une petite vérification sur votre code, pas comme un verdict.
Si vous avez vu un titre du genre « Inkling est proche de DeepSeek » et vous vous êtes demandé s'il fallait changer d'agent de codage, voici l'ordre à suivre : lisez les lignes qui correspondent à votre travail, voyez ce que le tableau ne peut pas montrer, lancez cinq prompts de votre cru, et chiffrez le coût d'une tâche terminée.
Ce qu'est Inkling 2 Small#
Selon la page de publication, Inkling 2 Small est le modèle de deuxième génération de Thinking Machines Lab. C'est un modèle Mixture-of-Experts avec 594B paramètres au total et 17B actifs par token. Il accepte les images (pas l'audio) et dispose d'un réglage d'effort variable. Pour l'instant, il tourne sur Tinker, le service d'inférence serverless du laboratoire, qui est en Beta.
Deux détails sont faciles à manquer. Les poids sont fermés pour l'instant : le laboratoire prévoit de les publier sous Apache 2.0 « la semaine prochaine » après des tests de sécurité externes, et annonce que d'autres plateformes suivront « dans les semaines à venir ». C'est un plan, pas un fait, tant que les fichiers ne sont pas réellement sortis. Et le contexte : la liste des modèles Tinker indique 256K comme maximum. Les chiffres de 512K et 1M sur la page de publication sont des réglages d'entraînement et d'évaluation, pas ce que vous pouvez envoyer aujourd'hui.
Cartes mémo
Mots que vous rencontrerez dans cette comparaison
Touchez une carte pour la retourner
Les dates comptent plus que d'habitude ici, car la moitié de l'offre est une promesse :
Chronologie
Inkling 2 Small : ce que dit le fournisseur et quand
- 5 nov. 2026page de publication publiée, modèle en ligne sur Tinker (Beta)
- « La semaine prochaine »publication prévue des poids ouverts sous Apache 2.0, après tests de sécurité externes
- « Dans les semaines à venir »disponibilité sur d'autres plateformes
Lire le tableau ligne par ligne#
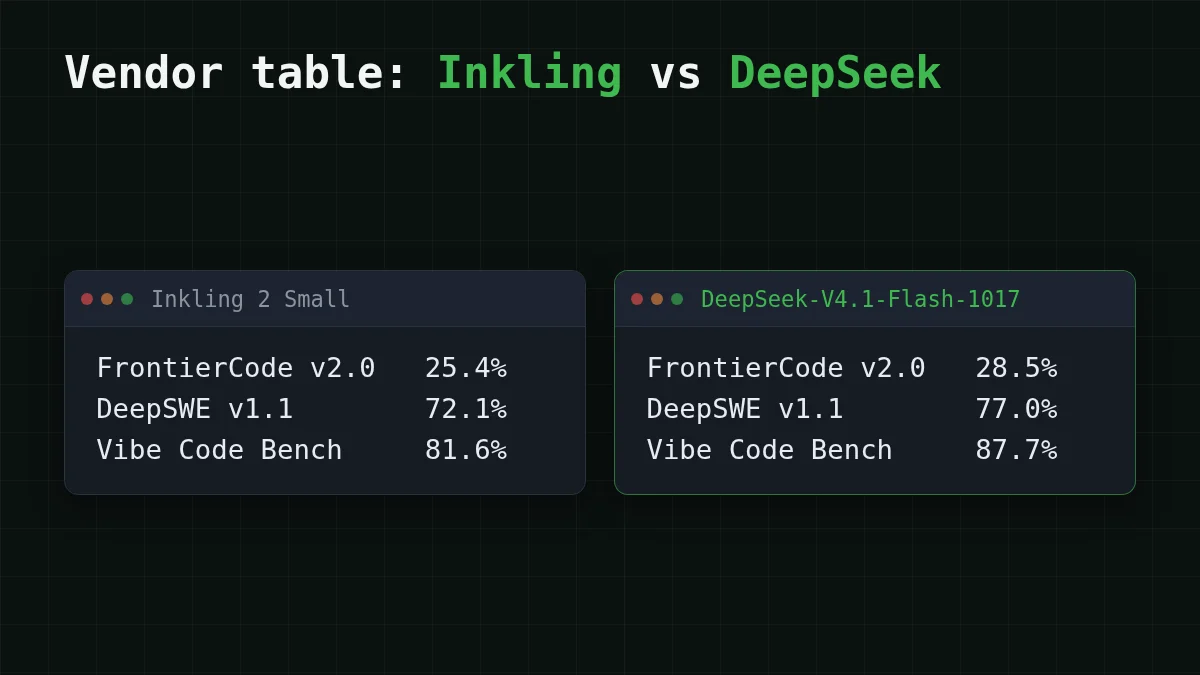
Le fournisseur compare Inkling 2 Small avec DeepSeek-V4.1-Flash-1017. La doc de DeepSeek indique que l'alias deepseek-flash est désormais servi par cette version (page sans date, vérifiée le 7 novembre 2026). Voici les lignes où les deux modèles ont un chiffre. La dernière colonne n'est que la soustraction.
Faites défiler le tableau vers la droite →
| Ligne | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | Écart, points |
|---|---|---|---|
| FrontierCode v2.0 | 25,4 % | 28,5 % | DeepSeek +3,1 |
| DeepSWE v1.1 | 72,1 % | 77,0 % | DeepSeek +4,9 |
| Vibe Code Bench v1.1 | 81,6 % | 87,7 % | DeepSeek +6,1 |
| Terminal Bench Science v0.1 | 5,7 % | 12,9 % | DeepSeek +7,2 |
| PostTrainBench v1.2 | 31,9 % | 30,5 % | Inkling +1,4 |
| PMPP-Hard (AUC) | 494,27 | 497,36 | DeepSeek +3,09 |
Vérification : 77,0 - 72,1 = 4,9. Comptez les lignes : DeepSeek est en tête sur cinq, Inkling sur une.
Devinez le nombre
Sur combien des six lignes en face-à-face DeepSeek-V4.1-Flash-1017 est-il en tête ?
Votre estimation
06
Afficher la réponse
Réponse: 5
Cinq : FrontierCode, DeepSWE, Vibe Code Bench, Terminal Bench Science et PMPP-Hard. Inkling n'est en tête que sur PostTrainBench.
Quelques points à noter avant de citer ce tableau à votre équipe.
- Le plus grand écart se trouve sur la ligne la moins mature. Terminal Bench Science est en version 0.1, et 12,9 % contre 5,7 %, c'est plus du double. C'est un indice sur le travail en terminal, pas un verdict.
- Une ligne n'a pas de face-à-face. SWEBench Pro v2 (Hard) affiche Inkling à 86,3 % et DeepSeek comme non rapporté. On ne peut pas comparer un chiffre avec un blanc.
- Les petits écarts sont petits. Un écart de 1,4 ou 3,1 point sur un benchmark que vous n'avez jamais exécuté peut ne pas survivre à un changement de dépôt ou de prompt.
- La page se contredit une fois. L'Artificial Analysis Intelligence Index est à 31 dans le texte et à 30,6 (v5.0) dans le tableau, sans explication. C'est un détail mineur, mais cela rappelle de lire les notes de bas de page.
Rien ici n'est encore répliqué indépendamment ; tous les chiffres viennent du fournisseur d'Inkling.
La conception web est une autre ligne#
Si votre tâche est de générer des sites web plutôt que de corriger des bugs, le chiffre pertinent est DesignArena Website. Dans l'instantané du 5 novembre sur la page de publication, Inkling 2 Small a obtenu 1 340, troisième derrière Muse Wonder (1 366) et Muse Spark 1.3 (1 351). Le fournisseur s'attend à ce qu'il soit le meilleur modèle à poids ouverts dans cette catégorie une fois les poids sortis. L'écart avec la première place est de 1 366 - 1 340 = 26 points.
C'est un classement de personnes qui comparent des pages générées, donc il dit quelque chose de réel sur l'apparence. Mais la page ne donne aucun chiffre DeepSeek pour cette ligne, il n'y a donc pas de face-à-face à lire. Ouvrez DesignArena vous-même avant de vous fier à l'instantané.
Ce qu'aucun tableau ne peut montrer#
Supposez que vous maintenez un monolithe Django vieux de dix ans avec des tests lents et beaucoup de règles maison. Un benchmark fait de dépôts récents et bien rangés vous dit peu sur la façon dont un modèle gère votre utils.py de 3 000 lignes. Quatre choses manquent dans tout tableau de fournisseur :
- Votre code et vos habitudes. Le nommage, le style de test, les fichiers que l'agent ne doit jamais toucher.
- Le comportement de la boucle de l'agent. Le même modèle peut bien s'en sortir dans un outil et mal dans un autre, car les outils diffèrent dans la façon dont ils lui fournissent les fichiers et les erreurs.
- Le nombre d'étapes d'une tâche. Un modèle qui est 3 points meilleur par tentative mais nécessite plus de tentatives n'est pas forcément meilleur pour vous.
- Le prix. Le prix par token d'Inkling n'est ni sur la page de publication ni dans la liste des modèles Tinker (vérifié le 7 novembre 2026). Consultez la page de tarification de Tinker et notez la date à côté de ce que vous trouvez.
Si vous voulez un parcours plus long sur la lecture des tableaux de benchmarks, il y a un article séparé : comment lire un benchmark IA et lancer un test à 5 prompts.
Le test à 5 prompts sur votre propre code#
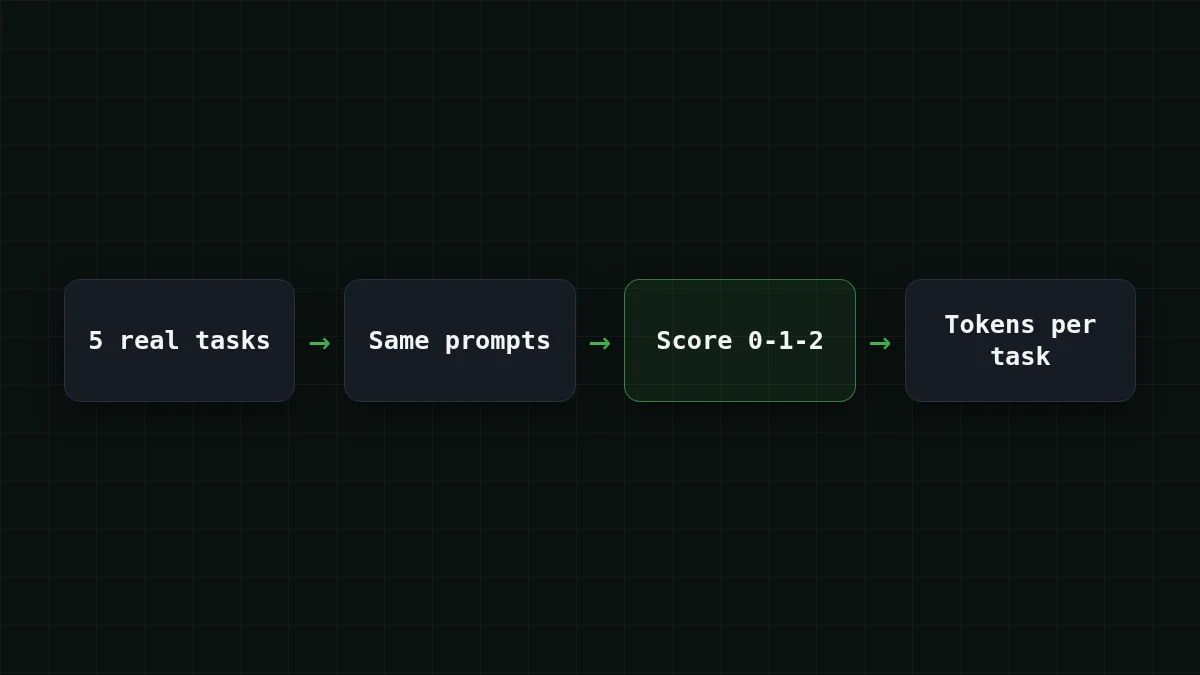
Cela prend un après-midi et bat n'importe quel classement pour votre décision. Choisissez cinq tâches que vous avez réellement faites ces deux dernières semaines, chacune avec un moyen de dire si la réponse est bonne. Envoyez le même texte à chaque modèle et notez le résultat vous-même.
Liste de contrôle
Votre test à 5 prompts
Pour les modèles que vous pouvez appeler via une API compatible OpenAI, la boucle est courte. Mettez les cinq prompts dans tasks.txt, séparés par une ligne avec =====. Lisez la documentation complète dans la doc CheapTokens ; l'adresse est https:/.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
Ce que vous verrez, ce sont cinq lignes de task number, input tokens, output tokens, finish_. stop signifie que le modèle a terminé de lui-même ; length signifie que max_tokens a coupé la réponse. L'id du modèle ici est le complet : deepseek-. Un id court tiré d'un tableau de prix ne fonctionnera pas.
DeepSeek-V4-Flash sur CheapTokens a un contexte de 380K, jusqu'à 32 768 tokens dans une réponse, un prix unique à toute heure du jour et aussi un endpoint compatible Anthropic, donc les mêmes cinq prompts passent aussi par des outils construits sur ce format. Les scores de vos propres cinq prompts sont ceux qui comptent pour votre dépôt. Pour Inkling 2 Small, envoyez les mêmes cinq textes via Tinker.
Vous voulez un troisième et un quatrième concurrent sur le même bilan ? GLM-5.3-Flash (zai-, contexte 390K) et MiniMax-M2.7 (MiniMaxAI/, contexte 180K) prennent le même appel avec une autre valeur model. Si vous voulez voir comment le modèle DeepSeek se compare à MiniMax sur les tâches, il y a MiniMax-M2.7 vs DeepSeek-V4-Flash.
Coût par tâche, pas par token#
Un prix par million de tokens n'est pas un prix par tâche terminée. Ce que vous payez, c'est le nombre d'étapes multiplié par les tokens de chaque étape, entrée et sortie comptées ensemble. Supposez que votre agent résolve un bug en 20 étapes, et que chaque étape envoie environ 30 000 tokens de fichiers et d'historique et reçoive environ 1 500 tokens en retour. Une étape sur DeepSeek-V4-Flash coûte $0.0006. La tâche entière, aux prix actuels :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 20 requêtes | OpenRouter, 20 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
30 000 tokens d'entrée et 1 500 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Ce tableau montre aussi le prix de référence d'OpenRouter, et au total, entrée et sortie comptées ensemble, DeepSeek-V4-Flash sur CheapTokens revient moins cher. Les tarifs par token de chaque modèle sont sur la page de tarification.
Maintenant le point qui compte pour la comparaison. Si le modèle A résout la tâche en 20 étapes et que le modèle B en a besoin de 30, alors 30 / 20 = 1,5, donc B coûte une fois et demie plus cher par tâche au même prix par token. Quelques points de plus sur un benchmark peuvent facilement être mangés par des étapes supplémentaires, et inversement. C'est pourquoi le test à 5 prompts enregistre les tokens : vous verrez les étapes et les tokens par tâche, pas seulement un score. La version longue de cette idée est dans prix par 1M de tokens vs coût par tâche.
Mettez vos propres chiffres dans le calculateur. Dans l'exemple ci-dessous, 200 exécutions correspondent à 10 tâches par jour à 20 étapes chacune ; changez les tokens par étape selon ce que votre test a montré.
Calculateur de coût
Une journée d'un agent de codage : 10 tâches, 20 étapes chacune
Tokens d'entrée par requête: 30 000 · Tokens de sortie par requête: 1 500 · Requêtes par jour: 200
| Modèle | Par jour | Par mois |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
Lequel choisir#
Un agent de codage sur un vrai dépôt. Sur les propres lignes de codage du fournisseur, DeepSeek-V4.1-Flash-1017 est en tête sur la plupart. Commencez le test avec DeepSeek-V4-Flash (id dans le code ci-dessus) et ajoutez Inkling aux mêmes cinq prompts. Ne changez que si Inkling gagne sur vos tâches, pas sur celles du fournisseur. Si vous voulez le contexte de la publication de DeepSeek elle-même, voir ce qui a changé dans deepseek-flash.
Sites web et génération front-end. Le classement DesignArena Website d'Inkling est l'affirmation la plus forte de la publication. Lancez deux ou trois de vos propres prompts de page sur les deux modèles et regardez les pages, pas les chiffres.
Auto-hébergement plus tard. Inkling est celui qui a un plan de poids ouverts, sous Apache 2.0. Tant que les fichiers n'existent pas, c'est un plan. Revérifiez la page de publication avant de construire quoi que ce soit autour, et en attendant vous pouvez lancer les mêmes prompts contre un modèle hébergé avec DeepSeek sur CheapTokens.
Un dernier conseil, si vous décidez par tâches : gardez les cinq prompts et la feuille de notation. La prochaine fois qu'un fournisseur publie un tableau, vous relancerez le test en une heure au lieu de relire des classements.


