モデルと比較比較
Inkling 2 Small 対 DeepSeek-V4.1-Flash:コーディングにはどちらのモデル?
ベンダーの表ではほとんどのコーディング行で DeepSeek-V4.1-Flash がリードしています。その読み方、自分のリポジトリでの5プロンプトチェック、タスクあたりコストの算出方法。
このページの内容
短い答え:Thinking Machines が Inkling 2 Small 向けに公開した表(2026年11月5日のリリースページ、11月7日確認)では、両モデルの数値が載っている6つのコーディング行のうち5つで DeepSeek-V4.1-Flash-1017 がリードしています。Inkling がリードするのは1行のみで、Webデザインのランクは強いです。ただしこれはベンダー自身の表なので、判定ではなく、自分のコードで小さなチェックを走らせる理由として扱ってください。
「Inkling は DeepSeek に迫っている」といった見出しを見て、コーディングエージェントを乗り換えるべきか迷ったなら、進める順序はこうです:自分の作業に合う行を読み、表では示せないことを確認し、自分のプロンプトを5つ走らせ、完了した1タスクあたりのコストを算出します。
Inkling 2 Small とは#
リリースページによると、Inkling 2 Small は Thinking Machines Lab の第2世代モデルです。総パラメータ594B、トークンあたり17Bがアクティブな Mixture-of-Experts モデルです。画像(音声は不可)を受け付け、可変の effort 設定があります。現時点では、同ラボのサーバーレス推論サービスである Tinker(Beta)で動作します。
見落としやすい点が2つあります。重みは今のところ非公開です:ラボは外部の安全性テスト後に Apache 2.0 で「来週」公開する予定で、他のプラットフォームも「今後数週間で」続くと述べています。これはファイルが実際に出るまでは計画であり、事実ではありません。そしてコンテキスト:Tinker のモデル一覧では最大256Kと表示されています。リリースページの512Kや1Mという数字はトレーニングと評価の設定であり、今日送信できるものではありません。
フラッシュカード
この比較で出会う用語
カードをタップしてめくる
ここでは日付がいつも以上に重要です。なぜなら提供内容の半分は約束だからです:
タイムライン
Inkling 2 Small:ベンダーの発言と時期
- 2026年11月5日リリースページ公開、モデルは Tinker(Beta)で稼働
- 「来週」外部安全性テスト後、Apache 2.0 でのオープンウェイト公開予定
- 「今後数週間」他のプラットフォームでの提供
表を1行ずつ読む#
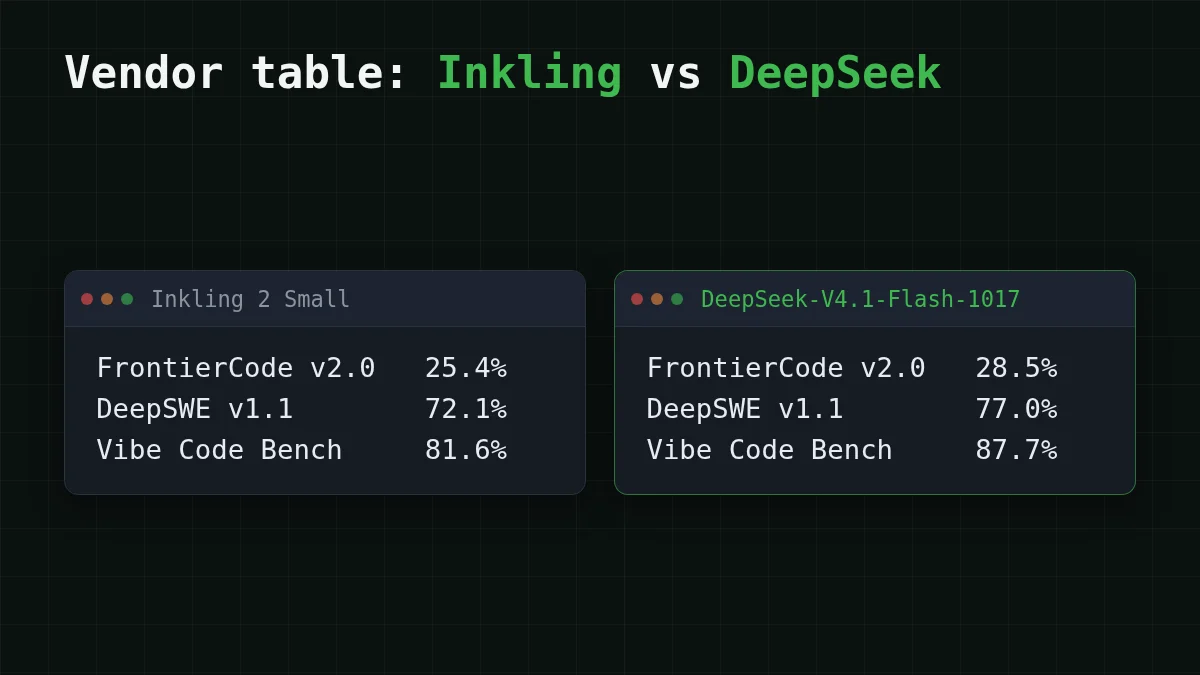
ベンダーは Inkling 2 Small を DeepSeek-V4.1-Flash-1017 と比較しています。DeepSeek のドキュメントによると、deepseek-flash エイリアスは現在そのバージョンで提供されています(ページに日付なし、2026年11月7日確認)。両モデルに数値がある行はこちらです。最後の列は単なる引き算です。
テーブルを右にスクロールしてください →
| 行 | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | 差、ポイント |
|---|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% | DeepSeek +3.1 |
| DeepSWE v1.1 | 72.1% | 77.0% | DeepSeek +4.9 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% | DeepSeek +6.1 |
| Terminal Bench Science v0.1 | 5.7% | 12.9% | DeepSeek +7.2 |
| PostTrainBench v1.2 | 31.9% | 30.5% | Inkling +1.4 |
| PMPP-Hard (AUC) | 494.27 | 497.36 | DeepSeek +3.09 |
確認:77.0 - 72.1 = 4.9。行を数えると DeepSeek が5つでリード、Inkling が1つです。
数字を当てる
6つの直接対決行のうち、DeepSeek-V4.1-Flash-1017 がリードするのはいくつですか?
あなたの予想
06
答えを表示
答え: 5
5つ:FrontierCode、DeepSWE、Vibe Code Bench、Terminal Bench Science、PMPP-Hard。Inkling がリードするのは PostTrainBench のみです。
この表をチームに引用する前に、いくつか注意すべき点があります。
- 最大の差は最も成熟していない行にある。 Terminal Bench Science はバージョン0.1で、12.9% 対 5.7% は2倍以上です。これはターミナル系作業に関するヒントであり、判定ではありません。
- 1行は直接対決がない。 SWEBench Pro v2 (Hard) は Inkling が86.3%、DeepSeek は未報告です。数値と空白は比較できません。
- 小さな差は小さい。 一度も走らせたことのないベンチマークでの1.4や3.1ポイントの差は、リポジトリやプロンプトが変われば残らないかもしれません。
- ページは一度自己矛盾している。 Artificial Analysis Intelligence Index は本文で31、表で30.6(v5.0)と説明なく食い違っています。些細なことですが、脚注を読むべきだという注意喚起です。
ここにあるものはまだ独立に再現されておらず、すべての数値は Inkling のベンダーによるものです。
Webデザインは別の行#
バグ修正ではなくウェブサイト生成がタスクなら、関連する数値は DesignArena Website です。リリースページの11月5日時点のスナップショットでは、Inkling 2 Small は1,340で、Muse Wonder(1,366)と Muse Spark 1.3(1,351)に次ぐ3位でした。ベンダーは重みが公開されればそこでトップのオープンウェイトモデルになると予想しています。1位との差は 1,366 - 1,340 = 26ポイントです。
これは生成されたページを人が比較するリーダーボードなので、見た目について実際のことを示します。しかしこの行に DeepSeek の数値はないため、直接対決は読めません。スナップショットに頼る前に DesignArena 自体を開いてください。
どの表にも示せないこと#
テストが遅く社内ルールが多い10年前の Django モノリスを保守しているとします。新しく整ったリポジトリで作られたベンチマークは、3,000行の utils.py をモデルがどう扱うかをほとんど教えてくれません。ベンダーの表には4つのことが欠けています:
- あなたのコードと習慣。 命名、テストスタイル、エージェントが絶対に触るべきでないファイル。
- エージェントループの振る舞い。 同じモデルでもツールによって良くも悪くもなります。ツールはファイルやエラーの渡し方が異なるからです。
- タスクに何ステップかかるか。 試行あたり3ポイント良くても、より多くの試行が必要なモデルは必ずしもあなたにとって良いとは限りません。
- 価格。 Inkling のトークンあたり価格はリリースページにも Tinker のモデル一覧にもありません(2026年11月7日確認)。Tinker の価格ページを見て、見つけたものの横に日付を添えてください。
ベンチマーク表の読み方をもっと詳しく知りたいなら、別記事があります:AIベンチマークの読み方と5プロンプトテストの実行。
自分のコードでの5プロンプトチェック#
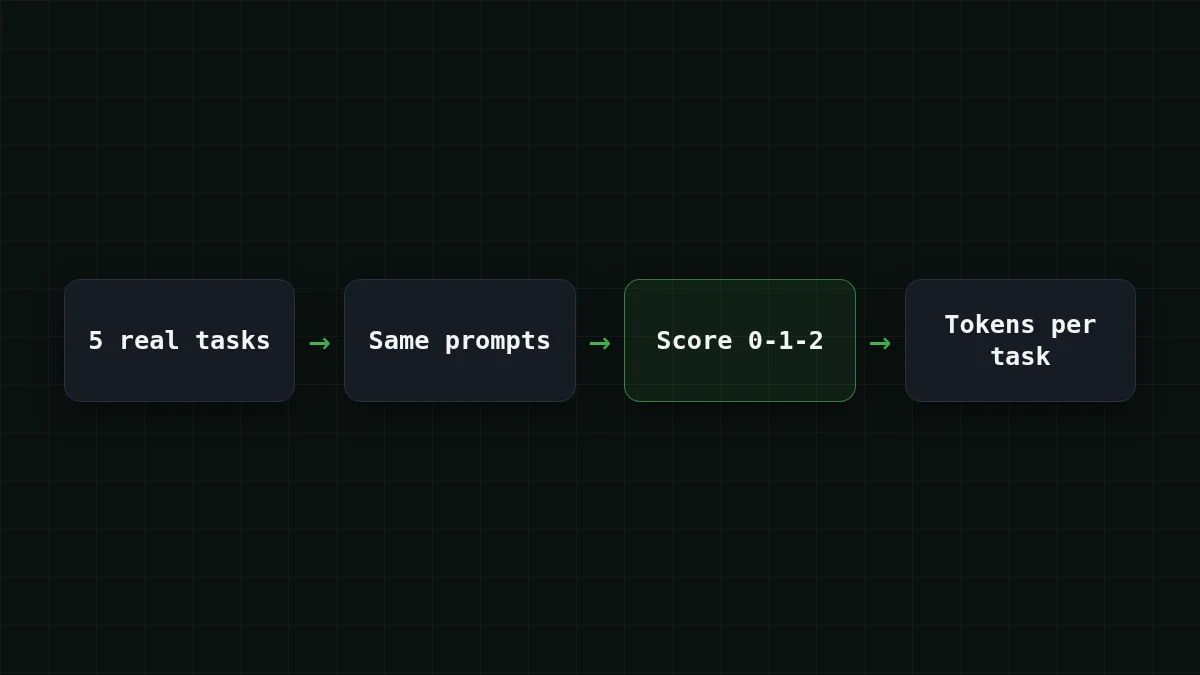
これには半日かかり、あなたの意思決定にはどんなリーダーボードよりも勝ります。過去2週間に実際に行ったタスクを5つ選び、それぞれに答えが正しいかどうかを判断する方法を用意します。同じテキストを各モデルに送り、結果を自分で採点します。
チェックリスト
あなたの5プロンプトチェック
OpenAI 互換 API で呼び出せるモデルなら、ループは短いです。5つのプロンプトを tasks.txt に入れ、===== の行で区切ります。完全なドキュメントは CheapTokens ドキュメント を読んでください;アドレスは https:/ です。
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
表示されるのは task number, input tokens, output tokens, finish_ の5行です。stop はモデルが自力で終了したことを意味し、length は max_tokens が回答を打ち切ったことを意味します。ここでのモデルIDは完全なものです:deepseek-。価格表の短いIDでは動作しません。
CheapTokens の DeepSeek-V4-Flash は380Kコンテキスト、1回答あたり最大32,768トークン、時間帯に関係なく同一価格、さらに Anthropic 互換エンドポイントも備えているので、同じ5つのプロンプトをその形式で作られたツールからも実行できます。自分の5つのプロンプトからのスコアが、あなたのリポジトリにとって重要なものです。Inkling 2 Small については、同じ5つのテキストを Tinker 経由で送ってください。
同じ残高で3番目と4番目の候補が欲しいですか? GLM-5.3-Flash(zai-、390Kコンテキスト)と MiniMax-M2.7(MiniMaxAI/、180Kコンテキスト)は、別の model 値で同じ呼び出しを受け付けます。DeepSeek モデルがタスクで MiniMax とどう比較されるか見たいなら、MiniMax-M2.7 対 DeepSeek-V4-Flash があります。
トークンあたりではなくタスクあたりのコスト#
100万トークンあたりの価格は、完了したタスクあたりの価格ではありません。支払うのは、ステップ数に入力と出力を合わせた各ステップのトークンを掛けたものです。エージェントがバグを20ステップで解決し、各ステップが約30,000トークンのファイルと履歴を送り、約1,500トークンを受け取るとします。DeepSeek-V4-Flash の1ステップは $0.0006 かかります。タスク全体は、実際の価格で:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 20 リクエスト | OpenRouter、20 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
リクエストあたり 30,000 入力トークンと 1,500 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
この表は OpenRouter の参考価格も示しており、入力と出力を合わせた合計では、CheapTokens の DeepSeek-V4-Flash の方が安くなります。すべてのモデルのトークンあたり料金は価格ページにあります。
ここで比較にとって重要な点です。モデルAがタスクを20ステップで解決し、モデルBが30ステップ必要なら、30 / 20 = 1.5なので、同じトークン価格でBはタスクあたり1.5倍のコストがかかります。ベンチマークでの数ポイントの差は、余分なステップで簡単に食われ、その逆もあります。だから5プロンプトチェックではトークンを記録するのです:スコアだけでなく、タスクあたりのステップとトークンが見えます。この考え方の長い版は100万トークンあたりの価格 対 タスクあたりのコストにあります。
自分の数値を計算機に入れてください。以下の例では、200回の実行は1日10タスク×各20ステップです;ステップあたりのトークンをチェックで示された値に変えてください。
コスト計算機
コーディングエージェントの1日:10タスク、各20ステップ
リクエストあたりの入力トークン数: 30,000 · リクエストあたりの出力トークン数: 1,500 · 1日あたりのリクエスト数: 200
| モデル | 1日あたり | 1か月あたり |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
どちらを選ぶか#
実際のリポジトリでのコーディングエージェント。 ベンダー自身のコーディング行では DeepSeek-V4.1-Flash-1017 がほとんどでリードしています。チェックは DeepSeek-V4-Flash(IDは上のコード内)で始め、同じ5つのプロンプトに Inkling を加えてください。乗り換えるのは、ベンダーのタスクではなくあなたのタスクで Inkling が勝った場合だけです。DeepSeek リリース自体の背景を知りたいなら、deepseek-flash で何が変わったかをご覧ください。
ウェブサイトとフロントエンド生成。 Inkling の DesignArena Website ランクはリリースの中で最も強い主張です。自分のページプロンプトを2、3個ずつ両モデルで実行し、数値ではなくページを見てください。
後でセルフホスト。 オープンウェイトの計画があるのは Inkling で、Apache 2.0 です。ファイルが存在するまでは計画です。それを中心に何かを作る前にリリースページを再確認し、その間はCheapTokens の DeepSeekでホスト型モデルに対して同じプロンプトを実行できます。
もう1つヒント:タスクで決めるなら、5つのプロンプトと採点シートを保存しておいてください。次にベンダーが表を公開したとき、ランキングを読み直す代わりに1時間でチェックを再実行できます。


