Modelos y comparativasComparativa
Inkling 2 Small vs DeepSeek-V4.1-Flash: ¿qué modelo para programar?
La tabla del proveedor pone a DeepSeek-V4.1-Flash por delante en la mayoría de las filas de programación. Cómo leerla, ejecutar una prueba de 5 prompts en tu repositorio y contar el coste por tarea.
En esta página
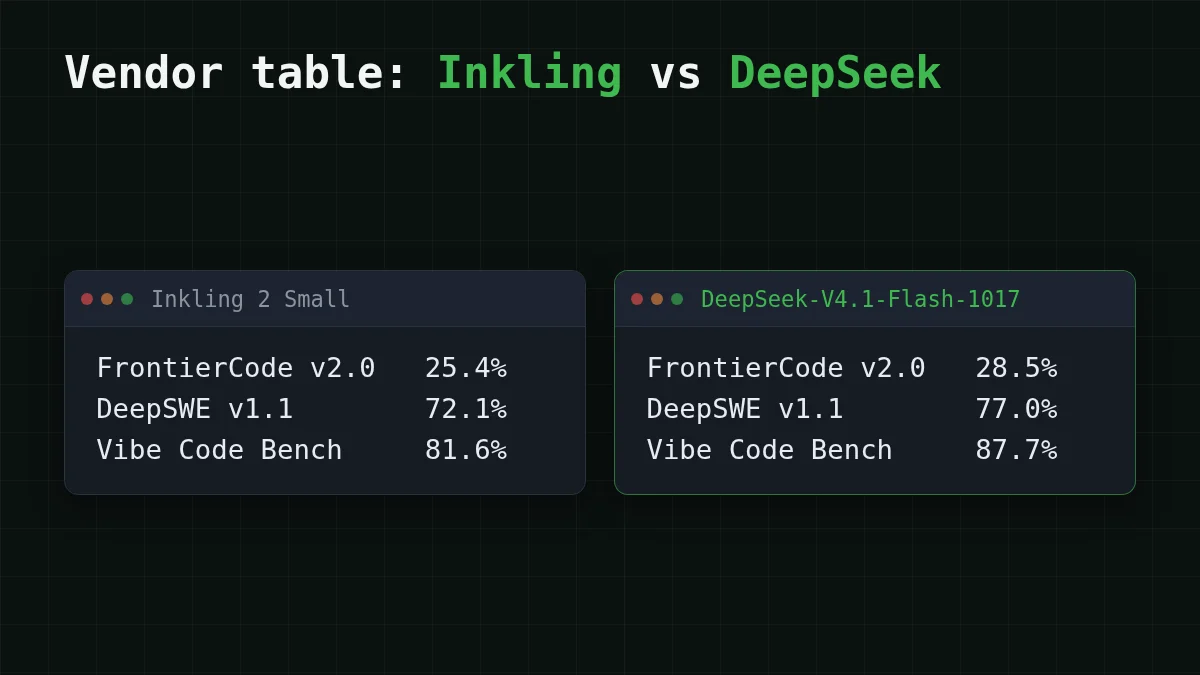
Respuesta corta: en la tabla que Thinking Machines publicó para Inkling 2 Small (página de lanzamiento del 5 de noviembre de 2026, consultada el 7 de noviembre), DeepSeek-V4.1-Flash-1017 va por delante en cinco de las seis filas de programación que muestran ambos modelos. Inkling lidera en una, y tiene un buen puesto en diseño web. Pero esa es la tabla del propio proveedor, así que tómala como un motivo para hacer una pequeña prueba con tu código, no como un veredicto.
Si viste un titular como "Inkling está cerca de DeepSeek" y te preguntaste si cambiar tu agente de programación, este es el orden a seguir: lee las filas que coinciden con tu trabajo, mira lo que la tabla no puede mostrar, ejecuta cinco prompts propios y ponle un coste a una tarea terminada.
Qué es Inkling 2 Small#
Según la página de lanzamiento, Inkling 2 Small es el modelo de segunda generación de Thinking Machines Lab. Es un modelo Mixture-of-Experts con 594B parámetros en total y 17B activos por token. Acepta imágenes (no audio) y tiene un ajuste de esfuerzo variable. Ahora mismo se ejecuta en Tinker, el servicio de inferencia sin servidor del laboratorio, que está en Beta.
Dos detalles son fáciles de pasar por alto. Los pesos están cerrados por ahora: el laboratorio planea publicarlos bajo Apache 2.0 "la próxima semana" tras las pruebas de seguridad externas, y dice que otras plataformas llegarán "en las próximas semanas". Eso es un plan, no un hecho, hasta que los archivos estén realmente disponibles. Y el contexto: la lista de modelos de Tinker muestra 256K como máximo. Las cifras de 512K y 1M de la página de lanzamiento son ajustes de entrenamiento y evaluación, no lo que puedes enviar hoy.
Tarjetas de memoria
Palabras que encontrarás en esta comparación
Toca una tarjeta para voltearla
Las fechas importan más de lo habitual aquí, porque la mitad de la oferta es una promesa:
Línea de tiempo
Inkling 2 Small: lo que dice el proveedor y cuándo
- 5 nov 2026página de lanzamiento publicada, modelo disponible en Tinker (Beta)
- "La próxima semana"lanzamiento planificado de pesos abiertos bajo Apache 2.0, tras pruebas de seguridad externas
- "Próximas semanas"disponibilidad en otras plataformas
Leer la tabla fila por fila#
El proveedor compara Inkling 2 Small con DeepSeek-V4.1-Flash-1017. La documentación de DeepSeek dice que el alias deepseek-flash ahora lo sirve esa versión (la página no tiene fecha, consultada el 7 de noviembre de 2026). Estas son las filas donde ambos modelos tienen un número. La última columna es solo la resta.
Desplaza la tabla hacia la derecha →
| Fila | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | Diferencia, puntos |
|---|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% | DeepSeek +3.1 |
| DeepSWE v1.1 | 72.1% | 77.0% | DeepSeek +4.9 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% | DeepSeek +6.1 |
| Terminal Bench Science v0.1 | 5.7% | 12.9% | DeepSeek +7.2 |
| PostTrainBench v1.2 | 31.9% | 30.5% | Inkling +1.4 |
| PMPP-Hard (AUC) | 494.27 | 497.36 | DeepSeek +3.09 |
Comprobación: 77.0 - 72.1 = 4.9. Cuenta las filas y DeepSeek va por delante en cinco, Inkling en una.
Adivina el número
¿En cuántas de las seis filas cara a cara va por delante DeepSeek-V4.1-Flash-1017?
Tu respuesta
06
Mostrar respuesta
Respuesta: 5
Cinco: FrontierCode, DeepSWE, Vibe Code Bench, Terminal Bench Science y PMPP-Hard. Inkling solo va por delante en PostTrainBench.
Algunas cosas que notar antes de citar esta tabla a tu equipo.
- La mayor diferencia está en la fila menos madura. Terminal Bench Science está en versión 0.1, y 12.9% frente a 5.7% es más del doble. Es una pista sobre trabajo de tipo terminal, no un fallo.
- Una fila no tiene cara a cara. SWEBench Pro v2 (Hard) muestra Inkling en 86.3% y DeepSeek como no reportado. No puedes comparar un número con un espacio en blanco.
- Las diferencias pequeñas son pequeñas. Una diferencia de 1.4 o 3.1 puntos en un benchmark que nunca has ejecutado puede no sobrevivir a un cambio de repositorio o de prompt.
- La página se contradice una vez. El Artificial Analysis Intelligence Index es 31 en el texto y 30.6 (v5.0) en la tabla, sin explicación. Es algo menor, pero es un recordatorio para leer las notas al pie.
Nada de esto está replicado de forma independiente todavía; todos los números provienen del proveedor de Inkling.
El diseño web es otra fila#
Si tu tarea es generar sitios web en lugar de corregir errores, el número relevante es DesignArena Website. En la instantánea del 5 de noviembre en la página de lanzamiento, Inkling 2 Small obtuvo 1,340, tercero por detrás de Muse Wonder (1,366) y Muse Spark 1.3 (1,351). El proveedor espera que sea el mejor modelo de pesos abiertos allí una vez que los pesos estén disponibles. La diferencia con el primer puesto es 1,366 - 1,340 = 26 puntos.
Esa es una clasificación de personas que comparan páginas generadas, así que dice algo real sobre la apariencia. Pero la página no da un número de DeepSeek para esta fila, así que no hay cara a cara que leer. Abre DesignArena directamente antes de fiarte de la instantánea.
Lo que ninguna tabla puede mostrar#
Supón que mantienes un monolito Django de diez años con pruebas lentas y muchas reglas internas. Un benchmark hecho de repositorios nuevos y ordenados te dice poco sobre cómo maneja un modelo tu utils.py de 3,000 líneas. Faltan cuatro cosas en cualquier tabla de proveedor:
- Tu código y tus hábitos. Nombres, estilo de pruebas, qué archivos el agente nunca debería tocar.
- Cómo se comporta el bucle del agente. El mismo modelo puede funcionar bien en una herramienta y mal en otra, porque las herramientas difieren en cómo le pasan archivos y errores.
- Cuántos pasos requiere una tarea. Un modelo que es 3 puntos mejor por intento pero necesita más intentos no es necesariamente mejor para ti.
- Precio. El precio por token de Inkling no está en la página de lanzamiento ni en la lista de modelos de Tinker (consultada el 7 de noviembre de 2026). Mira la página de precios de Tinker y pon la fecha junto a lo que encuentres.
Si quieres un recorrido más largo sobre cómo leer tablas de benchmarks, hay un artículo aparte: cómo leer un benchmark de IA y ejecutar una prueba de 5 prompts.
La prueba de 5 prompts en tu propio código#
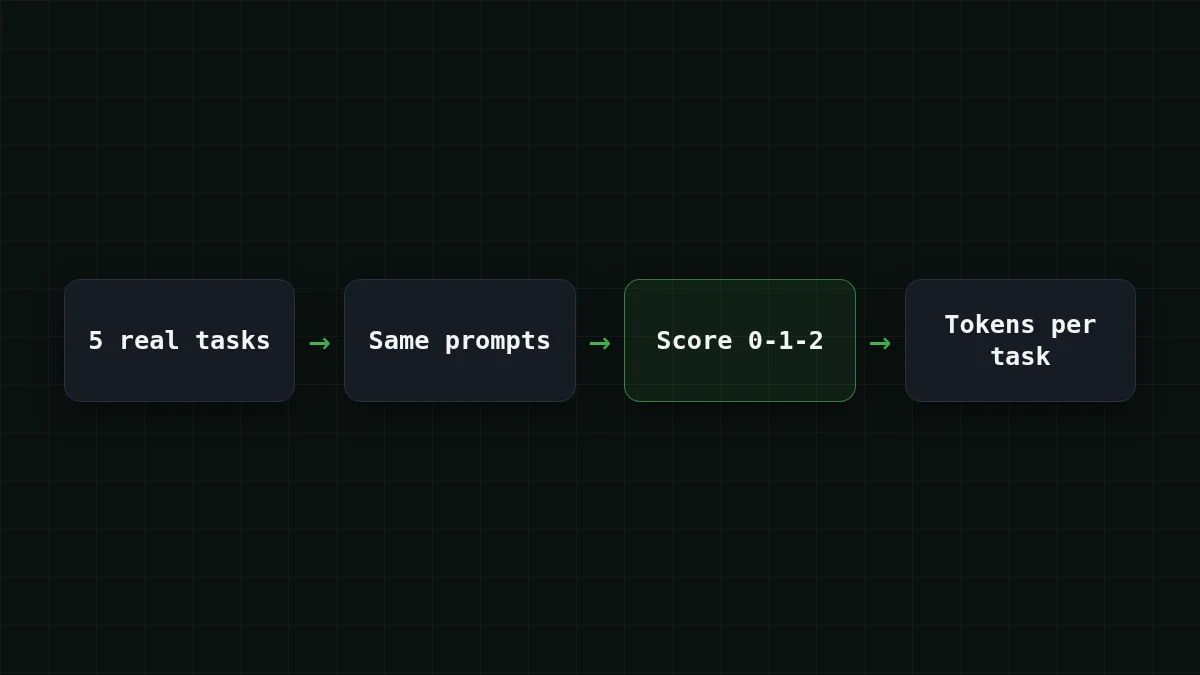
Esto lleva una tarde y supera a cualquier clasificación para tu decisión. Elige cinco tareas que realmente hiciste en las últimas dos semanas, cada una con una forma de saber si la respuesta es correcta. Envía el mismo texto a cada modelo y puntúa el resultado tú mismo.
Lista de verificación
Tu prueba de 5 prompts
Para los modelos que puedes llamar mediante una API compatible con OpenAI, el bucle es corto. Pon los cinco prompts en tasks.txt, separados por una línea con =====. Lee la documentación completa en documentación de CheapTokens; la dirección es https:/.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
Lo que verás son cinco líneas de task number, input tokens, output tokens, finish_. stop significa que el modelo terminó por sí solo; length significa que max_tokens cortó la respuesta. El id del modelo aquí es el completo: deepseek-. Un id corto de una tabla de precios no funcionará.
DeepSeek-V4-Flash en CheapTokens tiene un contexto de 380K, hasta 32,768 tokens en una respuesta, un precio a cualquier hora del día y también un endpoint compatible con Anthropic, así que los mismos cinco prompts también se ejecutan a través de herramientas construidas sobre ese formato. Las puntuaciones de tus propios cinco prompts son las que importan para tu repositorio. Para Inkling 2 Small, envía los mismos cinco textos a través de Tinker.
¿Quieres un tercer y cuarto contendiente en el mismo balance? GLM-5.3-Flash (zai-, contexto de 390K) y MiniMax-M2.7 (MiniMaxAI/, contexto de 180K) aceptan la misma llamada con otro valor de model. Si quieres ver cómo se compara el modelo DeepSeek con MiniMax en tareas, hay MiniMax-M2.7 vs DeepSeek-V4-Flash.
Coste por tarea, no por token#
Un precio por millón de tokens no es un precio por tarea terminada. Lo que pagas es el número de pasos multiplicado por los tokens de cada paso, contando entrada y salida juntos. Supón que tu agente resuelve un error en 20 pasos, y cada paso envía unos 30,000 tokens de archivos e historial y recibe unos 1,500 tokens de vuelta. Un paso en DeepSeek-V4-Flash cuesta $0.0006. La tarea completa, con precios en vivo:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 20 solicitudes | OpenRouter, 20 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
30.000 tokens de entrada y 1500 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
Esa tabla también muestra el precio de referencia de OpenRouter, y en total, contando entrada y salida juntos, DeepSeek-V4-Flash en CheapTokens sale más barato. Las tarifas por token de cada modelo están en la página de precios.
Ahora el punto que importa para la comparación. Si el modelo A resuelve la tarea en 20 pasos y el modelo B necesita 30, entonces 30 / 20 = 1.5, así que B cuesta una vez y media más por tarea al mismo precio por token. Unos pocos puntos extra en un benchmark pueden ser fácilmente devorados por pasos extra, y viceversa. Por eso la prueba de 5 prompts registra tokens: verás pasos y tokens por tarea, no solo una puntuación. La versión más larga de esta idea está en precio por 1M de tokens vs coste por tarea.
Pon tus propios números en la calculadora. En el ejemplo de abajo, 200 ejecuciones son 10 tareas al día a 20 pasos cada una; cambia los tokens por paso a lo que mostró tu prueba.
Calculadora de costos
Un día de un agente de programación: 10 tareas, 20 pasos cada una
Tokens de entrada por solicitud: 30.000 · Tokens de salida por solicitud: 1500 · Solicitudes por día: 200
| Modelo | Por día | Por mes |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
Cuál elegir#
Un agente de programación en un repositorio real. En las propias filas de programación del proveedor, DeepSeek-V4.1-Flash-1017 va por delante en la mayoría. Empieza la prueba con DeepSeek-V4-Flash (id en el código de arriba) y añade Inkling a los mismos cinco prompts. Cambia solo si Inkling gana en tus tareas, no en las del proveedor. Si quieres los antecedentes del lanzamiento de DeepSeek en sí, consulta qué cambió en deepseek-flash.
Sitios web y generación de front-end. El puesto de Inkling en DesignArena Website es la afirmación más fuerte del lanzamiento. Ejecuta dos o tres prompts de tus propias páginas en ambos modelos y mira las páginas, no los números.
Autoalojamiento más adelante. Inkling es el que tiene un plan de pesos abiertos, bajo Apache 2.0. Hasta que los archivos existan, es un plan. Vuelve a consultar la página de lanzamiento antes de construir nada alrededor de él, y mientras tanto puedes ejecutar los mismos prompts contra un modelo alojado con DeepSeek en CheapTokens.
Un consejo más, si decides por tareas: guarda los cinco prompts y la hoja de puntuación. La próxima vez que un proveedor publique una tabla, vuelves a ejecutar la prueba en una hora en lugar de leer clasificaciones de nuevo.


