Modelli e confrontiConfronto
Inkling 2 Small vs DeepSeek-V4.1-Flash: quale modello per il coding?
La tabella del fornitore mette DeepSeek-V4.1-Flash avanti sulla maggior parte delle righe di coding. Come leggerla, eseguire un controllo a 5 prompt sul tuo repo e calcolare il costo per attività.
In questa pagina
Risposta breve: nella tabella pubblicata da Thinking Machines per Inkling 2 Small (pagina di rilascio del 5 novembre 2026, verificata il 7 novembre), DeepSeek-V4.1-Flash-1017 è avanti su cinque delle sei righe di coding in cui compaiono entrambi i modelli. Inkling è in testa su una, e ha un buon piazzamento nel web design. Ma è la tabella del fornitore stesso, quindi trattala come un motivo per fare una piccola verifica sul tuo codice, non come un verdetto.
Se hai visto un titolo tipo "Inkling è vicino a DeepSeek" e ti sei chiesto se cambiare il tuo agente di coding, questo è l'ordine da seguire: leggi le righe che corrispondono al tuo lavoro, guarda cosa la tabella non può mostrare, esegui cinque prompt tuoi e attribuisci un costo a un'attività completata.
Cos'è Inkling 2 Small#
Secondo la pagina di rilascio, Inkling 2 Small è il modello di seconda generazione di Thinking Machines Lab. È un modello Mixture-of-Experts con 594B parametri in totale e 17B attivi per token. Accetta immagini (non audio) e ha un'impostazione di effort variabile. Al momento gira su Tinker, il servizio di inferenza serverless del laboratorio, che è in Beta.
Due dettagli sono facili da perdere. I pesi sono chiusi per ora: il laboratorio prevede di rilasciarli con licenza Apache 2.0 "la prossima settimana" dopo i test di sicurezza esterni, e dice che altre piattaforme seguiranno "nelle prossime settimane". È un piano, non un fatto, finché i file non sono effettivamente fuori. E il contesto: la lista dei modelli di Tinker mostra 256K come massimo. I valori di 512K e 1M sulla pagina di rilascio sono impostazioni di training e valutazione, non ciò che puoi inviare oggi.
Flashcard
Parole che incontrerai in questo confronto
Tocca una carta per girarla
Le date contano più del solito qui, perché metà dell'offerta è una promessa:
Cronologia
Inkling 2 Small: cosa dice il fornitore e quando
- 5 nov 2026pagina di rilascio pubblicata, modello live su Tinker (Beta)
- "La prossima settimana"rilascio previsto dei pesi aperti con licenza Apache 2.0, dopo i test di sicurezza esterni
- "Nelle prossime settimane"disponibilità su altre piattaforme
Leggere la tabella riga per riga#
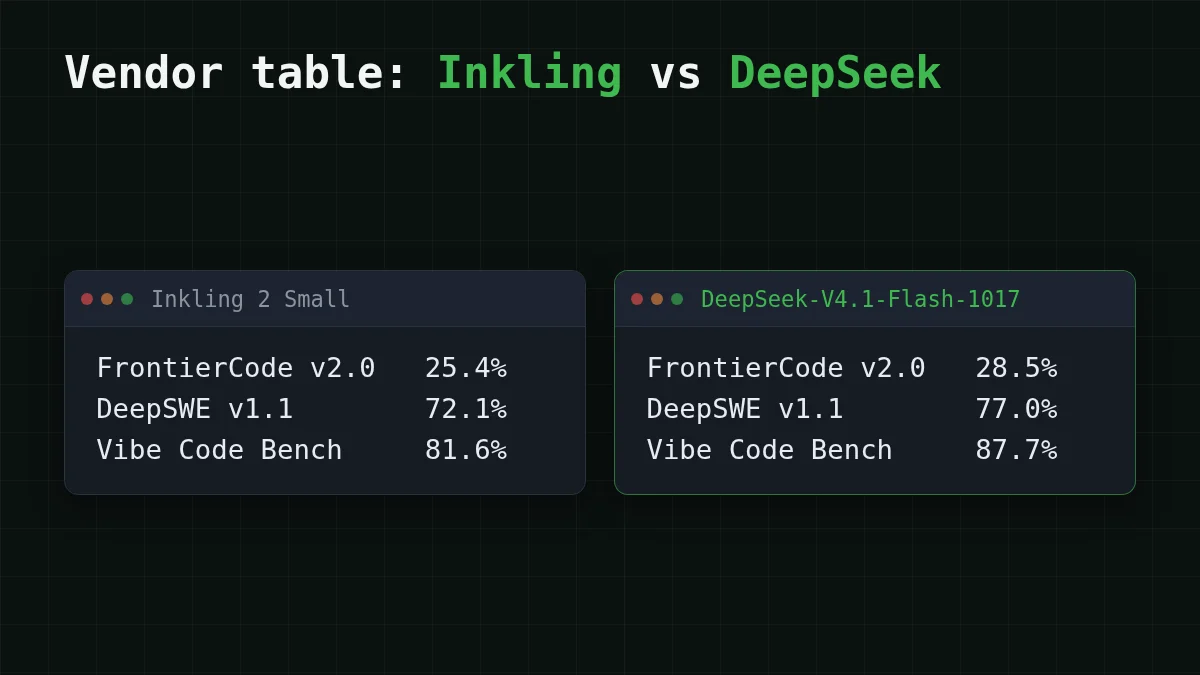
Il fornitore confronta Inkling 2 Small con DeepSeek-V4.1-Flash-1017. La documentazione di DeepSeek dice che l'alias deepseek-flash è ora servito da quella versione (la pagina non ha data, verificata il 7 novembre 2026). Ecco le righe in cui entrambi i modelli hanno un numero. L'ultima colonna è solo la sottrazione.
Scorri la tabella verso destra →
| Riga | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | Divario, punti |
|---|---|---|---|
| FrontierCode v2.0 | 25,4% | 28,5% | DeepSeek +3,1 |
| DeepSWE v1.1 | 72,1% | 77,0% | DeepSeek +4,9 |
| Vibe Code Bench v1.1 | 81,6% | 87,7% | DeepSeek +6,1 |
| Terminal Bench Science v0.1 | 5,7% | 12,9% | DeepSeek +7,2 |
| PostTrainBench v1.2 | 31,9% | 30,5% | Inkling +1,4 |
| PMPP-Hard (AUC) | 494,27 | 497,36 | DeepSeek +3,09 |
Verifica uno: 77,0 - 72,1 = 4,9. Conta le righe e DeepSeek è avanti su cinque, Inkling su una.
Indovina il numero
Su quante delle sei righe testa a testa è avanti DeepSeek-V4.1-Flash-1017?
La tua risposta
06
Mostra risposta
Risposta: 5
Cinque: FrontierCode, DeepSWE, Vibe Code Bench, Terminal Bench Science e PMPP-Hard. Inkling è avanti solo su PostTrainBench.
Qualche cosa da notare prima di citare questa tabella al tuo team.
- Il divario più grande sta sulla riga meno matura. Terminal Bench Science è alla versione 0.1, e 12,9% contro 5,7% è più del doppio. È un indizio sul lavoro in stile terminale, non una sentenza.
- Una riga non ha il testa a testa. SWEBench Pro v2 (Hard) mostra Inkling all'86,3% e DeepSeek come non riportato. Non puoi confrontare un numero con uno spazio vuoto.
- I divari piccoli sono piccoli. Un divario di 1,4 o 3,1 punti su un benchmark che non hai mai eseguito può non sopravvivere a un cambio di repo o di prompt.
- La pagina si contraddice una volta. L'Artificial Analysis Intelligence Index è 31 nel testo e 30,6 (v5.0) nella tabella, senza spiegazione. È una cosa minore, ma ricorda di leggere le note a piè di pagina.
Niente qui è ancora replicato in modo indipendente; tutti i numeri provengono dal fornitore di Inkling.
Il web design è una riga diversa#
Se il tuo compito è generare siti web invece di correggere bug, il numero rilevante è DesignArena Website. Nello snapshot del 5 novembre sulla pagina di rilascio, Inkling 2 Small ha ottenuto 1.340, terzo dietro Muse Wonder (1.366) e Muse Spark 1.3 (1.351). Il fornitore si aspetta che sia il miglior modello a pesi aperti in quella classifica una volta che i pesi saranno fuori. Il divario dal primo posto è 1.366 - 1.340 = 26 punti.
Quella è una classifica di persone che confrontano pagine generate, quindi dice qualcosa di reale sull'aspetto. Ma la pagina non fornisce un numero di DeepSeek per questa riga, quindi non c'è un testa a testa da leggere. Apri DesignArena stesso prima di affidarti allo snapshot.
Cosa nessuna tabella può mostrare#
Supponi di mantenere un monolite Django di dieci anni con test lenti e molte regole interne. Un benchmark fatto di repo nuovi e ordinati ti dice poco su come un modello gestisce il tuo utils.py da 3.000 righe. Mancano quattro cose da qualsiasi tabella del fornitore:
- Il tuo codice e le tue abitudini. Nomi, stile dei test, quali file l'agente non deve mai toccare.
- Come si comporta il loop dell'agente. Lo stesso modello può andare bene in uno strumento e male in un altro, perché gli strumenti differiscono nel modo in cui gli passano file ed errori.
- Quanti passi richiede un'attività. Un modello che è 3 punti meglio per tentativo ma richiede più tentativi non è necessariamente meglio per te.
- Il prezzo. Il prezzo per token di Inkling non è sulla pagina di rilascio né nella lista dei modelli di Tinker (verificato il 7 novembre 2026). Guarda la pagina dei prezzi di Tinker e metti la data accanto a ciò che trovi.
Se vuoi una trattazione più lunga su come leggere le tabelle dei benchmark, c'è un articolo separato: come leggere un benchmark AI ed eseguire un test a 5 prompt.
Il controllo a 5 prompt sul tuo codice#
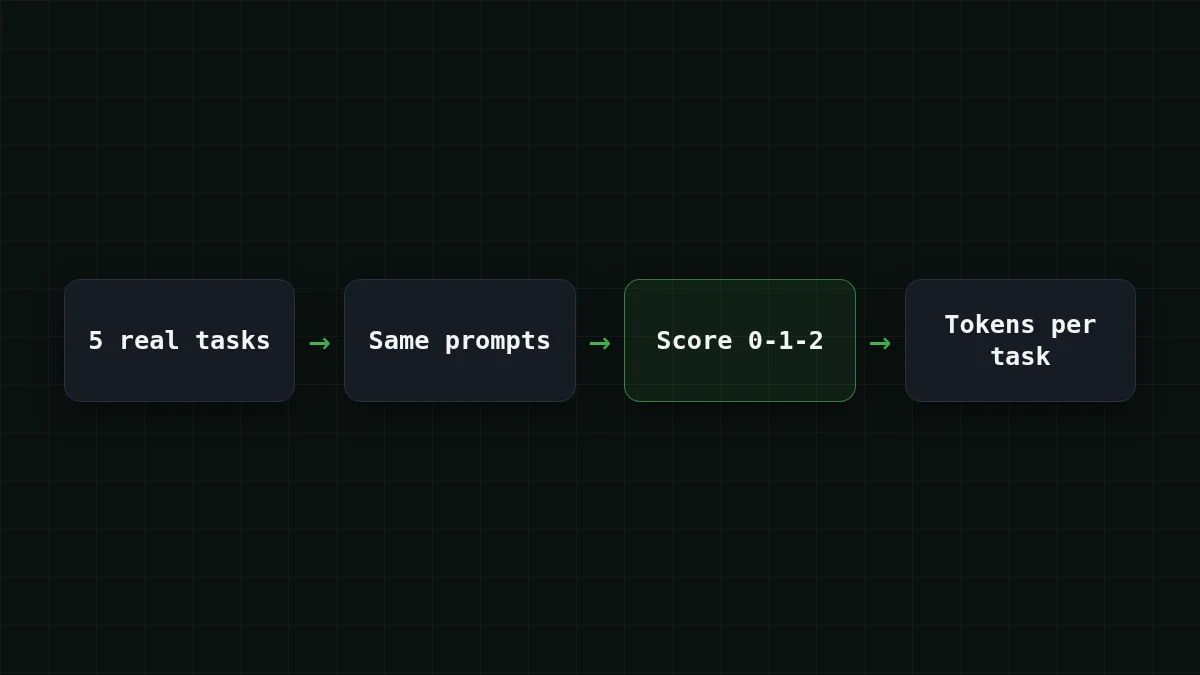
Richiede un pomeriggio e batte qualsiasi classifica per la tua decisione. Scegli cinque attività che hai davvero svolto nelle ultime due settimane, ognuna con un modo per capire se la risposta è giusta. Invia lo stesso testo a ogni modello e valuta tu il risultato.
Lista di controllo
Il tuo controllo a 5 prompt
Per i modelli che puoi chiamare tramite un'API compatibile con OpenAI, il loop è breve. Metti i cinque prompt in tasks.txt, separati da una riga con =====. Leggi la documentazione completa in CheapTokens docs; l'indirizzo è https:/.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
Quello che vedrai sono cinque righe di task number, input tokens, output tokens, finish_. stop significa che il modello ha finito da solo; length significa che max_tokens ha interrotto la risposta. L'id del modello qui è quello completo: deepseek-. Un id breve preso da una tabella dei prezzi non funzionerà.
DeepSeek-V4-Flash su CheapTokens ha un contesto di 380K, fino a 32.768 token in una risposta, un prezzo unico a qualsiasi ora del giorno e anche un endpoint compatibile con Anthropic, quindi gli stessi cinque prompt girano anche tramite strumenti costruiti su quel formato. I punteggi dei tuoi cinque prompt sono quelli che contano per il tuo repo. Per Inkling 2 Small, invia gli stessi cinque testi tramite Tinker.
Vuoi un terzo e un quarto contendente sullo stesso bilancio? GLM-5.3-Flash (zai-, contesto 390K) e MiniMax-M2.7 (MiniMaxAI/, contesto 180K) accettano la stessa chiamata con un altro valore di model. Se vuoi vedere come il modello DeepSeek si confronta con MiniMax sulle attività, c'è MiniMax-M2.7 vs DeepSeek-V4-Flash.
Costo per attività, non per token#
Un prezzo per milione di token non è un prezzo per attività completata. Quello che paghi è il numero di passi moltiplicato per i token in ogni passo, contando insieme input e output. Supponi che il tuo agente risolva un bug in 20 passi, e che ogni passo invii circa 30.000 token di file e cronologia e riceva indietro circa 1.500 token. Un passo su DeepSeek-V4-Flash costa $0.0006. L'intera attività, ai prezzi live:
| Modello | Input $/1M | Output $/1M | Per richiesta | 20 richieste | OpenRouter, 20 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
30.000 token di input e 1500 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Quella tabella mostra anche il prezzo di riferimento di OpenRouter, e in totale, contando insieme input e output, DeepSeek-V4-Flash su CheapTokens risulta più economico. Le tariffe per token di ogni modello sono sulla pagina dei prezzi.
Ora il punto che conta per il confronto. Se il modello A risolve l'attività in 20 passi e il modello B ne richiede 30, allora 30 / 20 = 1,5, quindi B costa una volta e mezza tanto per attività allo stesso prezzo per token. Qualche punto in più su un benchmark può facilmente essere mangiato da passi extra, e viceversa. Ecco perché il controllo a 5 prompt registra i token: vedrai passi e token per attività, non solo un punteggio. La versione più lunga di questa idea è in prezzo per 1M token vs costo per attività.
Metti i tuoi numeri nel calcolatore. Nell'esempio sotto, 200 esecuzioni sono 10 attività al giorno a 20 passi ciascuna; cambia i token per passo con quelli che ha mostrato il tuo controllo.
Calcolatore di costi
Un giorno di un agente di coding: 10 attività, 20 passi ciascuna
Token di input per richiesta: 30.000 · Token di output per richiesta: 1500 · Richieste al giorno: 200
| Modello | Al giorno | Al mese |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
Quale scegliere#
Un agente di coding su un repo reale. Sulle righe di coding del fornitore stesso DeepSeek-V4.1-Flash-1017 è avanti sulla maggior parte. Inizia il controllo con DeepSeek-V4-Flash (id nel codice sopra) e aggiungi Inkling agli stessi cinque prompt. Passa solo se Inkling vince sulle tue attività, non su quelle del fornitore. Se vuoi il contesto sul rilascio di DeepSeek stesso, vedi cosa è cambiato in deepseek-flash.
Siti web e generazione front-end. Il piazzamento di Inkling su DesignArena Website è l'affermazione più forte del rilascio. Esegui due o tre prompt tuoi per pagine su entrambi i modelli e guarda le pagine, non i numeri.
Self-hosting in futuro. Inkling è quello con un piano di pesi aperti, con licenza Apache 2.0. Finché i file non esistono, è un piano. Ricontrolla la pagina di rilascio prima di costruirci qualcosa intorno, e nel frattempo puoi eseguire gli stessi prompt su un modello ospitato con DeepSeek su CheapTokens.
Un altro consiglio, se decidi in base alle attività: conserva i cinque prompt e il foglio dei punteggi. La prossima volta che un fornitore pubblica una tabella, riesegui il controllo in un'ora invece di rileggere le classifiche.


