Modele i porównaniaPorównanie
Inkling 2 Small vs DeepSeek-V4.1-Flash: który model do kodowania?
Tabela dostawcy stawia DeepSeek-V4.1-Flash na czele w większości wierszy dotyczących kodowania. Jak ją czytać, przeprowadzić test 5 promptów na swoim repozytorium i policzyć koszt na zadanie.
Na tej stronie
Krótka odpowiedź: w tabeli, którą Thinking Machines opublikowało dla Inkling 2 Small (strona wydania z 5 listopada 2026, sprawdzona 7 listopada), DeepSeek-V4.1-Flash-1017 prowadzi w pięciu z sześciu wierszy dotyczących kodowania, w których podano oba modele. Inkling prowadzi w jednym i ma mocną pozycję w rankingu projektowania stron. To jednak tabela samego dostawcy, więc traktuj ją jako powód, by przeprowadzić mały test na własnym kodzie, a nie jako wyrok.
Jeśli widziałeś nagłówek typu „Inkling jest blisko DeepSeek” i zastanawiałeś się, czy przełączyć swojego agenta kodującego, oto właściwa kolejność: przeczytaj wiersze pasujące do twojej pracy, zobacz, czego tabela nie pokazuje, uruchom pięć własnych promptów i policz koszt jednego ukończonego zadania.
Czym jest Inkling 2 Small#
Według strony wydania Inkling 2 Small to model drugiej generacji od Thinking Machines Lab. To model Mixture-of-Experts z 594B parametrów łącznie i 17B aktywnych na token. Przyjmuje obrazy (nie audio) i ma zmienne ustawienie wysiłku. Obecnie działa na Tinker, bezserwerowej usłudze inferencji laboratorium, która jest w wersji Beta.
Dwa szczegóły łatwo przeoczyć. Wagi są na razie zamknięte: laboratorium planuje udostępnić je na licencji Apache 2.0 „w przyszłym tygodniu” po zewnętrznych testach bezpieczeństwa i twierdzi, że inne platformy pojawią się „w nadchodzących tygodniach”. To plan, a nie fakt, dopóki pliki faktycznie się nie pojawią. A kontekst: lista modeli Tinker pokazuje 256K jako maksimum. Wartości 512K i 1M na stronie wydania to ustawienia treningu i ewaluacji, a nie to, co możesz wysłać dziś.
Fiszki
Pojęcia, które spotkasz w tym porównaniu
Dotknij kartę, aby ją odwrócić
Daty mają tu większe znaczenie niż zwykle, bo połowa oferty to obietnica:
Os czasu
Inkling 2 Small: co mówi dostawca i kiedy
- 5 lis 2026opublikowano stronę wydania, model działa na Tinker (Beta)
- „W przyszłym tygodniu”planowane wydanie otwartych wag na licencji Apache 2.0, po zewnętrznych testach bezpieczeństwa
- „W nadchodzących tygodniach”dostępność na innych platformach
Czytanie tabeli wiersz po wierszu#
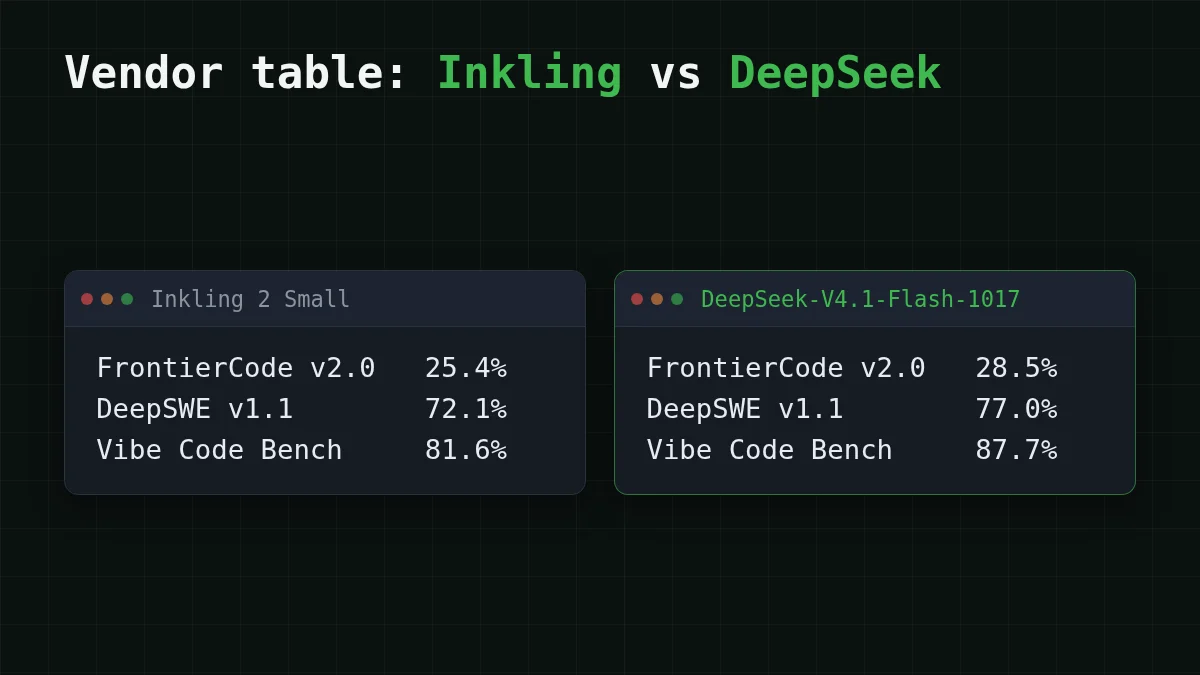
Dostawca porównuje Inkling 2 Small z DeepSeek-V4.1-Flash-1017. Dokumentacja DeepSeek mówi, że alias deepseek-flash jest teraz obsługiwany przez tę wersję (strona bez daty, sprawdzona 7 listopada 2026). Oto wiersze, w których oba modele mają liczbę. Ostatnia kolumna to po prostu odejmowanie.
Przewiń tabelę w prawo →
| Wiersz | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | Różnica, punkty |
|---|---|---|---|
| FrontierCode v2.0 | 25,4% | 28,5% | DeepSeek +3,1 |
| DeepSWE v1.1 | 72,1% | 77,0% | DeepSeek +4,9 |
| Vibe Code Bench v1.1 | 81,6% | 87,7% | DeepSeek +6,1 |
| Terminal Bench Science v0.1 | 5,7% | 12,9% | DeepSeek +7,2 |
| PostTrainBench v1.2 | 31,9% | 30,5% | Inkling +1,4 |
| PMPP-Hard (AUC) | 494,27 | 497,36 | DeepSeek +3,09 |
Sprawdzenie: 77,0 - 72,1 = 4,9. Policz wiersze, a DeepSeek prowadzi w pięciu, Inkling w jednym.
Zgadnij liczbę
W ilu z sześciu wierszy bezpośredniego porównania DeepSeek-V4.1-Flash-1017 prowadzi?
Twoje przypuszczenie
06
Pokaż odpowiedź
Odpowiedź: 5
W pięciu: FrontierCode, DeepSWE, Vibe Code Bench, Terminal Bench Science i PMPP-Hard. Inkling prowadzi tylko w PostTrainBench.
Kilka rzeczy warto zauważyć, zanim zacytujesz tę tabelę swojemu zespołowi.
- Największa różnica jest w najmniej dojrzałym wierszu. Terminal Bench Science jest w wersji 0.1, a 12,9% wobec 5,7% to ponad dwukrotność. To wskazówka dotycząca pracy w stylu terminala, a nie rozstrzygnięcie.
- Jeden wiersz nie ma bezpośredniego porównania. SWEBench Pro v2 (Hard) pokazuje Inkling na 86,3%, a DeepSeek jako niepodany. Nie można porównać liczby z pustym miejscem.
- Małe różnice są małe. Różnica 1,4 lub 3,1 punktu w benchmarku, którego nigdy nie uruchamiałeś, może nie przetrwać zmiany repozytorium lub promptu.
- Strona raz sobie przeczy. Artificial Analysis Intelligence Index wynosi 31 w tekście i 30,6 (v5.0) w tabeli, bez wyjaśnienia. To drobiazg, ale przypomina, by czytać przypisy.
Nic tutaj nie zostało jeszcze niezależnie powtórzone; wszystkie liczby pochodzą od dostawcy Inkling.
Projektowanie stron to inny wiersz#
Jeśli twoim zadaniem jest generowanie stron internetowych, a nie naprawianie błędów, istotna jest liczba DesignArena Website. W migawce z 5 listopada na stronie wydania Inkling 2 Small uzyskał 1 340, trzecie miejsce za Muse Wonder (1 366) i Muse Spark 1.3 (1 351). Dostawca oczekuje, że po wydaniu wag będzie to najlepszy model z otwartymi wagami w tym rankingu. Różnica do pierwszego miejsca to 1 366 - 1 340 = 26 punktów.
To ranking ludzi porównujących wygenerowane strony, więc mówi coś realnego o wyglądzie. Ale strona nie podaje liczby DeepSeek dla tego wiersza, więc nie ma bezpośredniego porównania. Otwórz sam DesignArena, zanim oprzesz się na migawce.
Czego nie pokaże żadna tabela#
Złóżmy, że utrzymujesz dziesięcioletni monolit Django z wolnymi testami i wieloma własnymi zasadami. Benchmark złożony z nowych, uporządkowanych repozytoriów niewiele mówi o tym, jak model radzi sobie z twoim utils.py mającym 3 000 linii. W każdej tabeli dostawcy brakuje czterech rzeczy:
- Twojego kodu i twoich nawyków. Nazewnictwa, stylu testów, plików, których agent nigdy nie powinien dotykać.
- Zachowania pętli agenta. Ten sam model może radzić sobie dobrze w jednym narzędziu, a źle w innym, bo narzędzia różnią się sposobem podawania mu plików i błędów.
- Liczby kroków potrzebnych na zadanie. Model, który jest o 3 punkty lepszy na próbę, ale potrzebuje więcej prób, niekoniecznie jest dla ciebie lepszy.
- Ceny. Cena za token Inkling nie jest podana na stronie wydania ani na liście modeli Tinker (sprawdzone 7 listopada 2026). Zajrzyj na stronę cennika Tinker i zapisz datę obok tego, co znajdziesz.
Jeśli chcesz dłuższego omówienia czytania tabel benchmarków, jest osobny artykuł: jak czytać benchmark AI i przeprowadzić test 5 promptów.
Test 5 promptów na własnym kodzie#
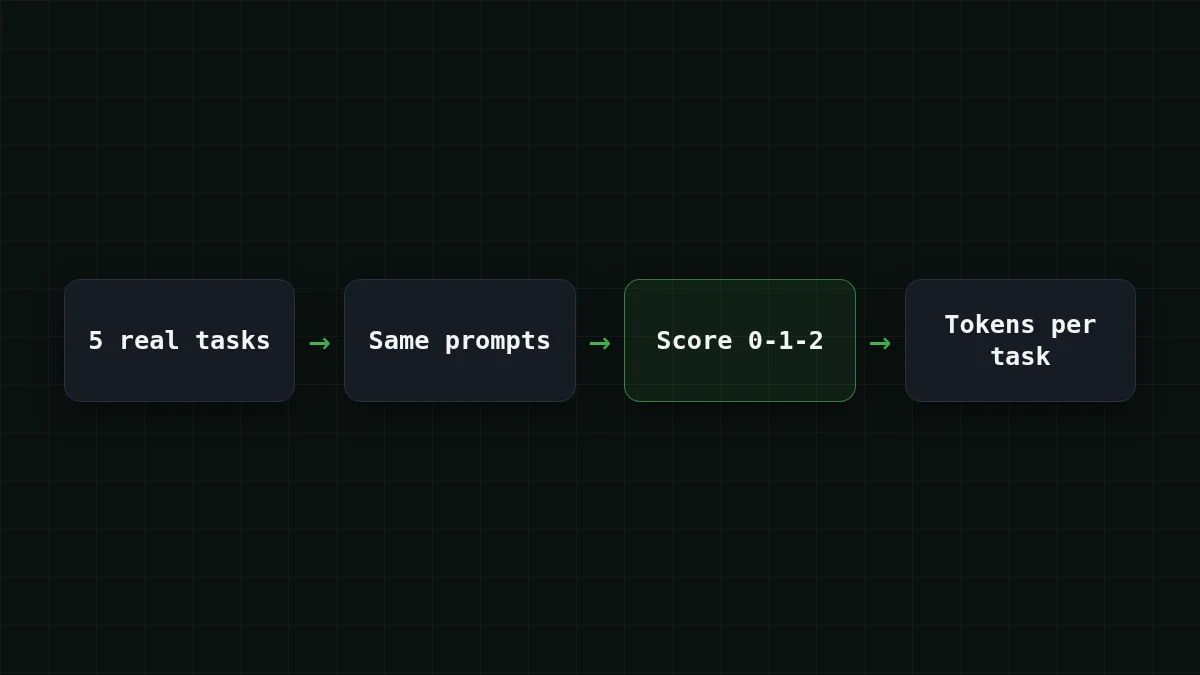
Zajmuje popołudnie i bije każdy ranking w twojej decyzji. Wybierz pięć zadań, które faktycznie wykonałeś w ciągu ostatnich dwóch tygodni, każde ze sposobem sprawdzenia, czy odpowiedź jest poprawna. Wyślij ten sam tekst do każdego modelu i sam oceń wynik.
Lista kontrolna
Twój test 5 promptów
Dla modeli, które możesz wywołać przez API zgodne z OpenAI, pętla jest krótka. Umieść pięć promptów w tasks.txt, oddzielonych linią z =====. Pełna dokumentacja jest w dokumentacji CheapTokens; adres to https:/.
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
Zobaczysz pięć linii task number, input tokens, output tokens, finish_. stop oznacza, że model zakończył samodzielnie; length oznacza, że max_tokens przerwał odpowiedź. Identyfikator modelu jest tu pełny: deepseek-. Krótki identyfikator z tabeli cen nie zadziała.
DeepSeek-V4-Flash na CheapTokens ma kontekst 380K, do 32 768 tokenów w jednej odpowiedzi, jedną cenę o każdej porze dnia oraz endpoint zgodny z Anthropic, więc te same pięć promptów uruchomisz także przez narzędzia zbudowane na tym formacie. Wyniki z twoich własnych pięciu promptów są tym, co liczy się dla twojego repozytorium. Dla Inkling 2 Small wyślij te same pięć tekstów przez Tinker.
Chcesz trzeciego i czwartego kandydata na tej samej zasadzie? GLM-5.3-Flash (zai-, kontekst 390K) i MiniMax-M2.7 (MiniMaxAI/, kontekst 180K) przyjmują to samo wywołanie z inną wartością model. Jeśli chcesz zobaczyć, jak model DeepSeek wypada na tle MiniMax w zadaniach, jest MiniMax-M2.7 vs DeepSeek-V4-Flash.
Koszt na zadanie, nie na token#
Cena za milion tokenów to nie cena za ukończone zadanie. Płacisz za liczbę kroków pomnożoną przez tokeny w każdym kroku, licząc wejście i wyjście razem. Załóżmy, że twój agent rozwiązuje błąd w 20 krokach, a każdy krok wysyła około 30 000 tokenów plików i historii i dostaje z powrotem około 1 500 tokenów. Jeden krok na DeepSeek-V4-Flash kosztuje $0.0006. Całe zadanie, według aktualnych cen:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 20 żądań | OpenRouter, 20 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
30 000 tokenów wejściowych i 1500 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Ta tabela pokazuje też cenę referencyjną OpenRouter, a łącznie, licząc wejście i wyjście razem, DeepSeek-V4-Flash na CheapTokens wypada taniej. Stawki za token dla każdego modelu są na stronie cennika.
Teraz najważniejszy punkt dla porównania. Jeśli model A rozwiązuje zadanie w 20 krokach, a model B potrzebuje 30, to 30 / 20 = 1,5, więc B kosztuje półtora raza więcej na zadanie przy tej samej cenie za token. Kilka dodatkowych punktów w benchmarku łatwo pochłoną dodatkowe kroki i odwrotnie. Dlatego test 5 promptów zapisuje tokeny: zobaczysz kroki i tokeny na zadanie, a nie tylko wynik. Dłuższa wersja tego pomysłu jest w cena za 1M tokenów vs koszt na zadanie.
Wpisz własne liczby do kalkulatora. W poniższym przykładzie 200 uruchomień to 10 zadań dziennie po 20 kroków każde; zmień tokeny na krok na to, co pokazał twój test.
Kalkulator kosztów
Jeden dzień agenta kodującego: 10 zadań, po 20 kroków
Tokeny wejściowe na żądanie: 30 000 · Tokeny wyjściowe na żądanie: 1500 · Żądania dziennie: 200
| Model | Dziennie | Miesięcznie |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
Co wybrać#
Agent kodujący na realnym repozytorium. W wierszach dotyczących kodowania samego dostawcy DeepSeek-V4.1-Flash-1017 prowadzi w większości. Zacznij test od DeepSeek-V4-Flash (identyfikator w kodzie powyżej) i dodaj Inkling do tych samych pięciu promptów. Przełączaj się tylko wtedy, gdy Inkling wygra na twoich zadaniach, a nie na zadaniach dostawcy. Jeśli chcesz tło samego wydania DeepSeek, zobacz co się zmieniło w deepseek-flash.
Strony internetowe i generowanie front-endu. Pozycja Inkling w DesignArena Website to najmocniejsze twierdzenie w wydaniu. Uruchom dwa lub trzy własne prompty stron na obu modelach i patrz na strony, a nie na liczby.
Samodzielny hosting później. Inkling to ten z planem otwartych wag, na licencji Apache 2.0. Dopóki pliki nie istnieją, to plan. Sprawdź stronę wydania ponownie, zanim cokolwiek na nim zbudujesz, a w międzyczasie możesz uruchomić te same prompty na modelu hostowanym z DeepSeek na CheapTokens.
Jeszcze jedna wskazówka, jeśli decydujesz według zadań: zachowaj pięć promptów i arkusz ocen. Następnym razem, gdy dostawca opublikuje tabelę, powtórzysz test w godzinę, zamiast ponownie czytać rankingi.


