โมเดลและการเปรียบเทียบการเปรียบเทียบ
Inkling 2 Small vs DeepSeek-V4.1-Flash: เลือกโมเดลใดสำหรับการเขียนโค้ด?
ตารางของผู้ขายวาง DeepSeek-V4.1-Flash นำในแถวด้านการเขียนโค้ดส่วนใหญ่ วิธีอ่าน รันการตรวจสอบ 5 พรอมต์บน repo ของคุณ และคำนวณต้นทุนต่องาน
ในหน้านี้
คำตอบสั้น ๆ: ในตารางที่ Thinking Machines เผยแพร่สำหรับ Inkling 2 Small (หน้าเผยแพร่เมื่อ 5 พฤศจิกายน 2026 ตรวจสอบเมื่อ 7 พฤศจิกายน) DeepSeek-V4.1-Flash-1017 นำอยู่ห้าในหกแถวด้านการเขียนโค้ดที่แสดงทั้งสองโมเดล Inkling นำอยู่หนึ่งแถว และมีอันดับด้านการออกแบบเว็บที่แข็งแกร่ง แต่นั่นเป็นตารางของผู้ขายเอง จึงควรถือเป็นเหตุผลให้ลองทดสอบเล็ก ๆ กับโค้ดของคุณ ไม่ใช่คำตัดสิน
ถ้าคุณเห็นพาดหัวข่าวทำนอง "Inkling ใกล้เคียง DeepSeek" และสงสัยว่าจะเปลี่ยน coding agent ของคุณหรือไม่ นี่คือลำดับที่ควรทำ: อ่านแถวที่ตรงกับงานของคุณ ดูว่าตารางแสดงอะไรไม่ได้ ลองใช้พรอมต์ห้าข้อของคุณเอง และคำนวณต้นทุนต่อหนึ่งงานที่เสร็จสมบูรณ์
Inkling 2 Small คืออะไร#
ตามหน้าเผยแพร่ Inkling 2 Small เป็นโมเดลรุ่นที่สองจาก Thinking Machines Lab เป็นโมเดล Mixture-of-Experts ที่มีพารามิเตอร์ทั้งหมด 594B และใช้งานจริง 17B ต่อโทเคน รองรับรูปภาพ (ไม่รองรับเสียง) และมีการตั้งค่าความพยายามแบบปรับได้ ตอนนี้รันบน Tinker ซึ่งเป็นบริการ inference แบบ serverless ของแล็บที่ยังอยู่ในช่วง Beta
มีสองรายละเอียดที่มองข้ามได้ง่าย ประการแรก น้ำหนักโมเดลยังปิดอยู่: แล็บวางแผนจะเผยแพร่ภายใต้ Apache 2.0 "สัปดาห์หน้า" หลังการทดสอบความปลอดภัยจากภายนอก และกล่าวว่าแพลตฟอร์มอื่นจะตามมา "ในอีกไม่กี่สัปดาห์" นั่นเป็นแผน ไม่ใช่ข้อเท็จจริง จนกว่าไฟล์จะออกมาจริง และประการที่สอง บริบท: รายการโมเดลของ Tinker แสดงค่าสูงสุดที่ 256K ตัวเลข 512K และ 1M บนหน้าเผยแพร่เป็นการตั้งค่าสำหรับการฝึกและประเมินผล ไม่ใช่สิ่งที่คุณส่งได้ในวันนี้
แฟลชการ์ด
คำศัพท์ที่คุณจะพบในการเปรียบเทียบนี้
แตะการ์ดเพื่อพลิก
วันที่สำคัญกว่าปกติในที่นี้ เพราะครึ่งหนึ่งของข้อเสนอเป็นคำสัญญา:
ไทม์ไลน์
Inkling 2 Small: ผู้ขายกล่าวอะไรและเมื่อไร
- 5 พ.ย. 2026เผยแพร่หน้าเพจ โมเดลพร้อมใช้งานบน Tinker (Beta)
- "สัปดาห์หน้า"แผนเผยแพร่ open-weights ภายใต้ Apache 2.0 หลังการทดสอบความปลอดภัยจากภายนอก
- "อีกไม่กี่สัปดาห์"ความพร้อมใช้งานบนแพลตฟอร์มอื่น
อ่านตารางทีละแถว#
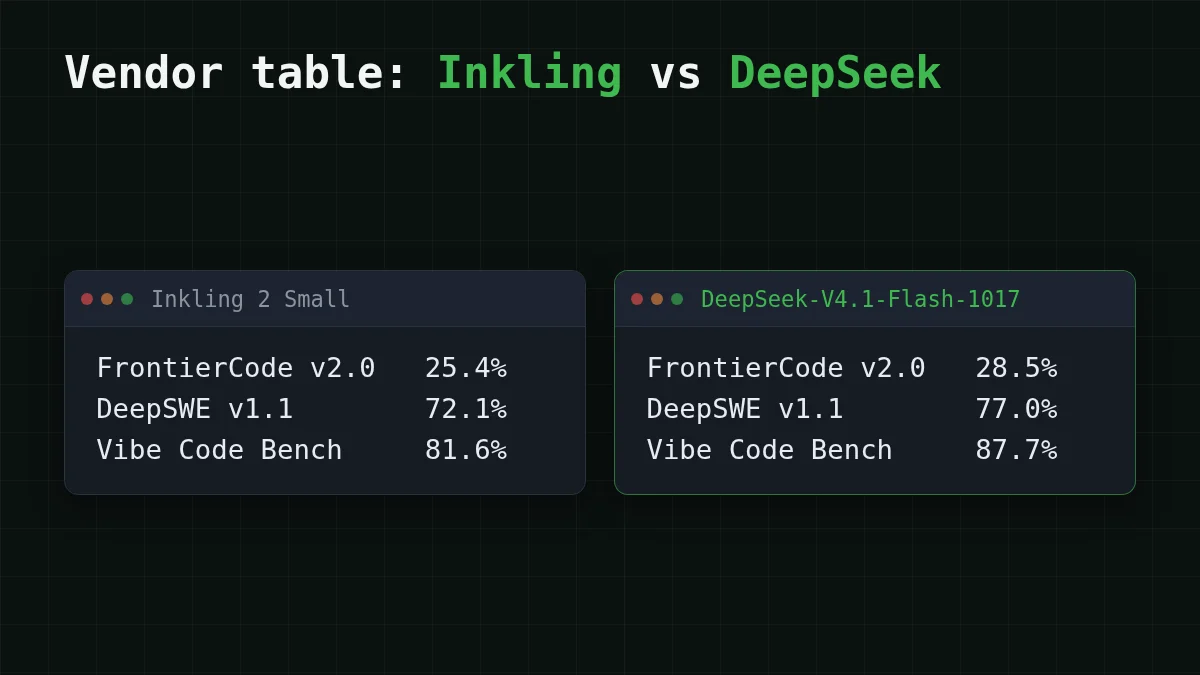
ผู้ขายเปรียบเทียบ Inkling 2 Small กับ DeepSeek-V4.1-Flash-1017 เอกสารของ DeepSeek ระบุว่า alias deepseek-flash ให้บริการโดยเวอร์ชันนั้นแล้ว (หน้าไม่มีวันที่ ตรวจสอบเมื่อ 7 พฤศจิกายน 2026) ต่อไปนี้คือแถวที่ทั้งสองโมเดลมีตัวเลข คอลัมน์สุดท้ายคือผลลบ
เลื่อนตารางไปทางขวา →
| แถว | Inkling 2 Small | DeepSeek-V4.1-Flash-1017 | ช่องว่าง, คะแนน |
|---|---|---|---|
| FrontierCode v2.0 | 25.4% | 28.5% | DeepSeek +3.1 |
| DeepSWE v1.1 | 72.1% | 77.0% | DeepSeek +4.9 |
| Vibe Code Bench v1.1 | 81.6% | 87.7% | DeepSeek +6.1 |
| Terminal Bench Science v0.1 | 5.7% | 12.9% | DeepSeek +7.2 |
| PostTrainBench v1.2 | 31.9% | 30.5% | Inkling +1.4 |
| PMPP-Hard (AUC) | 494.27 | 497.36 | DeepSeek +3.09 |
ตรวจสอบหนึ่งครั้ง: 77.0 - 72.1 = 4.9 นับแถวแล้ว DeepSeek นำอยู่ห้าแถว Inkling นำอยู่หนึ่งแถว
ทายตัวเลข
DeepSeek-V4.1-Flash-1017 นำอยู่กี่แถวจากหกแถวที่เทียบกันโดยตรง?
คำตอบของคุณ
06
แสดงคำตอบ
คำตอบ: 5
ห้าแถว: FrontierCode, DeepSWE, Vibe Code Bench, Terminal Bench Science และ PMPP-Hard Inkling นำเฉพาะ PostTrainBench
มีบางสิ่งที่ควรสังเกตก่อนคุณจะอ้างตารางนี้กับทีมของคุณ
- ช่องว่างที่ใหญ่ที่สุดอยู่ในแถวที่ยังไม่สมบูรณ์ที่สุด Terminal Bench Science อยู่ที่เวอร์ชัน 0.1 และ 12.9% เทียบกับ 5.7% นั้นมากกว่าสองเท่า เป็นเพียงเบาะแสเกี่ยวกับงานแบบ terminal ไม่ใช่คำตัดสิน
- หนึ่งแถวไม่มีการเทียบโดยตรง SWEBench Pro v2 (Hard) แสดง Inkling ที่ 86.3% และ DeepSeek ไม่ได้รายงาน คุณไม่สามารถเปรียบเทียบตัวเลขกับช่องว่างได้
- ช่องว่างเล็กก็เล็ก ช่องว่าง 1.4 หรือ 3.1 คะแนนบน benchmark ที่คุณไม่เคยรันอาจไม่คงอยู่เมื่อเปลี่ยน repo หรือพรอมต์
- หน้าเพจขัดแย้งกันเองหนึ่งจุด Artificial Analysis Intelligence Index คือ 31 ในข้อความ และ 30.6 (v5.0) ในตาราง โดยไม่มีคำอธิบาย เป็นเรื่องเล็ก แต่เตือนให้อ่านเชิงอรรถ
ยังไม่มีสิ่งใดได้รับการทำซ้ำอย่างอิสระ ตัวเลขทั้งหมดมาจากผู้ขาย Inkling
การออกแบบเว็บเป็นอีกแถวหนึ่ง#
ถ้างานของคุณคือการสร้างเว็บไซต์มากกว่าการแก้บั๊ก ตัวเลขที่เกี่ยวข้องคือ DesignArena Website ในสแนปช็อตวันที่ 5 พฤศจิกายนบนหน้าเผยแพร่ Inkling 2 Small ได้ 1,340 เป็นอันดับสามรองจาก Muse Wonder (1,366) และ Muse Spark 1.3 (1,351) ผู้ขายคาดว่าจะเป็นโมเดล open-weights อันดับหนึ่งในหมวดนั้นเมื่อน้ำหนักออกมา ช่องว่างถึงอันดับหนึ่งคือ 1,366 - 1,340 = 26 คะแนน
นั่นคือ leaderboard ของผู้คนที่เปรียบเทียบหน้าที่สร้างขึ้น จึงบอกอะไรจริงเกี่ยวกับรูปลักษณ์ แต่หน้าเพจไม่มีตัวเลข DeepSeek สำหรับแถวนี้ จึงไม่มีการเทียบโดยตรงให้อ่าน เปิด DesignArena เองก่อนพึ่งพาสแนปช็อต
สิ่งที่ไม่มีตารางใดแสดงได้#
สมมติคุณดูแล Django monolith อายุสิบปีที่มีเทสต์ช้าและกฎเฉพาะมากมาย benchmark ที่สร้างจาก repo ใหม่เรียบร้อยบอกคุณได้น้อยมากว่าโมเดลจัดการ utils.py ที่มี 3,000 บรรทัดของคุณอย่างไร มีสี่สิ่งที่ขาดหายจากตารางผู้ขายใด ๆ:
- โค้ดและนิสัยของคุณ การตั้งชื่อ สไตล์เทสต์ ไฟล์ที่ agent ไม่ควรแตะ
- พฤติกรรมของ agent loop โมเดลเดียวกันอาจทำได้ดีในเครื่องมือหนึ่งและแย่ในอีกเครื่องมือ เพราะเครื่องมือต่างกันในการป้อนไฟล์และข้อผิดพลาดให้มัน
- จำนวนขั้นตอนที่งานใช้ โมเดลที่ดีกว่าครั้งละ 3 คะแนนแต่ต้องลองหลายครั้งกว่าอาจไม่ดีกว่าสำหรับคุณ
- ราคา ราคาต่อโทเคนของ Inkling ไม่ได้อยู่ในหน้าเผยแพร่หรือรายการโมเดล Tinker (ตรวจสอบเมื่อ 7 พฤศจิกายน 2026) ดูหน้าราคาของ Tinker และใส่วันที่กำกับสิ่งที่คุณพบ
หากต้องการคำอธิบายยาวขึ้นเกี่ยวกับการอ่านตาราง benchmark มีบทความแยก: วิธีอ่าน AI benchmark และรันการทดสอบ 5 พรอมต์
การตรวจสอบ 5 พรอมต์บนโค้ดของคุณเอง#
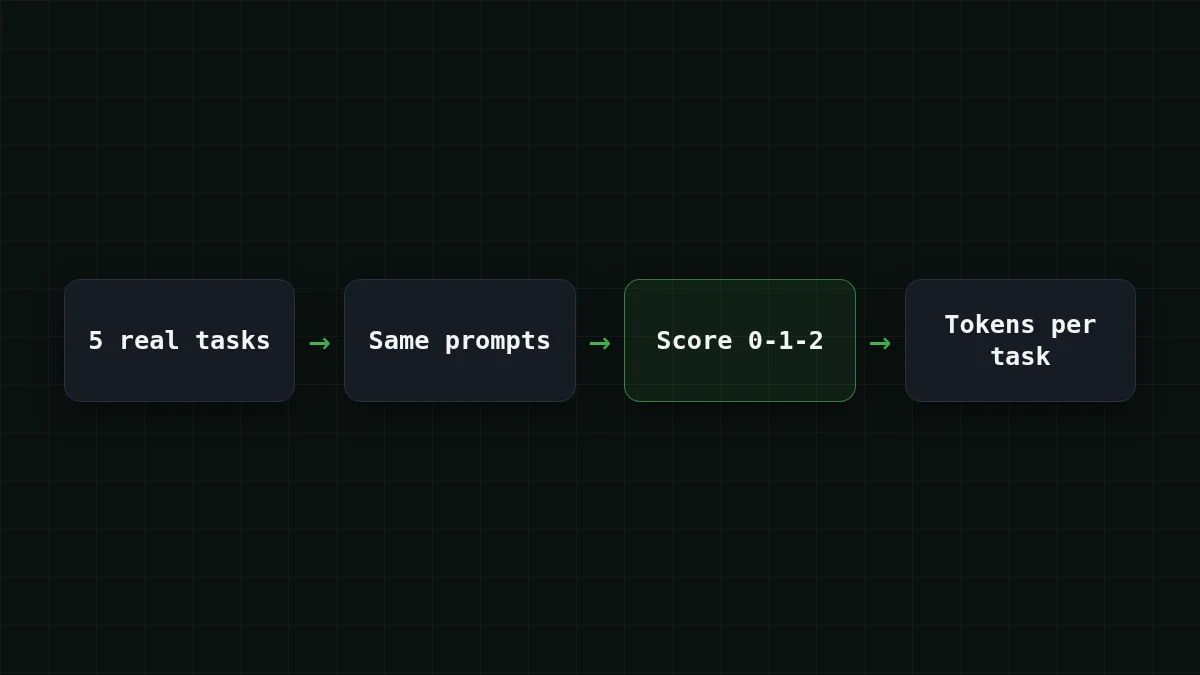
ใช้เวลาบ่ายหนึ่งและดีกว่า leaderboard ใด ๆ สำหรับการตัดสินใจของคุณ เลือกห้างานที่คุณทำจริงในสองสัปดาห์ที่ผ่านมา แต่ละงานมีวิธีบอกได้ว่าคำตอบถูกหรือไม่ ส่งข้อความเดียวกันไปยังแต่ละโมเดลและให้คะแนนผลด้วยตัวเอง
เช็กลิสต์
การตรวจสอบ 5 พรอมต์ของคุณ
สำหรับโมเดลที่คุณเรียกผ่าน API ที่เข้ากันได้กับ OpenAI ลูปนั้นสั้น ใส่ห้าพรอมต์ใน tasks.txt คั่นด้วยบรรทัดที่มี ===== อ่านเอกสารฉบับเต็มได้ที่ เอกสาร CheapTokens; ที่อยู่คือ https:/
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

tasks = open('tasks.txt').read().split('=====')
for i, task in enumerate(tasks, 1):
    r = client.chat.completions.create(
        model='deepseek-ai/DeepSeek-V4-Flash-0731',
        messages=[{'role': 'user', 'content': task.strip()}],
        max_tokens=4000,
    )
    u = r.usage
    print(i, u.prompt_tokens, u.completion_tokens, r.choices[0].finish_reason)
สิ่งที่คุณจะเห็นคือห้าบรรทัดของ task number, input tokens, output tokens, finish_ stop หมายความว่าโมเดลจบด้วยตัวเอง; length หมายความว่า max_tokens ตัดคำตอบ โมเดล id ที่นี่เป็นแบบเต็ม: deepseek- id แบบสั้นจากตารางราคาจะใช้ไม่ได้
DeepSeek-V4-Flash บน CheapTokens มีบริบท 380K สูงสุด 32,768 โทเคนในหนึ่งคำตอบ ราคาเดียวตลอดทั้งวัน และมี endpoint ที่เข้ากันได้กับ Anthropic ด้วย ดังนั้นห้าพรอมต์เดียวกันยังรันผ่านเครื่องมือที่สร้างบนรูปแบบนั้นได้ คะแนนจากห้าพรอมต์ของคุณเองคือสิ่งที่สำคัญสำหรับ repo ของคุณ สำหรับ Inkling 2 Small ส่งห้าข้อความเดียวกันผ่าน Tinker
ต้องการคู่แข่งที่สามและสี่บนงบเดียวกันหรือไม่? GLM-5.3-Flash (zai- บริบท 390K) และ MiniMax-M2.7 (MiniMaxAI/ บริบท 180K) ใช้การเรียกเดียวกันกับค่า model อีกค่า หากต้องการดูว่าโมเดล DeepSeek เปรียบเทียบกับ MiniMax อย่างไรในงานต่าง ๆ มี MiniMax-M2.7 vs DeepSeek-V4-Flash
ต้นทุนต่องาน ไม่ใช่ต่อโทเคน#
ราคาต่อล้านโทเคนไม่ใช่ราคาต่องานที่เสร็จสมบูรณ์ สิ่งที่คุณจ่ายคือจำนวนขั้นตอนคูณโทเคนในแต่ละขั้นตอน นับอินพุตและเอาต์พุตรวมกัน สมมติ agent ของคุณแก้บั๊กใน 20 ขั้นตอน และแต่ละขั้นตอนส่งประมาณ 30,000 โทเคนของไฟล์และประวัติ และได้กลับมาประมาณ 1,500 โทเคน หนึ่งขั้นตอนบน DeepSeek-V4-Flash ราคา $0.0006 งานทั้งหมด ตามราคาจริง:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 20 คำขอ | OpenRouter, 20 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.00066 | $0.0132 | $0.0226 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.0006 | $0.012 | $0.0462 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0017 | $0.0345 | $0.414 |
30,000 โทเค็นอินพุตและ 1,500 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
ตารางนั้นยังแสดงราคาอ้างอิงของ OpenRouter และโดยรวม เมื่อนับอินพุตและเอาต์พุตรวมกัน DeepSeek-V4-Flash บน CheapTokens ออกมาถูกกว่า อัตราต่อโทเคนของทุกโมเดลอยู่ในหน้าราคา
ตอนนี้ประเด็นที่สำคัญสำหรับการเปรียบเทียบ หากโมเดล A แก้งานใน 20 ขั้นตอน และโมเดล B ต้องใช้ 30 ขั้นตอน แล้ว 30 / 20 = 1.5 ดังนั้น B มีต้นทุนต่อหนึ่งงานมากกว่า 1.5 เท่าที่ราคาโทเคนเดียวกัน คะแนนเพิ่มไม่กี่จุดบน benchmark อาจถูกกลืนด้วยขั้นตอนที่เพิ่มขึ้นได้ง่าย และในทางกลับกัน นั่นคือเหตุผลที่การตรวจสอบ 5 พรอมต์บันทึกโทเคน: คุณจะเห็นขั้นตอนและโทเคนต่องาน ไม่ใช่แค่คะแนน เวอร์ชันยาวของแนวคิดนี้อยู่ใน ราคาต่อ 1M โทเคน vs ต้นทุนต่องาน
ใส่ตัวเลขของคุณเองลงในเครื่องคำนวณ ในตัวอย่างด้านล่าง 200 ครั้งคือ 10 งานต่อวันที่ 20 ขั้นตอนแต่ละงาน; เปลี่ยนโทเคนต่อขั้นตอนเป็นสิ่งที่การตรวจสอบของคุณแสดง
เครื่องคำนวณค่าใช้จ่าย
หนึ่งวันของ coding agent: 10 งาน 20 ขั้นตอนแต่ละงาน
โทเค็นอินพุตต่อคำขอ: 30,000 · โทเค็นเอาต์พุตต่อคำขอ: 1,500 · คำขอต่อวัน: 200
| โมเดล | ต่อวัน | ต่อเดือน |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.132 | $3.96 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.12 | $3.60 |
| MiniMax-M2.7$0.05$0.15 | $0.345 | $10.35 |
ควรเลือกอะไร#
Coding agent บน repo จริง ในแถวด้านการเขียนโค้ดของผู้ขายเอง DeepSeek-V4.1-Flash-1017 นำอยู่ส่วนใหญ่ เริ่มการตรวจสอบด้วย DeepSeek-V4-Flash (id ในโค้ดด้านบน) และเพิ่ม Inkling ในห้าพรอมต์เดียวกัน เปลี่ยนเฉพาะเมื่อ Inkling ชนะในงานของคุณ ไม่ใช่ในงานของผู้ขาย หากต้องการข้อมูลพื้นฐานเกี่ยวกับการเปิดตัว DeepSeek เอง ดู สิ่งที่เปลี่ยนใน deepseek-flash
เว็บไซต์และการสร้าง front-end อันดับ DesignArena Website ของ Inkling เป็นข้ออ้างที่แข็งแกร่งที่สุดในการเปิดตัว ลองพรอมต์หน้าเพจของคุณเองสองหรือสามข้อบนทั้งสองโมเดลและดูหน้าเพจ ไม่ใช่ตัวเลข
Self-hosting ในภายหลัง Inkling เป็นตัวที่มีแผน open-weights ภายใต้ Apache 2.0 จนกว่าไฟล์จะมีอยู่ มันเป็นแผน ตรวจสอบหน้าเผยแพร่อีกครั้งก่อนสร้างสิ่งใดรอบ ๆ และระหว่างนี้คุณสามารถรันพรอมต์เดียวกันกับโมเดลที่โฮสต์ด้วย DeepSeek บน CheapTokens
อีกเคล็ดลับหนึ่ง หากคุณตัดสินใจตามงาน: เก็บห้าพรอมต์และแผ่นให้คะแนนไว้ ครั้งต่อไปที่ผู้ขายเผยแพร่ตาราง คุณจะรันการตรวจสอบซ้ำในหนึ่งชั่วโมงแทนที่จะอ่านอันดับอีกครั้ง


