Pierwsze krokiPrzewodnik
Przejście z OpenRoutera na CheapTokens: base_url, klucz, id modelu
Zmień base_url, klucz API i id modelu w OpenAI SDK (Python i JavaScript), wyślij pierwsze żądanie i sprawdź, czy zadziałało.
Na tej stronie
Twoja aplikacja już wywołuje OpenRouter przez OpenAI SDK, a chcesz, żeby wywoływała CheapTokens. Zmieniasz trzy wartości — base_url, klucz API i id model — i usuwasz dwa opcjonalne nagłówki. Reszta kodu zostaje bez zmian.
Poniżej znajdziesz dokładne linie dla Pythona, JavaScriptu i curl, szybki sposób potwierdzenia, że przełączenie zadziałało, oraz tabelę, który model pasuje do jakiego zadania. Jeśli nigdy nie wysyłałeś żądania do CheapTokens, przewodnik po pierwszym żądaniu API omawia konto i klucz; dokumentacja zawiera pełne odniesienie.
Co faktycznie się zmienia#
Quickstart OpenRoutera (sprawdzony 27 października 2026) konfiguruje klienta OpenAI z bazowym URL https:/ i nazywa modele jako provider/. CheapTokens mówi tym samym formatem OpenAI Chat Completions pod https:/. Więc klasa klienta, chat. i sposób odczytu odpowiedzi się nie zmieniają.
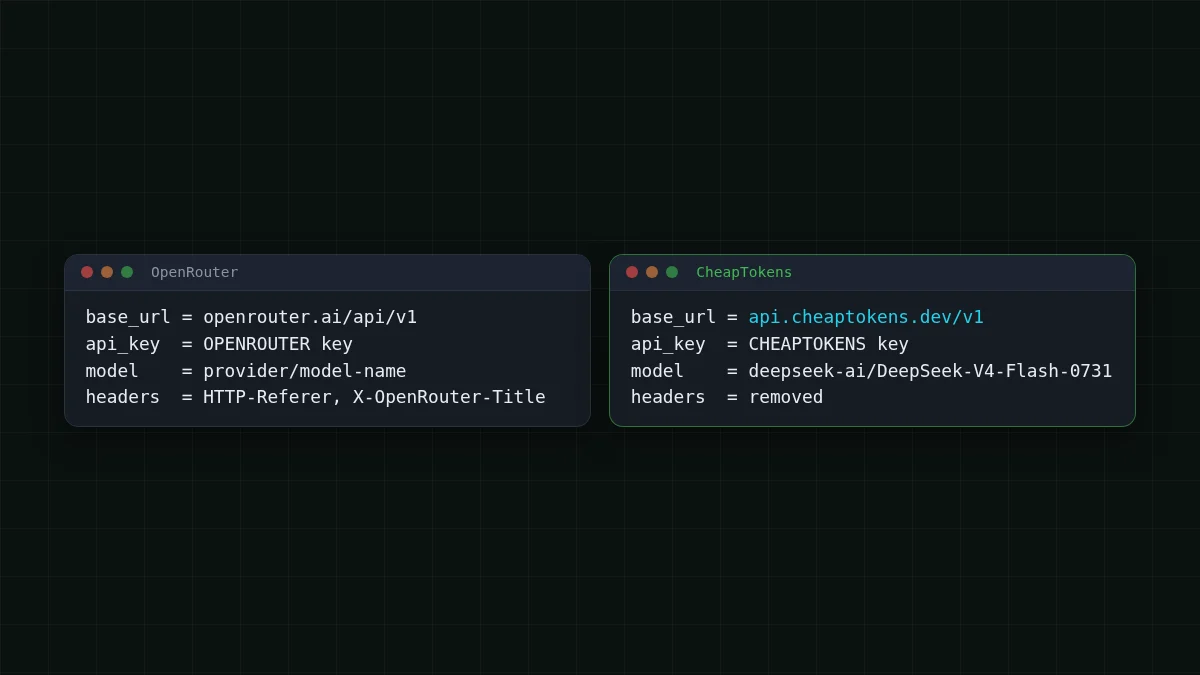
To jedna podmiana na linię:
- bazowy URL —
https:/zamiast adresu OpenRoutera;/ api. cheaptokens. dev/ v1 - klucz API — klucz z Twojego konta CheapTokens, odczytywany ze zmiennej środowiskowej;
- id modelu — pełne id CheapTokens, na przykład
deepseek-. Bierz id z dokumentacji CheapTokens: różni dostawcy nazywają ten sam model inaczej, a krótkie id z etykiet cenowych nie są akceptowane.ai/ DeepSeek- V4- Flash- 0731
I jedno usunięcie. Nagłówki HTTP-Referer i X- OpenRoutera są opcjonalne i zasilają tylko rankingi OpenRoutera. Usuń je z default_headers / defaultHeaders; tutaj nie są potrzebne.
Kod po przełączeniu#
To samo żądanie, trzy środowiska uruchomieniowe. Wybierz to, którego używa Twoja aplikacja.
Twój kod po przełączeniu
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

resp = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=[{'role': 'user', 'content': 'Reply with one word: ready'}],
    max_tokens=20,
)
print(resp.choices[0].message.content)
JavaScript
import OpenAI from 'openai';

const client = new OpenAI({
  baseURL: 'https://api.cheaptokens.dev/v1',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
});

const resp = await client.chat.completions.create({
  model: 'deepseek-ai/DeepSeek-V4-Flash-0731',
  messages: [{ role: 'user', content: 'Reply with one word: ready' }],
  max_tokens: 20,
});
console.log(resp.choices[0].message.content);
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Reply with one word: ready"}], "max_tokens": 20}'Jeszcze jedno przed uruchomieniem. Jeśli Twoje żądanie zawiera pola specyficzne dla OpenRoutera — listy routingu lub fallbacku, preferencje dostawcy, id modeli ~alias — należą one do OpenRoutera. Ogranicz żądanie do standardowych pól Chat Completions: model, messages, temperature, max_tokens, stream.
Sprawdź, czy zadziałało#
Odpowiedź to za mało. Wydrukuj obok niej trzy rzeczy: który model odpowiedział, dlaczego się zatrzymał i ile naliczono tokenów.
print(resp.model)
print(resp.choices[0].finish_reason)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)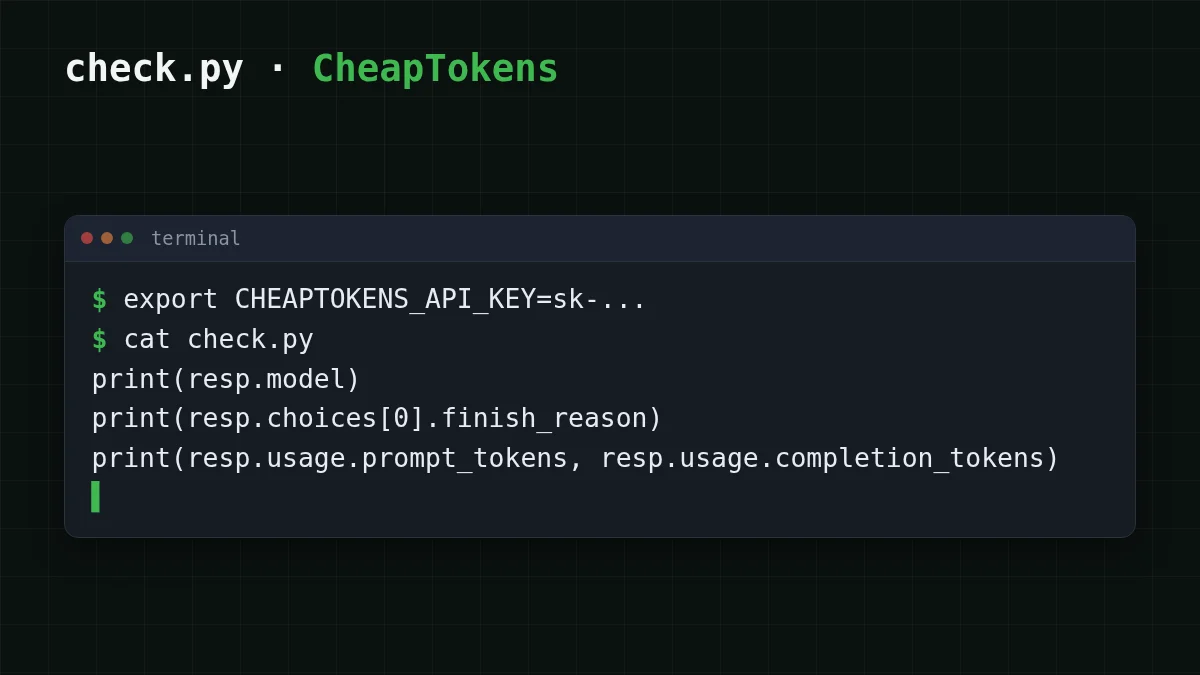
finish_reason równe stop oznacza, że model zakończył samodzielnie. length oznacza, że max_tokens przerwał odpowiedź. usage pokazuje tokeny wejściowe i wyjściowe osobno, a to są dwie liczby, z których składa się Twój rachunek — te same dwie, które śledziłeś na OpenRouterze.
Spróbuj samSpróbuj: co mówi finish_reason, jeśli ustawisz max_tokens na 1?Pokaż odpowiedź
Mówi length — odpowiedź została przerwana przez max_tokens. Dobry test, czy Twój kod obsługuje uciętą odpowiedź.
Który model co zastępuje#
Wybierz model według zadania, a nie według nazwy, której używałeś na OpenRouterze. Poniższe fakty pochodzą z cennika CheapTokens sprawdzonego 27 października 2026; jedno saldo obejmuje wszystkie trzy modele, a cena nie zmienia się z porą dnia.
Przewiń tabelę w prawo →
| Model | id model |
Kontekst | Maks. odpowiedź |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32 768 tokenów |
| GLM-5.3-Flash | zai- |
390K | 8 192 tokeny |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8 192 tokeny |
Nie wiesz, który wiersz jest Twój? Zacznij od tego, co robi aplikacja:
Wybierz swój przypadek
Co Twoja aplikacja robi najczęściej?
Wybierz opcję, aby zobaczyć odpowiedź
Krótkie, częste żądania — klasyfikacja, ekstrakcja, odpowiedzi wsparcia
Wypróbuj zai-: kontekst 390K, odpowiedzi do 8 192 tokenów, a w sumie jest tańszy niż OpenRouter, licząc wejście i wyjście razem.
Długie odpowiedzi, kod, pętle agentów
Wypróbuj deepseek-: odpowiedzi do 32 768 tokenów, kontekst 380K, jedna cena o każdej porze dnia.
Stałe obciążenie, za które obecnie płacisz wysoką stawkę OpenRoutera
Wypróbuj MiniMaxAI/: kontekst 180K, odpowiedzi do 8 192 tokenów, a w sumie wychodzi taniej niż OpenRouter.
Ile kosztuje ten sam ruch#
Załóżmy, że Twój bot wysyła 1000 żądań, każde z około 500 tokenami wejściowymi i 300 wyjściowymi. To założenie — podmień własne liczby z usage. Poniższa tabela jest aktualna: nasze ceny i kolumna OpenRoutera pochodzą z bieżącego cennika, licząc wejście i wyjście razem.
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 1000 żądań | OpenRouter, 1000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0434 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000038 | $0.0375 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00007 | $0.07 | $0.51 |
500 tokenów wejściowych i 300 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Na DeepSeek-V4-Flash te 1000 żądań to $0.0375. Pełne ceny są na stronie cennika; idea, za co płacisz, jest w tokeny wejściowe vs wyjściowe.
Jeśli nie działa#
Po przełączeniu trzy błędy pokrywają większość problemów. Dopasuj komunikat do przyczyny:
Dopasuj pary
Dopasuj każdy objaw do przyczyny
Dotknij element po lewej, a następnie jego parę
- 401 UnauthorizedBrakuje klucza, jest błędnie wpisany lub nadal jest to klucz OpenRoutera
- 404 Not FoundŚcieżka bazowego URL jest błędna lub id modelu nie jest pełnym id CheapTokens
- Odpowiedź ucięta w połowie zdaniamax_tokens jest niższe niż potrzebuje odpowiedź; finish_reason mówi length
Artykuł o rozwiązywaniu problemów z 401 i 404 przechodzi przez każdy z nich z dokładnymi komunikatami, a czym jest base_url wyjaśnia, dlaczego jeden zły ukośnik psuje ścieżkę.
Przed wdrożeniem#
Lista kontrolna
Lista kontrolna przełączenia


