Premiers pasGuide
Passer d'OpenRouter à CheapTokens : base_url, clé, id du modèle
Modifiez base_url, la clé API et l'id du modèle dans le SDK OpenAI (Python et JavaScript), envoyez une première requête et vérifiez que ça a fonctionné.
Sur cette page
Votre application appelle déjà OpenRouter via le SDK OpenAI, et vous souhaitez qu'elle appelle CheapTokens à la place. Vous modifiez trois valeurs — base_url, la clé API et l'id model — et supprimez deux en-têtes optionnels. Le reste du code reste inchangé.
Ci-dessous, les lignes exactes pour Python, JavaScript et curl, un moyen rapide de confirmer que le changement a fonctionné, et un tableau indiquant quel modèle convient à quelle tâche. Si vous n'avez jamais envoyé de requête à CheapTokens, le guide de la première requête API couvre le compte et la clé ; la documentation contient la référence complète.
Ce qui change réellement#
Le quickstart d'OpenRouter (vérifié le 27 octobre 2026) configure le client OpenAI avec l'URL de base https:/ et nomme les modèles sous la forme provider/. CheapTokens parle le même format OpenAI Chat Completions à l'adresse https:/. La classe du client, chat. et la façon dont vous lisez la réponse ne bougent donc pas.
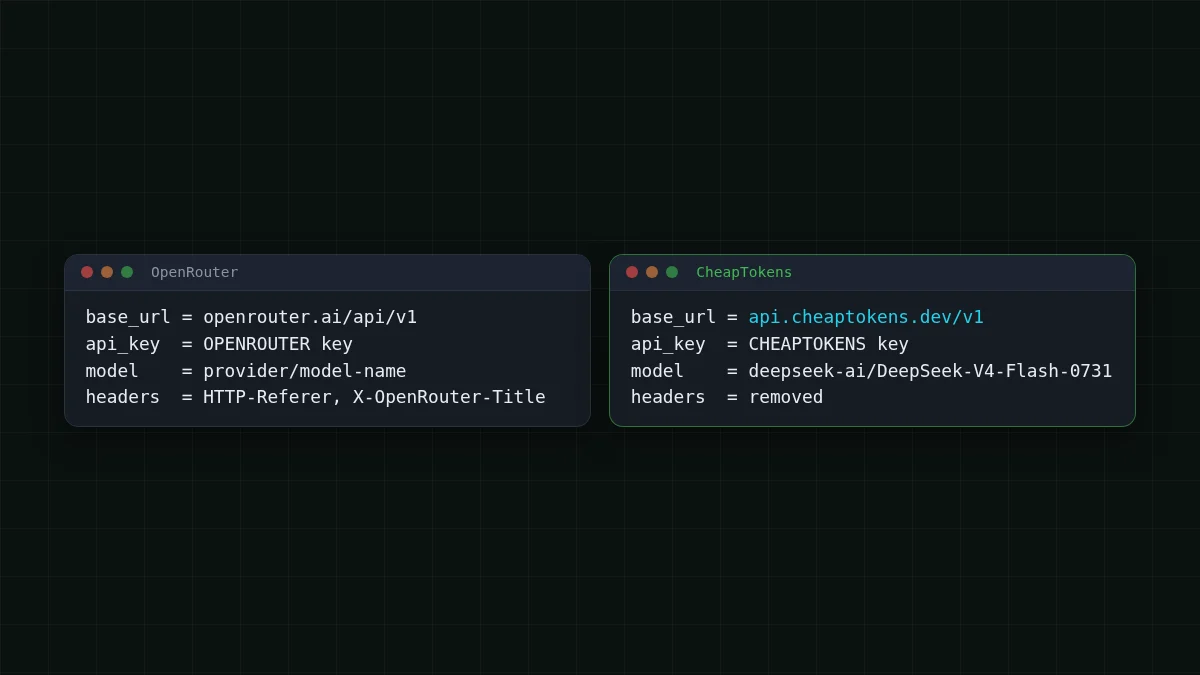
C'est un remplacement par ligne :
- URL de base —
https:/au lieu de l'adresse OpenRouter ;/ api. cheaptokens. dev/ v1 - clé API — une clé de votre compte CheapTokens, lue depuis une variable d'environnement ;
- id du modèle — l'id CheapTokens complet, par exemple
deepseek-. Prenez les ids dans la documentation CheapTokens : différents fournisseurs nomment différemment le même modèle, et les ids courts issus des étiquettes de prix ne sont pas acceptés.ai/ DeepSeek- V4- Flash- 0731
Et une suppression. Les en-têtes HTTP-Referer et X- d'OpenRouter sont optionnels et n'alimentent que les classements d'OpenRouter. Supprimez-les de default_headers / defaultHeaders ; vous n'en avez pas besoin ici.
Le code après le changement#
Même requête, trois environnements d'exécution. Choisissez celui que votre application utilise.
Votre code après le changement
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

resp = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=[{'role': 'user', 'content': 'Reply with one word: ready'}],
    max_tokens=20,
)
print(resp.choices[0].message.content)
JavaScript
import OpenAI from 'openai';

const client = new OpenAI({
  baseURL: 'https://api.cheaptokens.dev/v1',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
});

const resp = await client.chat.completions.create({
  model: 'deepseek-ai/DeepSeek-V4-Flash-0731',
  messages: [{ role: 'user', content: 'Reply with one word: ready' }],
  max_tokens: 20,
});
console.log(resp.choices[0].message.content);
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Reply with one word: ready"}], "max_tokens": 20}'Une dernière chose avant de l'exécuter. Si votre requête contient des champs propres à OpenRouter — listes de routage ou de fallback, préférences de fournisseur, ids de modèle ~alias — ils appartiennent à OpenRouter. Limitez la requête aux champs standard de Chat Completions : model, messages, temperature, max_tokens, stream.
Vérifier que ça a fonctionné#
Une réponse ne suffit pas comme preuve. Affichez trois choses à côté : quel modèle a répondu, pourquoi il s'est arrêté, et ce qu'il a facturé en tokens.
print(resp.model)
print(resp.choices[0].finish_reason)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)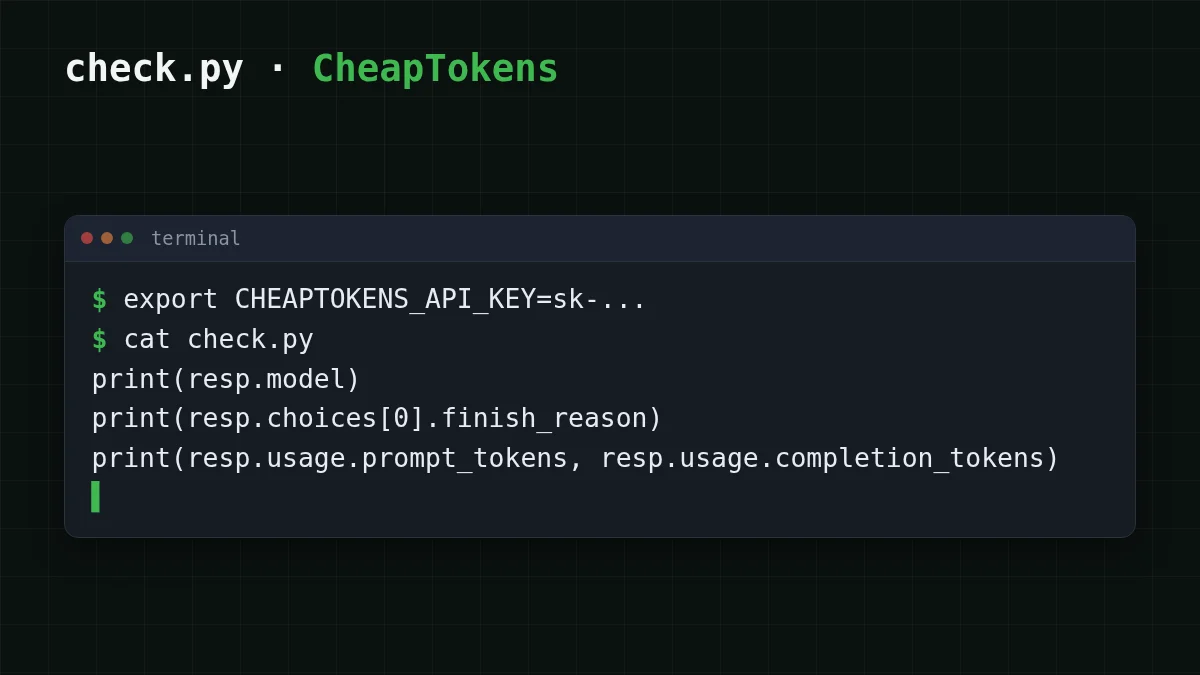
finish_reason de stop signifie que le modèle a terminé de lui-même. length signifie que max_tokens a coupé la réponse. usage affiche les tokens d'entrée et de sortie séparément, et ce sont ces deux nombres qui composent votre facture — les deux mêmes que vous suiviez sur OpenRouter.
Essayez vous-mêmeEssayez : que dit finish_reason si vous définissez max_tokens à 1 ?Afficher la réponse
Il dit length — la réponse a été coupée par max_tokens. Bon test pour vérifier que votre code gère une réponse tronquée.
Quel modèle remplace quoi#
Choisissez le modèle selon la tâche, pas selon le nom que vous utilisiez sur OpenRouter. Les faits ci-dessous proviennent de la liste de prix CheapTokens vérifiée le 27 octobre 2026 ; un seul solde couvre les trois modèles et le prix ne change pas selon l'heure de la journée.
Faites défiler le tableau vers la droite →
| Modèle | id model |
Contexte | Réponse max |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32 768 tokens |
| GLM-5.3-Flash | zai- |
390K | 8 192 tokens |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8 192 tokens |
Vous ne savez pas quelle ligne est la vôtre ? Partez de ce que fait l'application :
Choisissez votre cas
Que fait principalement votre application ?
Choisissez une option pour voir la réponse
Requêtes courtes et fréquentes — classification, extraction, réponses de support
Essayez zai- : contexte de 390K, réponses jusqu'à 8 192 tokens, et c'est moins cher qu'OpenRouter au total, entrée et sortie comptées ensemble.
Réponses longues, code, boucles d'agents
Essayez deepseek- : réponses jusqu'à 32 768 tokens, contexte de 380K, un seul prix à toute heure de la journée.
Une charge de travail régulière que vous payez actuellement au tarif OpenRouter élevé
Essayez MiniMaxAI/ : contexte de 180K, réponses jusqu'à 8 192 tokens, et au total c'est moins cher qu'OpenRouter.
Ce que coûte le même trafic#
Disons que votre bot envoie 1 000 requêtes, chacune avec environ 500 tokens d'entrée et 300 tokens de sortie. C'est une hypothèse — remplacez par vos propres chiffres issus de usage. Le tableau ci-dessous est à jour : nos prix et la colonne OpenRouter proviennent de la liste de prix actuelle, entrée et sortie comptées ensemble.
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 1 000 requêtes | OpenRouter, 1 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0434 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000038 | $0.0375 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00007 | $0.07 | $0.51 |
500 tokens d'entrée et 300 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
Sur DeepSeek-V4-Flash, ces 1 000 requêtes reviennent à $0.0375. Les prix complets sont sur la page de tarification ; le principe de ce qui vous est facturé est expliqué dans tokens d'entrée vs de sortie.
Si ça ne fonctionne pas#
Après un changement, trois erreurs couvrent la plupart des problèmes. Associez le message à la cause :
Associer les paires
Associez chaque symptôme à sa cause
Touchez un élément à gauche, puis sa paire
- 401 UnauthorizedLa clé est absente, mal saisie, ou c'est encore celle d'OpenRouter
- 404 Not FoundLe chemin de l'URL de base est incorrect ou l'id du modèle n'est pas un id CheapTokens complet
- Réponse coupée en milieu de phrasemax_tokens est inférieur à ce que la réponse nécessite ; finish_reason indique length
L'article de dépannage 401 et 404 détaille chacun avec les messages exacts, et ce qu'est base_url explique pourquoi une barre oblique incorrecte casse le chemin.
Avant de livrer#
Liste de contrôle
Liste de vérification du changement


