Erste SchritteAnleitung
Von OpenRouter zu CheapTokens wechseln: base_url, Schlüssel, Modell-ID
Ändere base_url, API-Schlüssel und Modell-ID im OpenAI SDK (Python und JavaScript), sende eine erste Anfrage und prüfe, ob es funktioniert hat.
Auf dieser Seite
Deine App ruft OpenRouter bereits über das OpenAI SDK auf, und du möchtest stattdessen CheapTokens aufrufen. Du änderst drei Werte — base_url, den API-Schlüssel und die model-ID — und löschst zwei optionale Header. Der restliche Code bleibt unverändert.
Unten findest du die exakten Zeilen für Python, JavaScript und curl, eine schnelle Möglichkeit zu prüfen, ob die Umstellung funktioniert hat, und eine Tabelle, welches Modell zu welcher Aufgabe passt. Wenn du noch nie eine Anfrage an CheapTokens gesendet hast, deckt der Leitfaden zur ersten API-Anfrage Konto und Schlüssel ab; die Dokumentation enthält die vollständige Referenz.
Was sich tatsächlich ändert#
Der Quickstart von OpenRouter (geprüft am 27. Oktober 2026) konfiguriert den OpenAI-Client mit der Basis-URL https:/ und benennt Modelle als provider/. CheapTokens spricht dasselbe OpenAI-Chat-Completions-Format unter https:/. Die Client-Klasse, chat. und die Art, wie du die Antwort liest, ändern sich also nicht.
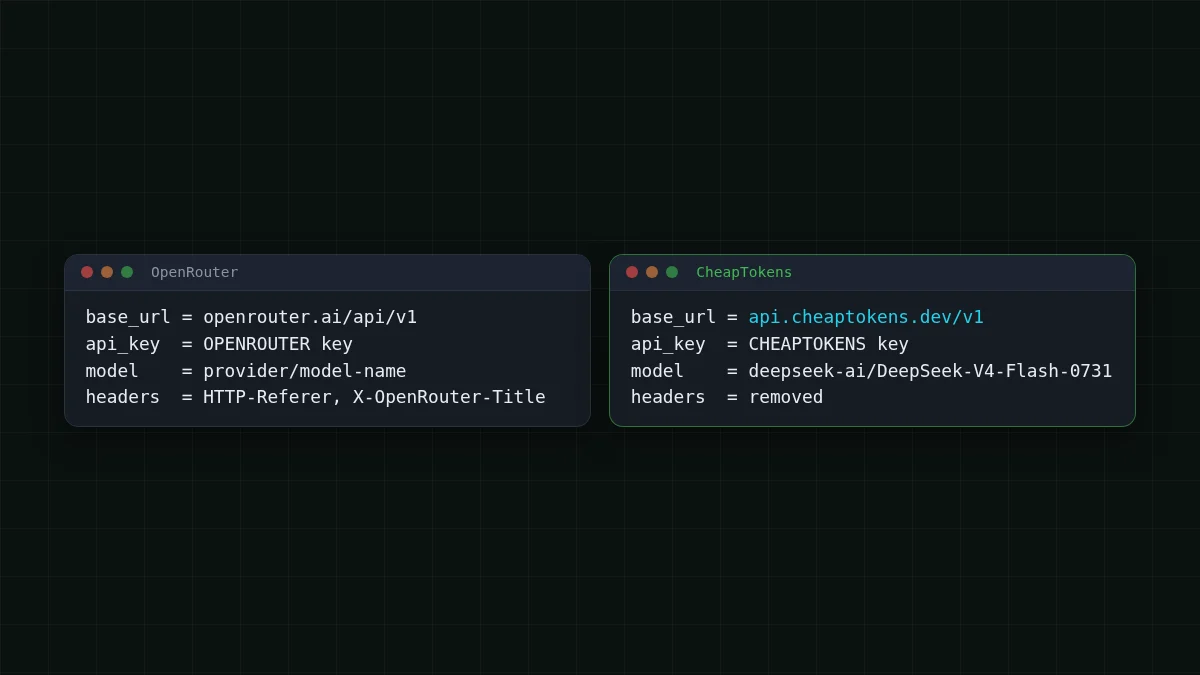
Das ist ein Tausch pro Zeile:
- Basis-URL —
https:/statt der OpenRouter-Adresse;/ api. cheaptokens. dev/ v1 - API-Schlüssel — ein Schlüssel aus deinem CheapTokens-Konto, gelesen aus einer Umgebungsvariable;
- Modell-ID — die vollständige CheapTokens-ID, zum Beispiel
deepseek-. Nimm IDs aus der CheapTokens-Dokumentation: verschiedene Anbieter benennen dasselbe Modell unterschiedlich, und kurze IDs aus Preisangaben werden nicht akzeptiert.ai/ DeepSeek- V4- Flash- 0731
Und eine Löschung. Die Header HTTP-Referer und X- von OpenRouter sind optional und speisen nur die Leaderboards von OpenRouter. Entferne sie aus default_headers / defaultHeaders; hier brauchst du sie nicht.
Der Code nach der Umstellung#
Dieselbe Anfrage, drei Laufzeitumgebungen. Wähle die, die deine App verwendet.
Dein Code nach der Umstellung
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

resp = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=[{'role': 'user', 'content': 'Reply with one word: ready'}],
    max_tokens=20,
)
print(resp.choices[0].message.content)
JavaScript
import OpenAI from 'openai';

const client = new OpenAI({
  baseURL: 'https://api.cheaptokens.dev/v1',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
});

const resp = await client.chat.completions.create({
  model: 'deepseek-ai/DeepSeek-V4-Flash-0731',
  messages: [{ role: 'user', content: 'Reply with one word: ready' }],
  max_tokens: 20,
});
console.log(resp.choices[0].message.content);
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Reply with one word: ready"}], "max_tokens": 20}'Noch etwas, bevor du es ausführst. Wenn deine Anfrage OpenRouter-spezifische Felder enthält — Routing- oder Fallback-Listen, Anbieterpräferenzen, ~alias-Modell-IDs — gehören diese zu OpenRouter. Beschränke die Anfrage auf Standard-Chat-Completions-Felder: model, messages, temperature, max_tokens, stream.
Prüfen, ob es funktioniert hat#
Eine Antwort ist kein ausreichender Beweis. Gib drei Dinge daneben aus: welches Modell geantwortet hat, warum es gestoppt ist und wie viele Tokens es abgerechnet hat.
print(resp.model)
print(resp.choices[0].finish_reason)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)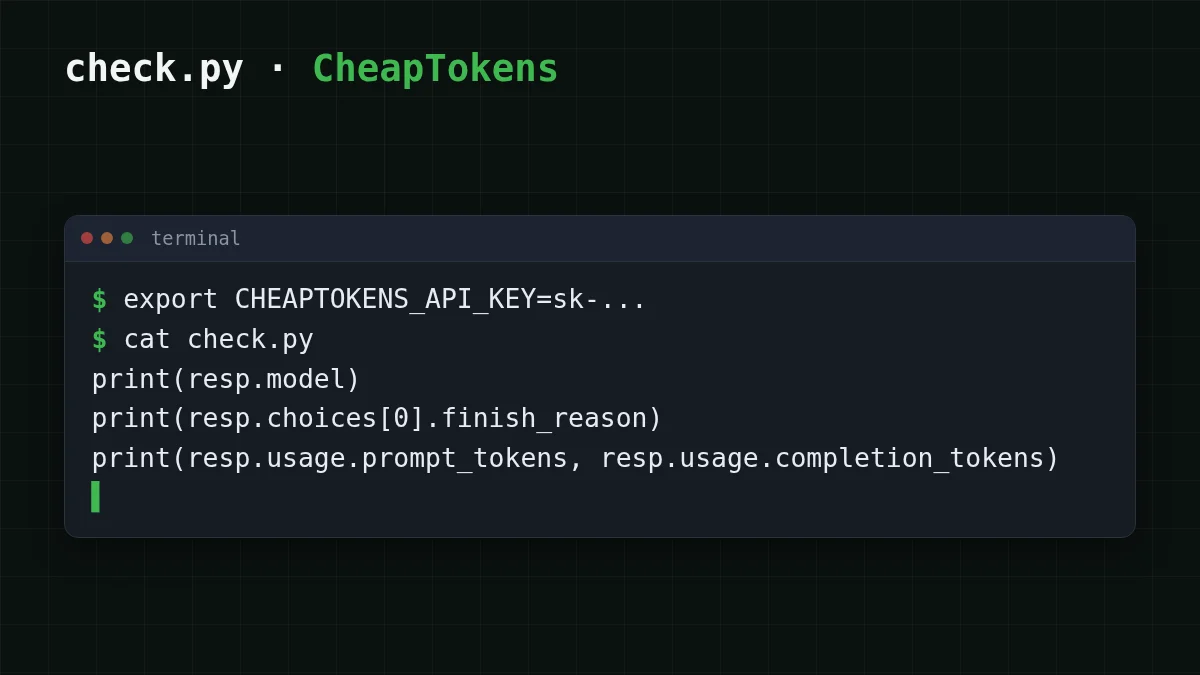
finish_reason von stop bedeutet, dass das Modell von selbst fertig wurde. length bedeutet, dass max_tokens die Antwort abgeschnitten hat. usage zeigt Input- und Output-Tokens getrennt, und aus diesen beiden Zahlen setzt sich deine Rechnung zusammen — dieselben zwei, die du bei OpenRouter verfolgt hast.
Probier es selbstProbier es aus: Was sagt finish_reason, wenn du max_tokens auf 1 setzt?Antwort anzeigen
Es sagt length — die Antwort wurde durch max_tokens abgeschnitten. Ein guter Test, ob dein Code eine abgeschnittene Antwort verarbeitet.
Welches Modell was ersetzt#
Wähle das Modell nach der Aufgabe, nicht nach dem Namen, den du bei OpenRouter verwendet hast. Die folgenden Fakten stammen aus der Preisliste von CheapTokens, geprüft am 27. Oktober 2026; ein Guthaben deckt alle drei Modelle ab, und der Preis ändert sich nicht mit der Tageszeit.
Tabelle nach rechts scrollen →
| Modell | model-ID |
Kontext | Max. Antwort |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32.768 Tokens |
| GLM-5.3-Flash | zai- |
390K | 8.192 Tokens |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8.192 Tokens |
Nicht sicher, welche Zeile deine ist? Geh davon aus, was die App tut:
Wähle deinen Fall
Was macht deine App hauptsächlich?
Wähle eine Option, um die Antwort zu sehen
Kurze, häufige Anfragen — Klassifizierung, Extraktion, Support-Antworten
Probiere zai-: 390K Kontext, Antworten bis 8.192 Tokens, und insgesamt günstiger als OpenRouter, Input und Output zusammengerechnet.
Lange Antworten, Code, Agent-Schleifen
Probiere deepseek-: Antworten bis 32.768 Tokens, 380K Kontext, ein Preis zu jeder Tageszeit.
Eine gleichmäßige Last, für die du derzeit einen hohen OpenRouter-Tarif zahlst
Probiere MiniMaxAI/: 180K Kontext, Antworten bis 8.192 Tokens, und insgesamt günstiger als OpenRouter.
Was derselbe Traffic kostet#
Angenommen, dein Bot sendet 1.000 Anfragen mit jeweils etwa 500 Input-Tokens und 300 Output-Tokens. Das ist eine Annahme — setze deine eigenen Zahlen aus usage ein. Die folgende Tabelle ist live: unsere Preise und die OpenRouter-Spalte stammen aus der aktuellen Preisliste, Input und Output zusammengerechnet.
| Modell | Input $/1M | Output $/1M | Pro Anfrage | 1.000 Anfragen | OpenRouter, 1.000 Anfragen |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0434 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000038 | $0.0375 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00007 | $0.07 | $0.51 |
500 Input- und 300 Output-Tokens pro Anfrage. Die Preise pro 1 Mio. Tokens sind aktuell und ändern sich zusammen mit unseren Tarifen; die OpenRouter-Spalte zeigt Referenzpreise für dieselbe Arbeitslast.
Bei DeepSeek-V4-Flash kommen diese 1.000 Anfragen auf $0.0375. Vollständige Preise findest du auf der Preisseite; was dir berechnet wird, erklärt Input vs. Output-Tokens.
Wenn es nicht funktioniert#
Nach einer Umstellung decken drei Fehler die meisten Probleme ab. Ordne die Meldung der Ursache zu:
Paare zuordnen
Ordne jedes Symptom seiner Ursache zu
Tippe auf ein Element links, dann auf sein Paar
- 401 UnauthorizedDer Schlüssel fehlt, ist falsch geschrieben oder noch der von OpenRouter
- 404 Not FoundDer Pfad der Basis-URL ist falsch oder die Modell-ID ist keine vollständige CheapTokens-ID
- Antwort mitten im Satz abgeschnittenmax_tokens ist niedriger als die Antwort benötigt; finish_reason sagt length
Der Artikel zur Fehlerbehebung bei 401 und 404 geht jeden Fall mit den exakten Meldungen durch, und was base_url ist erklärt, warum ein falscher Schrägstrich den Pfad bricht.
Bevor du auslieferst#
Checkliste
Checkliste für die Umstellung


