Per iniziareGuida
Passare da OpenRouter a CheapTokens: base_url, chiave, id del modello
Cambia base_url, chiave API e id del modello nell'SDK OpenAI (Python e JavaScript), invia una prima richiesta e verifica che abbia funzionato.
In questa pagina
La tua app chiama già OpenRouter tramite l'SDK OpenAI e vuoi che chiami CheapTokens. Cambi tre valori — base_url, la chiave API e l'id model — ed elimini due header opzionali. Il resto del codice resta com'è.
Qui sotto trovi le righe esatte per Python, JavaScript e curl, un modo rapido per confermare che il passaggio ha funzionato e una tabella che indica quale modello si adatta a quale compito. Se non hai mai inviato una richiesta a CheapTokens, la guida alla prima richiesta API copre account e chiave; la documentazione contiene il riferimento completo.
Cosa cambia davvero#
La quickstart di OpenRouter (verificata il 27 ottobre 2026) configura il client OpenAI con il base URL https:/ e nomina i modelli come provider/. CheapTokens parla lo stesso formato OpenAI Chat Completions su https:/. Quindi la classe del client, chat. e il modo in cui leggi la risposta non cambiano.
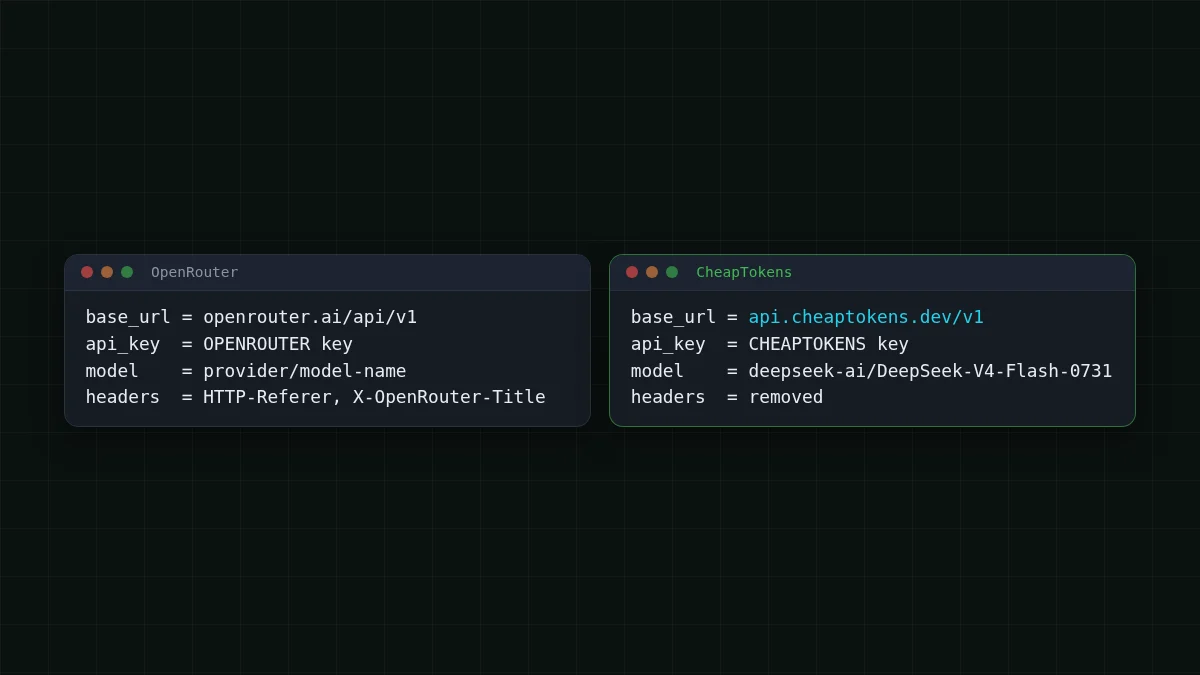
È una sostituzione per riga:
- base URL —
https:/invece dell'indirizzo OpenRouter;/ api. cheaptokens. dev/ v1 - chiave API — una chiave del tuo account CheapTokens, letta da una variabile d'ambiente;
- id del modello — l'id completo CheapTokens, ad esempio
deepseek-. Prendi gli id dalla documentazione CheapTokens: provider diversi nominano lo stesso modello in modo diverso, e gli id brevi delle etichette di prezzo non sono accettati.ai/ DeepSeek- V4- Flash- 0731
E una eliminazione. Gli header HTTP-Referer e X- di OpenRouter sono opzionali e alimentano solo le classifiche di OpenRouter. Rimuovili da default_headers / defaultHeaders; qui non ti servono.
Il codice dopo il passaggio#
Stessa richiesta, tre runtime. Scegli quello che usa la tua app.
Il tuo codice dopo il passaggio
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

resp = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=[{'role': 'user', 'content': 'Reply with one word: ready'}],
    max_tokens=20,
)
print(resp.choices[0].message.content)
JavaScript
import OpenAI from 'openai';

const client = new OpenAI({
  baseURL: 'https://api.cheaptokens.dev/v1',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
});

const resp = await client.chat.completions.create({
  model: 'deepseek-ai/DeepSeek-V4-Flash-0731',
  messages: [{ role: 'user', content: 'Reply with one word: ready' }],
  max_tokens: 20,
});
console.log(resp.choices[0].message.content);
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Reply with one word: ready"}], "max_tokens": 20}'Un'altra cosa prima di eseguirlo. Se la tua richiesta contiene campi esclusivi di OpenRouter — liste di routing o fallback, preferenze del provider, id modello ~alias — quelli appartengono a OpenRouter. Mantieni la richiesta sui campi standard di Chat Completions: model, messages, temperature, max_tokens, stream.
Verifica che abbia funzionato#
Una risposta non è prova sufficiente. Stampa tre cose accanto ad essa: quale modello ha risposto, perché si è fermato e quanti token ha addebitato.
print(resp.model)
print(resp.choices[0].finish_reason)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)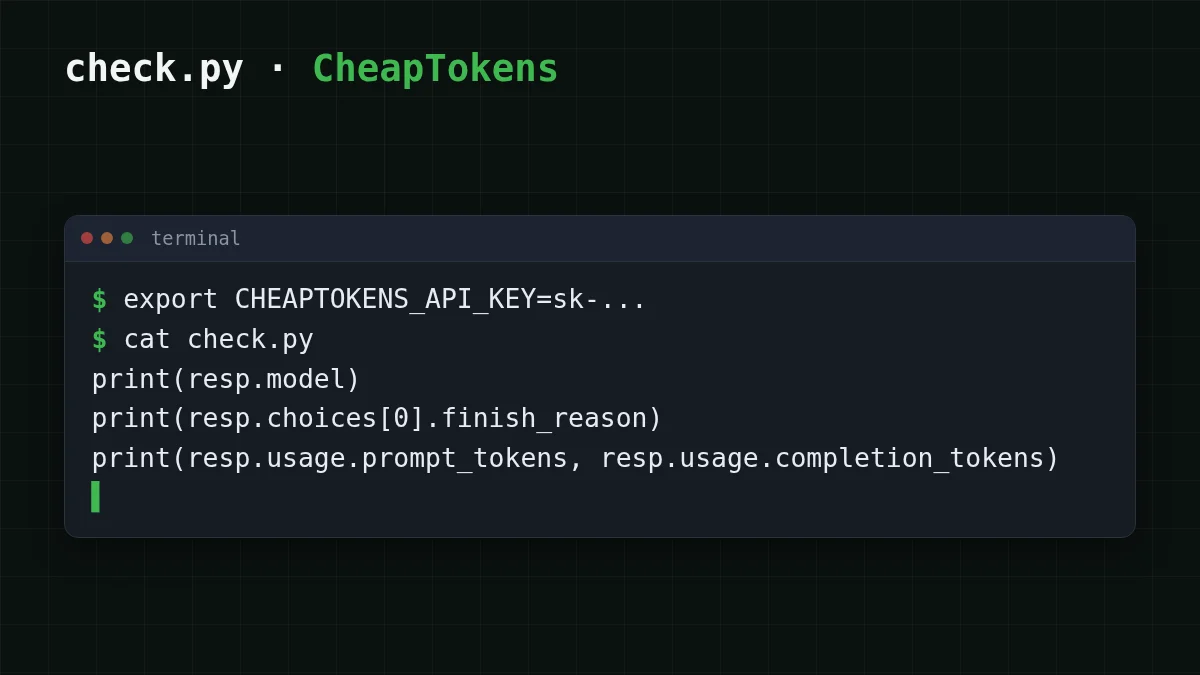
finish_reason di stop significa che il modello ha terminato da solo. length significa che max_tokens ha interrotto la risposta. usage mostra i token di input e di output separatamente, e sono i due numeri su cui si basa la tua fattura — gli stessi due che tenevi sotto controllo su OpenRouter.
Provalo tu stessoProva: cosa dice finish_reason se imposti max_tokens a 1?Mostra risposta
Dice length — la risposta è stata interrotta da max_tokens. Un buon test per verificare che il tuo codice gestisca una risposta troncata.
Quale modello sostituisce cosa#
Scegli il modello in base al compito, non in base al nome che usavi su OpenRouter. I dati qui sotto provengono dal listino prezzi CheapTokens verificato il 27 ottobre 2026; un solo saldo copre tutti e tre i modelli e il prezzo non cambia con l'ora del giorno.
Scorri la tabella verso destra →
| Modello | id model |
Contesto | Risposta max |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32.768 token |
| GLM-5.3-Flash | zai- |
390K | 8.192 token |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8.192 token |
Non sai quale riga è la tua? Parti da cosa fa l'app:
Scegli il tuo caso
Cosa fa principalmente la tua app?
Scegli un'opzione per vedere la risposta
Richieste brevi e frequenti — classificazione, estrazione, risposte al supporto
Prova zai-: contesto da 390K, risposte fino a 8.192 token, ed è più economico di OpenRouter in totale, input e output sommati insieme.
Risposte lunghe, codice, cicli di agenti
Prova deepseek-: risposte fino a 32.768 token, contesto da 380K, un unico prezzo a qualsiasi ora del giorno.
Un carico di lavoro costante per cui oggi paghi una tariffa OpenRouter elevata
Prova MiniMaxAI/: contesto da 180K, risposte fino a 8.192 token, e in totale risulta più economico di OpenRouter.
Quanto costa lo stesso traffico#
Supponiamo che il tuo bot invii 1.000 richieste, ciascuna con circa 500 token di input e 300 di output. È un'ipotesi — sostituiscila con i tuoi numeri da usage. La tabella qui sotto è aggiornata: i nostri prezzi e la colonna OpenRouter provengono dal listino attuale, input e output sommati insieme.
| Modello | Input $/1M | Output $/1M | Per richiesta | 1000 richieste | OpenRouter, 1000 richieste |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0434 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000038 | $0.0375 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00007 | $0.07 | $0.51 |
500 token di input e 300 token di output per richiesta. I prezzi per 1M di token sono attuali e cambiano insieme alle nostre tariffe; la colonna OpenRouter mostra i prezzi di riferimento per lo stesso carico di lavoro.
Su DeepSeek-V4-Flash quelle 1.000 richieste arrivano a $0.0375. I prezzi completi sono nella pagina dei prezzi; il concetto di cosa ti viene addebitato è in input vs output tokens.
Se non funziona#
Dopo un passaggio, tre errori coprono la maggior parte dei problemi. Abbina il messaggio alla causa:
Abbina le coppie
Abbina ogni sintomo alla sua causa
Tocca un elemento a sinistra, poi il suo abbinamento
- 401 UnauthorizedLa chiave manca, è scritta male o è ancora quella di OpenRouter
- 404 Not FoundIl percorso del base URL è sbagliato o l'id del modello non è un id CheapTokens completo
- Risposta interrotta a metà frasemax_tokens è inferiore a quanto serve alla risposta; finish_reason dice length
L'articolo sulla risoluzione dei problemi 401 e 404 esamina ciascuno con i messaggi esatti, e cos'è base_url spiega perché una sola barra sbagliata rompe il percorso.
Prima di pubblicare#
Lista di controllo
Checklist del passaggio


