Primeros pasosGuía
Cambia de OpenRouter a CheapTokens: base_url, clave, id del modelo
Cambia base_url, la clave de API y el id del modelo en el SDK de OpenAI (Python y JavaScript), envía una primera petición y comprueba que funcionó.
En esta página
Tu aplicación ya llama a OpenRouter a través del SDK de OpenAI, y quieres que llame a CheapTokens en su lugar. Cambias tres valores — base_url, la clave de API y el id de model — y eliminas dos cabeceras opcionales. El resto del código se queda como está.
A continuación tienes las líneas exactas para Python, JavaScript y curl, una forma rápida de confirmar que el cambio funcionó y una tabla de qué modelo encaja con qué tarea. Si nunca has enviado una petición a CheapTokens, la guía de la primera petición a la API cubre la cuenta y la clave; la documentación tiene la referencia completa.
Qué cambia realmente#
El quickstart de OpenRouter (consultado el 27 de octubre de 2026) configura el cliente de OpenAI con la URL base https:/ y nombra los modelos como provider/. CheapTokens habla el mismo formato OpenAI Chat Completions en https:/. Así que la clase del cliente, chat. y la forma de leer la respuesta no se mueven.
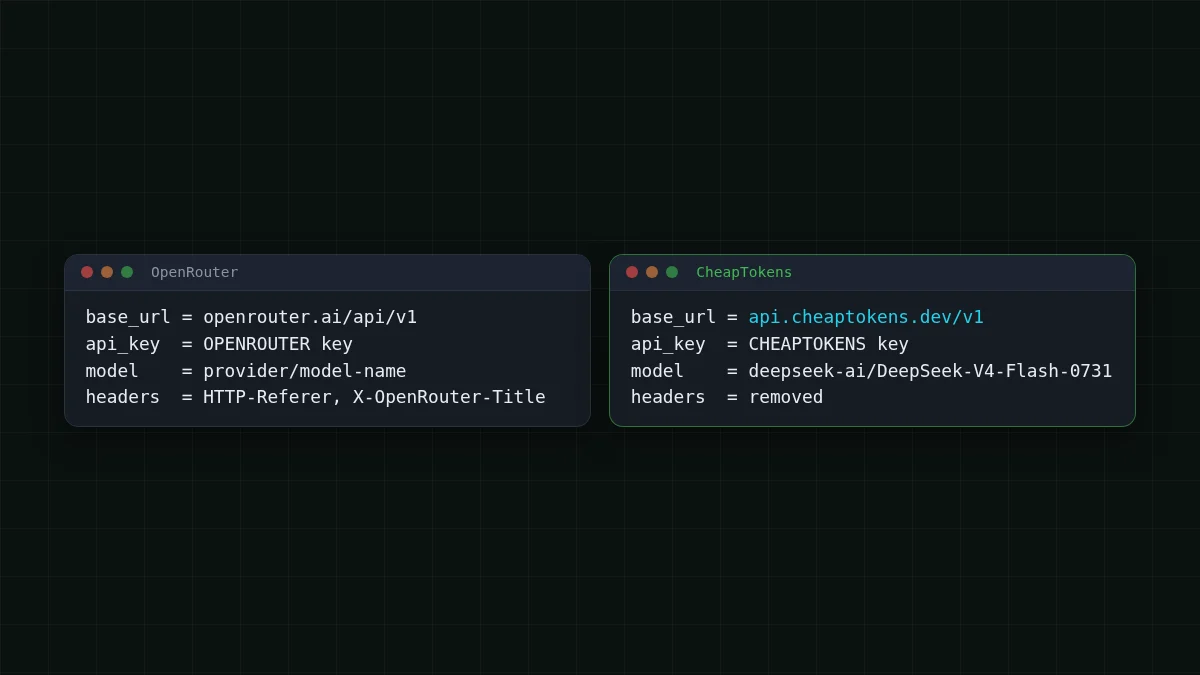
Eso es un cambio por línea:
- URL base —
https:/en lugar de la dirección de OpenRouter;/ api. cheaptokens. dev/ v1 - clave de API — una clave de tu cuenta de CheapTokens, leída desde una variable de entorno;
- id del modelo — el id completo de CheapTokens, por ejemplo
deepseek-. Toma los ids de la documentación de CheapTokens: distintos proveedores nombran el mismo modelo de forma diferente, y los ids cortos de las etiquetas de precio no se aceptan.ai/ DeepSeek- V4- Flash- 0731
Y una eliminación. Las cabeceras HTTP-Referer y X- de OpenRouter son opcionales y solo alimentan las clasificaciones de OpenRouter. Elimínalas de default_headers / defaultHeaders; aquí no las necesitas.
El código después del cambio#
La misma petición, tres entornos de ejecución. Elige el que use tu aplicación.
Tu código después del cambio
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

resp = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=[{'role': 'user', 'content': 'Reply with one word: ready'}],
    max_tokens=20,
)
print(resp.choices[0].message.content)
JavaScript
import OpenAI from 'openai';

const client = new OpenAI({
  baseURL: 'https://api.cheaptokens.dev/v1',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
});

const resp = await client.chat.completions.create({
  model: 'deepseek-ai/DeepSeek-V4-Flash-0731',
  messages: [{ role: 'user', content: 'Reply with one word: ready' }],
  max_tokens: 20,
});
console.log(resp.choices[0].message.content);
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Reply with one word: ready"}], "max_tokens": 20}'Una cosa más antes de ejecutarlo. Si tu petición lleva campos exclusivos de OpenRouter — listas de enrutamiento o de fallback, preferencias de proveedor, ids de modelo ~alias — esos pertenecen a OpenRouter. Limita la petición a los campos estándar de Chat Completions: model, messages, temperature, max_tokens, stream.
Comprueba que funcionó#
Una respuesta no es prueba suficiente. Imprime tres cosas junto a ella: qué modelo respondió, por qué se detuvo y cuántos tokens facturó.
print(resp.model)
print(resp.choices[0].finish_reason)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)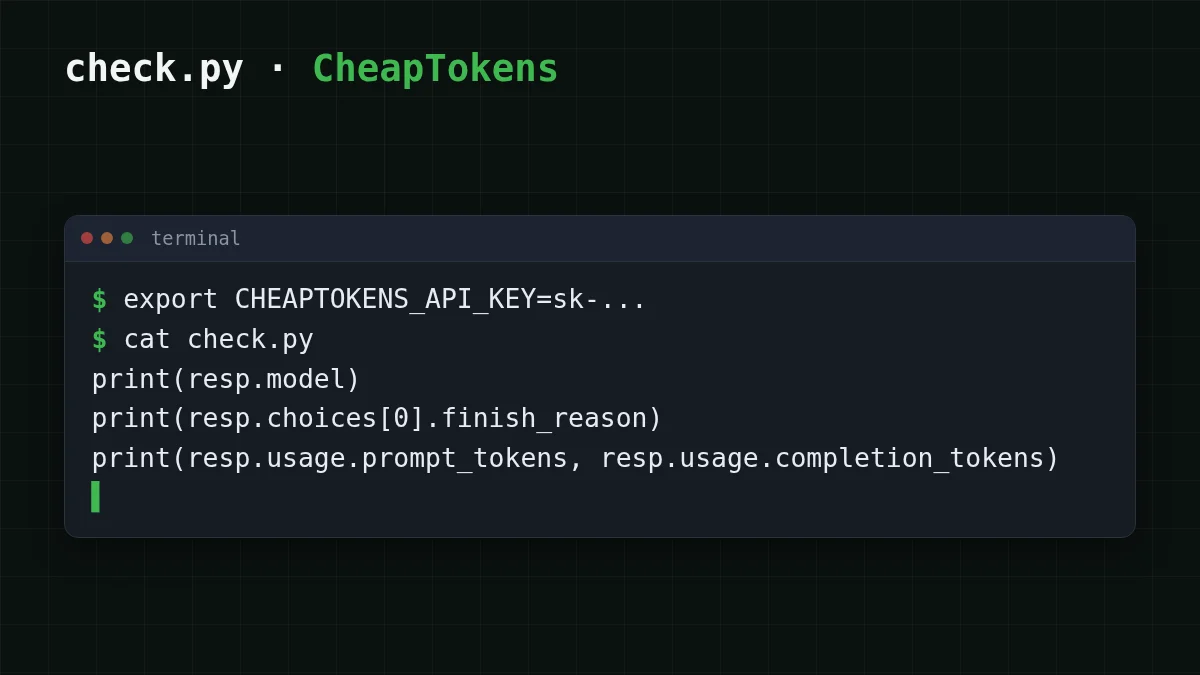
finish_reason de stop significa que el modelo terminó por sí solo. length significa que max_tokens cortó la respuesta. usage muestra los tokens de entrada y de salida por separado, y esos son los dos números de los que se compone tu factura — los mismos dos que estabas siguiendo en OpenRouter.
Pruébalo tú mismoPruébalo: ¿qué dice finish_reason si pones max_tokens a 1?Mostrar respuesta
Dice length — la respuesta fue cortada por max_tokens. Una buena prueba de que tu código maneja una respuesta truncada.
Qué modelo sustituye a qué#
Elige el modelo por la tarea, no por el nombre que usabas en OpenRouter. Los datos de abajo son de la lista de precios de CheapTokens consultada el 27 de octubre de 2026; un solo saldo cubre los tres modelos y el precio no cambia según la hora del día.
Desplaza la tabla hacia la derecha →
| Modelo | id de model |
Contexto | Respuesta máx. |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32.768 tokens |
| GLM-5.3-Flash | zai- |
390K | 8.192 tokens |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8.192 tokens |
¿No sabes cuál es tu fila? Empieza por lo que hace la aplicación:
Elige tu caso
¿Qué hace tu aplicación sobre todo?
Elige una opción para ver la respuesta
Peticiones cortas y frecuentes — clasificación, extracción, respuestas de soporte
Prueba zai-: 390K de contexto, respuestas de hasta 8.192 tokens, y es más barato que OpenRouter en total, contando entrada y salida juntas.
Respuestas largas, código, bucles de agentes
Prueba deepseek-: respuestas de hasta 32.768 tokens, 380K de contexto, un precio a cualquier hora del día.
Una carga de trabajo constante por la que ahora pagas una tarifa alta de OpenRouter
Prueba MiniMaxAI/: 180K de contexto, respuestas de hasta 8.192 tokens, y en total sale más barato que OpenRouter.
Cuánto cuesta el mismo tráfico#
Supón que tu bot envía 1.000 peticiones, cada una con unos 500 tokens de entrada y 300 de salida. Eso es una suposición — sustituye tus propios números de usage. La tabla de abajo es dinámica: nuestros precios y la columna de OpenRouter vienen de la lista de precios actual, contando entrada y salida juntas.
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 1000 solicitudes | OpenRouter, 1000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0434 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000038 | $0.0375 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00007 | $0.07 | $0.51 |
500 tokens de entrada y 300 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
En DeepSeek-V4-Flash esas 1.000 peticiones salen por $0.0375. Los precios completos están en la página de precios; la idea de por qué se te factura está en tokens de entrada vs salida.
Si no funciona#
Tras un cambio, tres errores cubren la mayor parte de los problemas. Relaciona el mensaje con la causa:
Emparejar los pares
Relaciona cada síntoma con su causa
Toca un elemento de la izquierda, luego su par
- 401 UnauthorizedFalta la clave, está mal escrita o sigue siendo la de OpenRouter
- 404 Not FoundLa ruta de la URL base es incorrecta o el id del modelo no es un id completo de CheapTokens
- Respuesta cortada a mitad de frasemax_tokens es menor de lo que necesita la respuesta; finish_reason dice length
El artículo de solución de problemas 401 y 404 repasa cada uno con los mensajes exactos, y qué es base_url explica por qué una barra mal puesta rompe la ruta.
Antes de publicar#
Lista de verificación
Lista de comprobación del cambio


