はじめにガイド
OpenRouter から CheapTokens への切り替え: base_url、キー、モデル id
OpenAI SDK(Python と JavaScript)で base_url、API キー、モデル id を変更し、最初のリクエストを送って動作したか確認します。
あなたのアプリはすでに OpenAI SDK 経由で OpenRouter を呼び出していますが、それを CheapTokens の呼び出しに変えたいとします。変更するのは3つの値 — base_url、API キー、そして model の id — だけで、さらに任意のヘッダーを2つ削除します。残りのコードはそのままです。
以下に Python、JavaScript、curl の正確な行、切り替えが成功したかを素早く確認する方法、そしてどのモデルがどの作業に向くかの表を示します。CheapTokens にリクエストを送ったことがない場合は、最初の API リクエストガイドでアカウントとキーについて説明しており、ドキュメントには完全なリファレンスがあります。
実際に変わるもの#
OpenRouter のクイックスタート(2026年10月27日確認)では、OpenAI クライアントをベース URL https:/ で設定し、モデルを provider/ として指定します。CheapTokens は https:/ で同じ OpenAI Chat Completions 形式を話します。つまり、クライアントクラス、chat.、そして回答の読み取り方は変わりません。
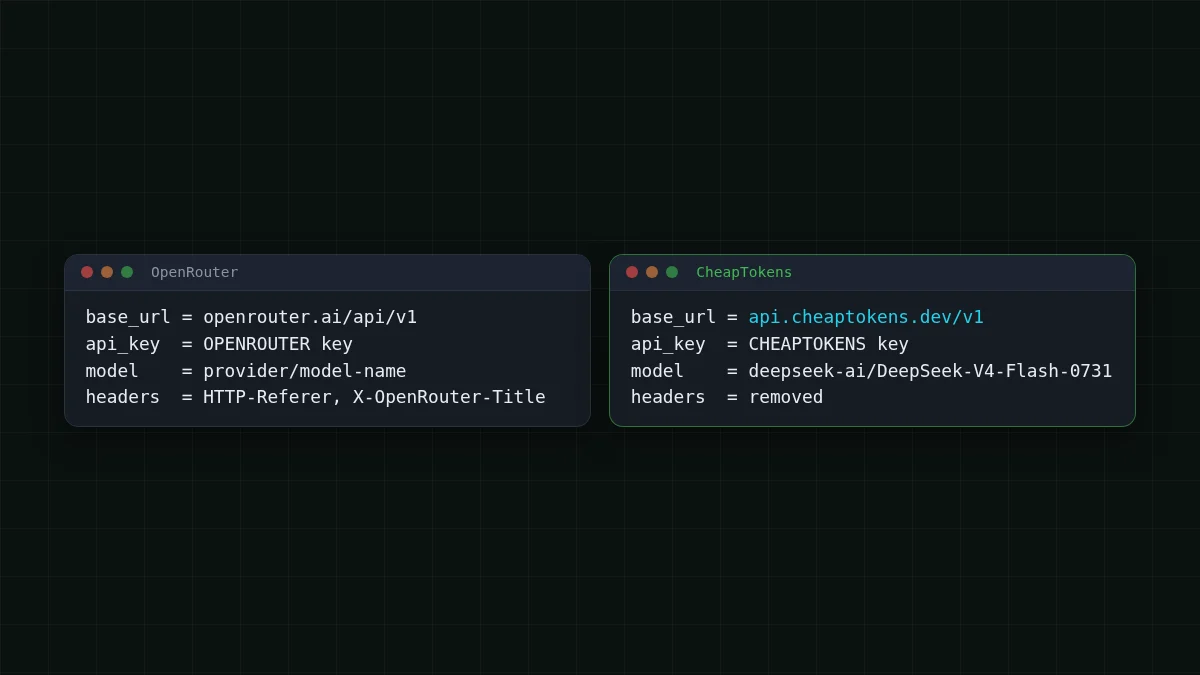
行ごとに1か所の入れ替えです:
- ベース URL — OpenRouter のアドレスの代わりに
https:/。/ api. cheaptokens. dev/ v1 - API キー — CheapTokens アカウントのキーを環境変数から読み取る。
- モデル id — 完全な CheapTokens id、たとえば
deepseek-。id は CheapTokens のドキュメントから取得してください。プロバイダーによって同じモデルの名前が異なり、価格ラベルの短い id は受け付けられません。ai/ DeepSeek- V4- Flash- 0731
そして削除が1つ。OpenRouter の HTTP-Referer と X- ヘッダーは任意で、OpenRouter のリーダーボードに供給するだけです。default_headers / defaultHeaders から削除してください。ここでは必要ありません。
切り替え後のコード#
同じリクエストを3つのランタイムで。アプリが使うものを選んでください。
切り替え後のコード
Python
import os
from openai import OpenAI

client = OpenAI(
    base_url='https://api.cheaptokens.dev/v1',
    api_key=os.environ['CHEAPTOKENS_API_KEY'],
)

resp = client.chat.completions.create(
    model='deepseek-ai/DeepSeek-V4-Flash-0731',
    messages=[{'role': 'user', 'content': 'Reply with one word: ready'}],
    max_tokens=20,
)
print(resp.choices[0].message.content)
JavaScript
import OpenAI from 'openai';

const client = new OpenAI({
  baseURL: 'https://api.cheaptokens.dev/v1',
  apiKey: process.env.CHEAPTOKENS_API_KEY,
});

const resp = await client.chat.completions.create({
  model: 'deepseek-ai/DeepSeek-V4-Flash-0731',
  messages: [{ role: 'user', content: 'Reply with one word: ready' }],
  max_tokens: 20,
});
console.log(resp.choices[0].message.content);
curl
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
-d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Reply with one word: ready"}], "max_tokens": 20}'実行する前にもう1つ。リクエストに OpenRouter 専用のフィールド — ルーティングやフォールバックのリスト、プロバイダー設定、~alias モデル id — が含まれている場合、それらは OpenRouter のものです。リクエストは標準の Chat Completions フィールドに留めてください: model、messages、temperature、max_tokens、stream。
動作したか確認する#
返信だけでは十分な証拠になりません。返信の横に3つのことを出力してください: どのモデルが答えたか、なぜ停止したか、そしてトークンでいくら課金されたか。
print(resp.model)
print(resp.choices[0].finish_reason)
print(resp.usage.prompt_tokens, resp.usage.completion_tokens)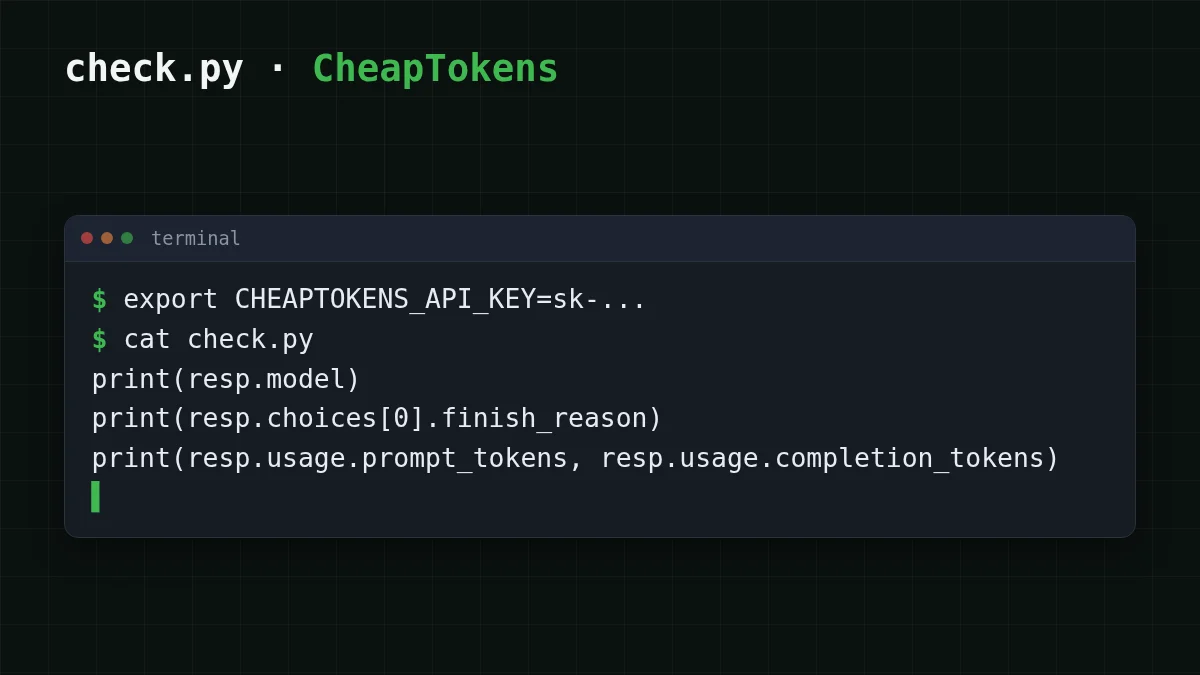
stop の finish_reason はモデルが自力で終了したことを意味します。length は max_tokens が回答を打ち切ったことを意味します。usage は入力トークンと出力トークンを別々に示し、これらが請求の基になる2つの数値です — OpenRouter で追跡していたのと同じ2つです。
自分で試す試してみてください: max_tokens を 1 に設定すると finish_reason は何と言うでしょうか?答えを表示
length と表示されます — 回答は max_tokens によって打ち切られました。切り詰められた返信をコードが処理できるかの良いテストです。
どのモデルが何を置き換えるか#
モデルは OpenRouter で使っていた名前ではなく、作業内容で選んでください。以下の事実は2026年10月27日確認の CheapTokens 価格表によるものです。1つの残高で3つのモデルすべてをカバーし、価格は時間帯によって変わりません。
テーブルを右にスクロールしてください →
| モデル | model id |
コンテキスト | 最大回答 |
|---|---|---|---|
| DeepSeek-V4-Flash | deepseek- |
380K | 32,768 トークン |
| GLM-5.3-Flash | zai- |
390K | 8,192 トークン |
| MiniMax-M2.7 | MiniMaxAI/ |
180K | 8,192 トークン |
どの行が自分に当てはまるかわからない場合は、アプリが何をするかから始めてください:
ケースを選ぶ
あなたのアプリは主に何をしますか?
オプションを選択して答えを表示
短く頻繁なリクエスト — 分類、抽出、サポート返信
zai- を試してください: 390K コンテキスト、最大 8,192 トークンの回答、そして入力と出力を合計すると OpenRouter より安価です。
長い回答、コード、エージェントループ
deepseek- を試してください: 最大 32,768 トークンの回答、380K コンテキスト、1日中のどの時間帯でも同一価格。
現在 OpenRouter の高い料金を払っている安定したワークロード
MiniMaxAI/ を試してください: 180K コンテキスト、最大 8,192 トークンの回答、そして合計で OpenRouter より安くなります。
同じトラフィックのコスト#
ボットが1,000件のリクエストを送り、それぞれ入力約500トークン、出力300トークンだとします。これは仮定です — usage から自分の数値に置き換えてください。以下の表はライブです: 当社の価格と OpenRouter 列は現在の価格表によるもので、入力と出力を合計しています。
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 1,000 リクエスト | OpenRouter、1,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000022 | $0.022 | $0.0434 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.000038 | $0.0375 | $0.0708 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00007 | $0.07 | $0.51 |
リクエストあたり 500 入力トークンと 300 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
DeepSeek-V4-Flash では、その1,000件のリクエストは $0.0375 になります。完全な価格は価格ページにあり、何に対して課金されるかの考え方は入力トークンと出力トークンにあります。
うまくいかない場合#
切り替え後、3つのエラーでほとんどの問題をカバーできます。メッセージを原因と照合してください:
ペアを合わせる
各症状を原因と照合する
左の項目をタップしてから、そのペアをタップ
- 401 Unauthorizedキーが欠落している、打ち間違えている、またはまだ OpenRouter のもの
- 404 Not Foundベース URL のパスが間違っている、またはモデル id が完全な CheapTokens id でない
- 返信が途中で切れるmax_tokens が回答に必要な量より少ない。finish_reason が length と言っている
401 と 404 のトラブルシューティング記事では正確なメッセージとともにそれぞれを説明しており、base_url とは何かではスラッシュ1つの誤りがなぜパスを壊すのかを説明しています。
出荷前に#
チェックリスト
切り替えチェックリスト


