Вирішення проблемПосібник
Локальна LLM не вміщається у VRAM? Подивіться на вагу проти KV-кешу з gputaskman
Дізнайтеся, що заповнює пам'ять вашого GPU, коли модель Ollama або llama.cpp падає чи сповільнюється, яке налаштування змінити і коли API простіший.
На цій сторінці
Ваша локальна модель вчора завантажувалася нормально, а сьогодні падає під час завантаження або ледве повзе, і єдине, що ви змінили, — це довжина контексту. Частий винуватець — KV-кеш, і безкоштовний термінальний інструмент gputaskman може показати вам це замість того, щоб змушувати вас гадати.
Типовий монітор GPU показує, наскільки заповнена VRAM. Це «що», а не «чому». README gputaskman (перевірено 5 листопада 2026 року) називає себе «htop для того, що всередині вашого GPU, а не лише наскільки він заповнений». Це ранній, експериментальний проєкт під ліцензією MIT, тож ставтеся до нього як до зручної лінзи, а не як до вироку.
Що насправді заповнює вашу VRAM#
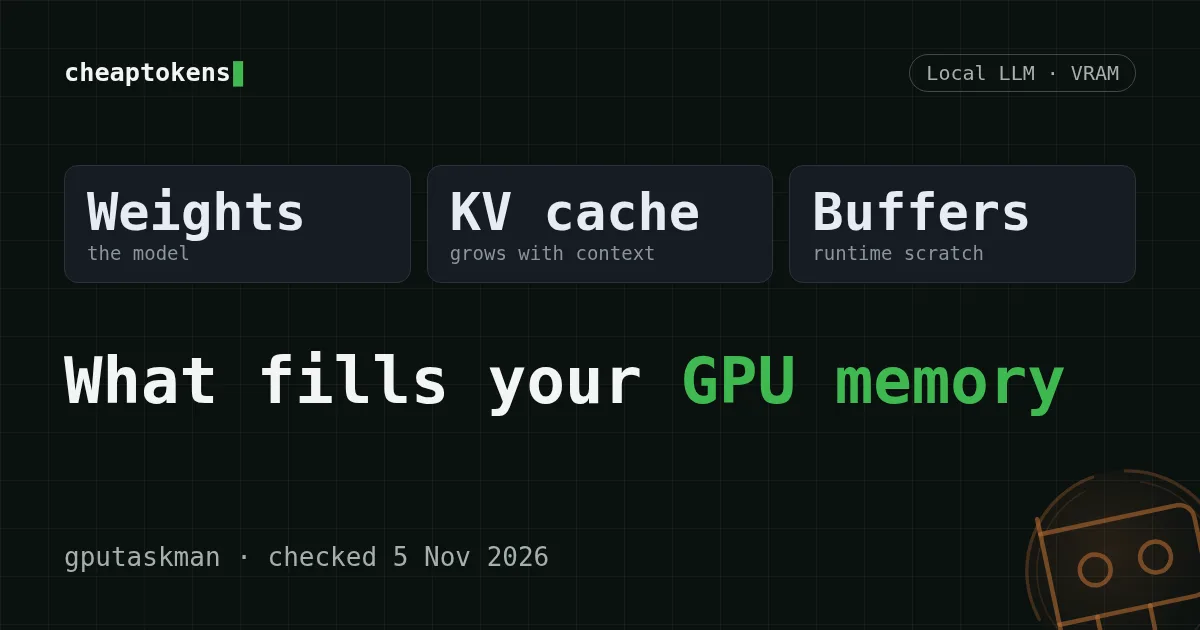
Уявіть VRAM як валізу. У неї кладуть три речі:
- Вага: сама модель. Фіксований розмір для даної моделі та квантизації.
- KV-кеш: короткострокова пам'ять моделі про вашу розмову. Він зростає разом із контекстом.
- Обчислювальні буфери: робочий простір, потрібний середовищу виконання під час роботи.
Коли люди кажуть «модель не вміщається», вони часто мають на увазі, що вага вміщається, а кеш, який ви попросили зверху, — ні. Ця різниця визначає виправлення, і саме її звичайний монітор приховує.
Оберіть свій випадок
Що ви бачите?
Виберіть варіант, щоб побачити відповідь
Падає одразу під час завантаження
Сама вага, або вага плюс кеш для вашої довжини контексту, більші за вільну VRAM. Виберіть меншу квантизацію або меншу модель, або скоротіть контекст.
Завантажується, потім сповільнюється після збільшення контексту
Найімовірніше, KV-кеш виріс, і частина роботи більше не вміщається у VRAM; подання процесів і розподіл це підтвердять. Спершу зменште довжину контексту; це найдешевший важіль.
Раніше працювало, тепер падає
Інший процес забрав VRAM: гра, браузер з апаратним прискоренням, другий сервер моделі. Погляньте на подання процесів, перш ніж чіпати модель.
Встановіть gputaskman і дивіться по процесах#
README перелічує три способи почати: портативний Windows ZIP, клон, запущений через uv run -, або pip у віртуальному середовищі Python 3.11+. Платформи, як їх описує README:
- Windows 10/11 64-біт з GPU NVIDIA або AMD (ZIP-архіви x64 і ARM64 на сторінці Releases);
- Linux і WSL з GPU NVIDIA (glibc 2.35+; WSL може читати лічильники хоста Windows);
- macOS на Apple Silicon лише з клону джерел, без портативної збірки.
Windows ZIP-архіви не підписані. Завантажуйте їх лише зі сторінки Releases офіційного репозиторію, github.com/shanselman/gputaskman. Копіюйте точні команди з README: проєкт молодий, і параметри можуть змінюватися.
Коли він запущений, для цієї проблеми важливі два подання:
- Подання пристрою: використання VRAM, активність GPU, PCIe, температура, живлення, частоти та графіки історії. Добре для питання «чи щось стрибнуло?»
- Подання процесів: локальна пам'ять GPU на процес, системна RAM, доступна для GPU, активність рушія та виявлене середовище виконання (CUDA, HIP, Vulkan, Direct3D, ggml, ONNX Runtime).
У поданні процесів знайдіть свій сервер моделі (для Ollama — його вбудований runner). Потім перегляньте решту списку. Якщо браузер або гра тримає кілька гігабайтів, ви знайшли відповідь, не чіпаючи модель.
Вага, KV-кеш, буфери: звідки беруться числа#
Інспектор моделі показує архітектуру, квантизацію та розміри буферів, де вони доступні. Важливе застереження: згідно з README, вага, KV-кеш і обчислювальні буфери беруться з логів завантаження середовища виконання, коли ввімкнено сумісне логування. Для llama.cpp запустіть власний llama-server з логуванням (-; README каже, що для розмірів буферів потрібен рівень 4). Для Ollama gputaskman використовує server.log від Ollama, якщо він доступний. Інакше це оцінки з метаданих GGUF і розміру контексту, з припущенням розміщення в стилі llama.cpp. Облік KV-кешу для кожної моделі в межах одного процесу ще не підтримується.

Тож читайте оцінений розподіл як «приблизно», а розподіл на основі логів — як «те, що повідомило середовище виконання». Для Ollama README каже, що вбудовані runner'и виявляються, GGUF-блоби називаються з маніфестів Ollama, а server.log використовується, коли доступний. Підтримка LM Studio часткова: моделі називаються з її папки та перевіряються через її локальний API, але це тестувалося на фікстурах відповідей, а не наскрізно.
Ви також можете зберегти два знімки як JSON і порівняти їх командою diff. Це чистий спосіб відповісти на питання «що змінилося, коли я перейшов з контексту 4K на 16K?»: зробіть один знімок, змініть налаштування, перезавантажте, зробіть інший.
Швидка перевірка
Ваша модель завантажується, але сповільнюється після збільшення довжини контексту. Що слід перевірити першим?
Показати відповідь
Відповідь: KV-кеш
Вага не змінюється з довжиною контексту; KV-кеш змінюється. Зменшення довжини контексту одразу його скорочує.
Який важіль крутити#
Читання розподілу дає вам рішення, а не просто картинку.
Вага — це великий шматок. Переходьте на меншу квантизацію або меншу модель. Це єдиний важіль, який зменшує вагу. Якщо вам потрібна математика пам'яті за цим, дивіться Чи може модель 125B працювати на GPU з 16 ГБ?
KV-кеш — це великий шматок. Скоротіть контекст. В Ollama ви можете спробувати це прямо в сесії:
ollama run <your-model>
>>> /set parameter num_ctx 8192
8192 — це лише приклад значення; виберіть те, що справді потрібне вашому завданню (команда за документацією Ollama, перевірено 5 листопада 2026 року).
Якщо згодом ви побачите дивне сповільнення обробки запиту з квантизованим кешем у llama.cpp, це виправлення для KV-кешу q5_1 — наступна зупинка. Про те, що взагалі вміщає вікно контексту, читайте Що таке вікно контексту?
Інший процес — це великий шматок. Закрийте його або запустіть на інтегрованому GPU. Нічого в моделі змінювати не потрібно.
Чек-лист
Перш ніж звинувачувати модель
Якщо не працює#
- Розподіл виглядає неправильно. Перевірте, чи це оцінка (немає сумісних логів завантаження). З llama.cpp запустіть свій llama-server з
-і перезавантажте модель. З Ollama gputaskman використовує- log- file server. log - lv 4 server.log, якщо він існує; позначка оцінки там нормальна. - LM Studio показує менше деталей. Підтримка часткова, як зазначено вище.
- Немає GPU NVIDIA або AMD. Інструмент охоплює лише локальні навантаження GPU; навантаження лише на CPU, лише на NPU та хмарні — поза межами.
- macOS. Запускайте з клону джерел; портативної збірки немає.
Коли розміщена модель — простіше виправлення#
Скажімо, вам потрібен довгий контекст для одного завдання, наприклад підсумовування великого документа, а ваш GPU вміщає модель лише з коротким. Ви можете продовжувати налаштовувати або прибрати VRAM з рівняння. Для таких завдань CheapTokens пропонує DeepSeek-V4-Flash: контекст 380K, до 32 768 вихідних токенів на відповідь, одна ціна в будь-який час доби, через OpenAI-сумісний API. GLM-5.3-Flash має контекст 390K і до 8 192 вихідних токенів.
Виклик — у звичайному форматі OpenAI (помістіть свій ключ у змінну середовища):
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{"model": "deepseek-ai/DeepSeek-V4-Flash-0731", "messages": [{"role": "user", "content": "Summarize this document: ..."}]}'
Деталі налаштування — у документації. Емпіричне правило для рішення: якщо завдання постійно потребує більшого контексту або більшої моделі, ніж вміщає ваша карта, а подання процесів показує, що ваша VRAM уже добре використана, надішліть це завдання в API, а невеликі швидкі задачі залиште локальними. Запускати DeepSeek локально чи використовувати API? розглядає компроміс глибше.
Скажімо, ви підсумовуєте 100 великих документів, кожен по 60 000 вхідних токенів і 1 000 вихідних токенів (цілком у межах вікна 380K). Ось скільки це коштує сьогодні:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 100 запитів | OpenRouter, 100 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.0012 | $0.124 | $0.209 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.001 | $0.10 | $0.434 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.0032 | $0.315 | $3.78 |
60 000 вхідних і 1 000 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
За цими числами, $0.001 за документ — це актуальна ціна за один такий виклик, а загалом, з урахуванням вхідних і вихідних разом, це виходить нижче за OpenRouter.
Калькулятор вартості
Ваш власний пакет: змініть токени та запити
Вхідні токени на запит: 60 000 · Вихідні токени на запит: 1 000 · Запитів на день: 100
| Модель | За день | За місяць |
|---|---|---|
| GLM-5.3-Flash$0.02$0.04 | $0.124 | $3.72 |
| DeepSeek-V4-Flash$0.015$0.10 | $0.10 | $3.00 |
| MiniMax-M2.7$0.05$0.15 | $0.315 | $9.45 |


