AI для початківцівПосібник
Чи може модель 125B працювати на GPU на 16 ГБ? Математика пам’яті
Скільки пам’яті потребує відкрита модель 125B: ваги, квантування та KV-кеш у кількох рядках математики, і коли API є простішим способом її використання.
На цій сторінці
Коротка відповідь: ні. Модель із 125 млрд параметрів потребує близько 62,5 ГБ для своїх ваг навіть після 4-бітного стиснення, а відеокарта на 16 ГБ вміщує приблизно чверть цього. Ви все ще можете запустити її, вивантаживши решту в системну RAM або на диск, але тоді вже не карта визначатиме, як усе піде.
Далі: як отримати це число самостійно кількома рядками, що насправді означає «122B-A10B» у назві моделі, і коли надсилання запитів до API є простішим способом використання великої моделі.
Ваги: параметри помножити на байти#
Уявіть модель як величезну купу чисел, які називаються вагами або параметрами. Щоб відповісти вам, комп’ютеру потрібні всі вони одночасно у швидкій пам’яті. Тож перша оцінка — це просте множення: параметри в мільярдах × байти на вагу = гігабайти. Вага займає 2 байти при 16-бітному поданні, 1 байт при 8-бітному і 0,5 байта при 4-бітному. Ось і все, що робить квантування: менше бітів на число.
Візьмімо модель цього класу, Qwen3.5-122B-A10B. Її сторінка на Hugging Face (перевірено 30 жовтня 2026 року) вказує Apache-2.0 як ліцензію, публікує ваги у BF16 та F32 і зазначає розмір як 125B параметрів. Для 125B:
- При 16 бітах: 125 × 2 = 250 ГБ
- При 8 бітах: 125 × 1 = 125 ГБ
- При 4 бітах: 125 × 0,5 = 62,5 ГБ
- При 2 бітах: 125 × 0,25 = 31,25 ГБ
Навіть рядок для 2 бітів майже вдвічі перевищує карту. І це нижні межі, а не загальні суми: вони не враховують кеш контексту (наступні розділи) та власні накладні витрати середовища виконання, а реальні квантовані формати додають трохи зверху.
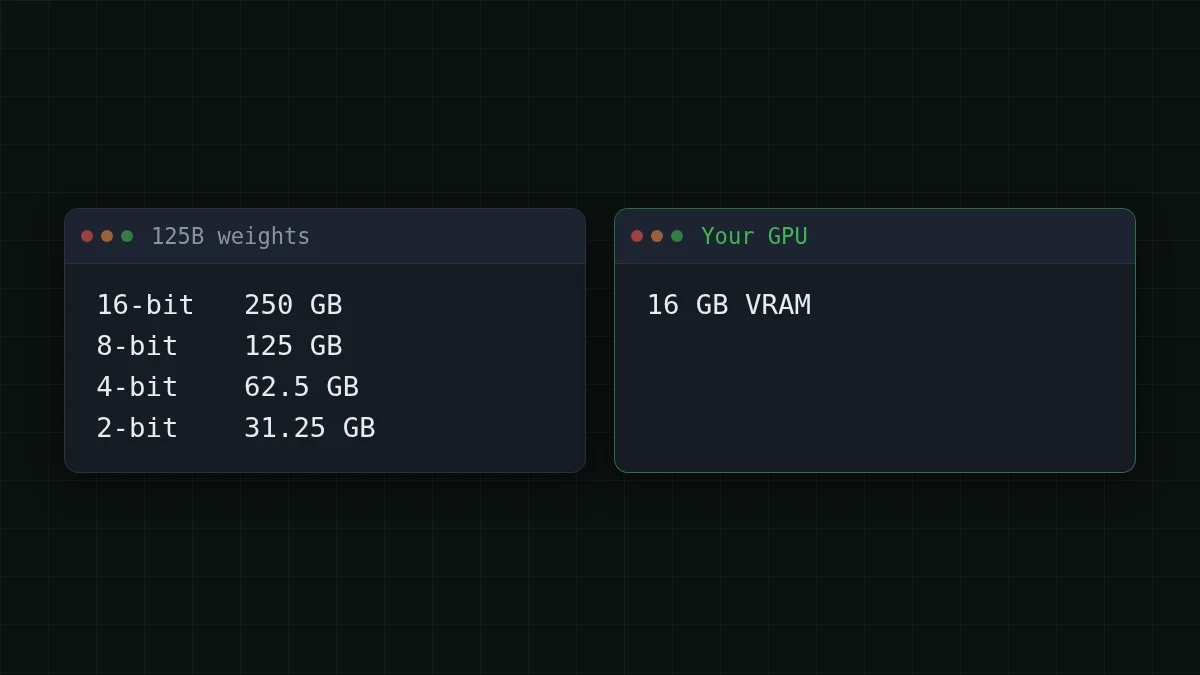
Переверніть формулу, щоб побачити, що вміщує карта на 16 ГБ. При 4 бітах це 16 / 0,5 = 32 мільярди параметрів, і це стеля, перш ніж ще щось потребуватиме місця. Спробуйте порахувати самі:
Вгадайте число
Скільки ГБ займають ваги моделі 32B при 4 бітах?
Ваше припущення
0100
Показати відповідь
Відповідь: 16
32 × 0,5 = 16 ГБ. Карта заповнена ще до того, як модель прочитає хоч одне слово вашого запитання, тож 32B — це межа для карти на 16 ГБ, а комфортні розміри розташовані нижче.
«122B-A10B»: яке число має значення#
Назва містить два числа. Згідно з карткою моделі, модель має 122B параметрів загалом і 10B активних для кожного токена. Це модель із сумішшю експертів: всередині багато невеликих спеціалізованих підмереж, і для кожного токена маршрутизатор активує лише кілька з них.
Уявіть бібліотеку з 122 полицями, де будь-яке запитання відправляє вас до 10 з них. Ваші зусилля на читання малі, але вся бібліотека все одно має бути в будівлі, бо ви не можете знати, які полиці знадобляться для наступного слова.
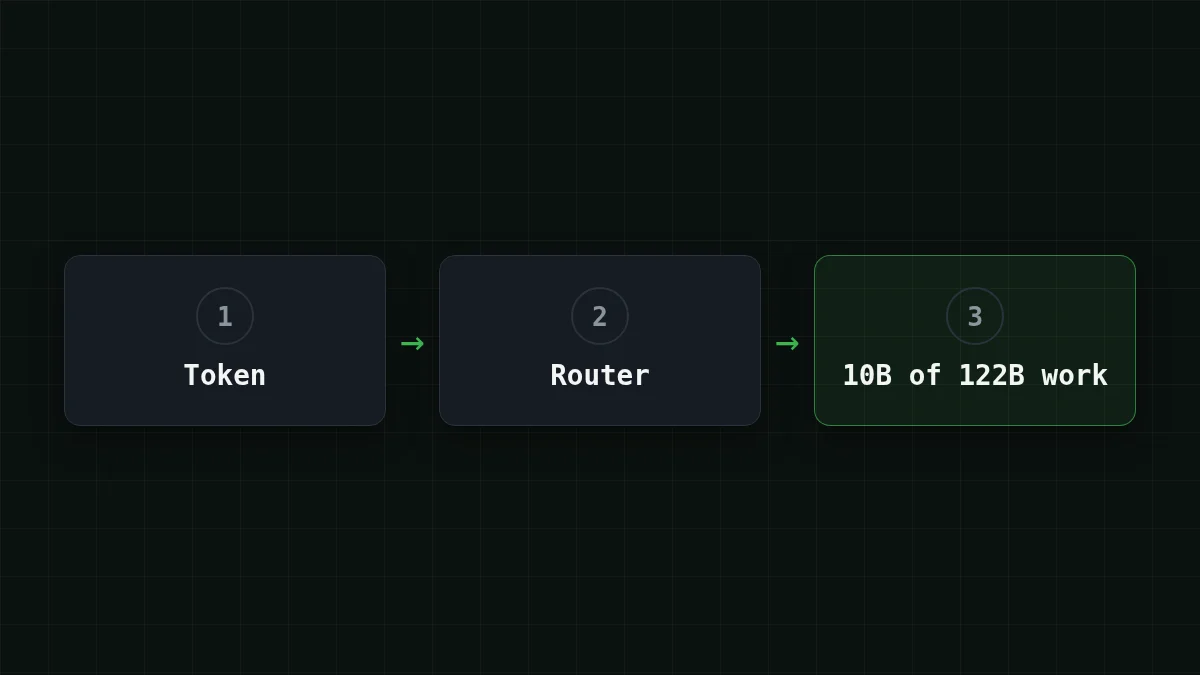
Отже: пам’ять залежить від загальної кількості, обчислення — від активної. Десять мільярдів активних параметрів роблять токен дешевим для обчислення, але не дешевим для зберігання. Наскільки швидко працюватиме конфігурація, яка тримає частину експертів у RAM або на диску, залежить від вашої RAM, диска та програмного забезпечення. Чесної єдиної цифри не існує, тож остерігайтеся будь-якого заголовка, який її наводить.
Швидка перевірка
Модель називається 122B-A10B. Яке число приблизно визначає, скільки пам’яті потребують її ваги?
Показати відповідь
Відповідь: 122B загальних параметрів
Усі експерти мають зберігатися, бо маршрутизатор може обрати будь-якого з них для наступного токена. 10B лише вказує, скільки роботи потребує один токен.
Другий рахунок: кеш контексту#
Ваги — це фіксована частина. Інша частина зростає під час спілкування. Щоб уникнути повторного читання всієї розмови для кожного нового токена, модель зберігає нотатки про кожен токен, який вона вже бачила: KV-кеш (ключі та значення). Довший контекст — більший кеш. Якщо ви хочете, щоб контекстну частину пояснили з нуля, є окремий посібник із контекстного вікна.
На кожен токен кеш займає: 2 × шари × KV-голови × розмір голови × байти. Скажімо, модель має 48 шарів, 8 KV-головів, розмір голови 128 і 16-бітний кеш (припущена форма, не з жодної картки моделі):
- один токен: 2 × 48 × 8 × 128 × 2 = 196608 байтів, близько 0,2 МБ
- 32 768 токенів: 196608 × 32768 = 6442450944 байтів, близько 6,4 ГБ
- 131 072 токени (128K): 196608 × 131072 = 25769803776 байтів, близько 25,8 ГБ
При 128K лише цей кеш більший за всю карту. Ваші реальні числа є в config.json моделі (шари, KV-голови, розмір голови), а деякі архітектури зберігають кеш набагато меншим, тож сприймайте це як метод, а не як вирок для однієї моделі.
Картка Qwen3.5-122B-A10B показує, як виглядає великий кінець: її приклади обслуговування використовують тензорний паралелізм на 8 GPU при повному контексті 262 144 токени. Якщо пам’ять закінчується, вона радить скоротити контекст, зберігаючи щонайменше 128K, щоб зберегти мислення, а прапорець vLLM - пропускає візуальний енкодер, щоб звільнити пам’ять для кешу.
Ваша власна оцінка в десяток рядків#
Складіть обидві частини:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9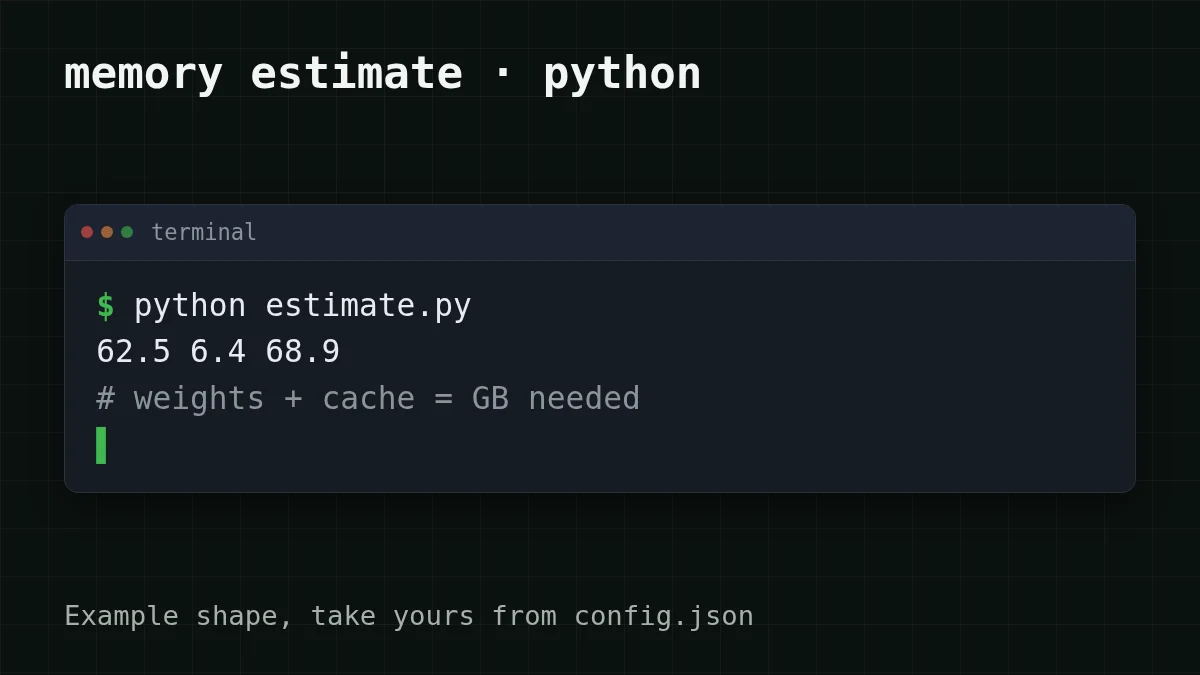
Тепер перевірка реальності. Скажімо, ваш ПК має 32 ГБ RAM поряд із картою на 16 ГБ: 16 + 32 = 48 ГБ, що все ще нижче за 68,9 ГБ, які вивів скрипт. Вивантаженню доведеться звертатися й до диска, і ви запускатимете велику модель переважно зі сховища, а не з карти.
Коли API — простіший вибір#
Не кожне завдання потребує великої моделі на вашому столі. Що описує вас?
Оберіть свій випадок
Що найближче до вашого випадку?
Виберіть варіант, щоб побачити відповідь
Я хочу побачити, як модель працює на моїй машині
Виберіть малу: при 4 бітах модель 7B займає близько 7 × 0,5 = 3,5 ГБ для ваг, тож вона вміщується на карту на 16 ГБ із запасом для довгої розмови. Вивчення того, як поводяться моделі, — найкраща причина запускати локально. Дивіться також локально чи API для DeepSeek.
Кілька тисяч запитів на місяць, і я хочу сильну модель
Надсилайте їх до API. Ви пропускаєте купівлю чи оренду пам’яті, нічого не потрібно встановлювати, і рахунок — лише за токени, які ви фактично використовуєте.
Довгі документи або агент, що зберігає довгу історію
Кеш — це частина, що зростає, і на вашому власному обладнанні він конкурує з вагами за ту саму пам’ять. З API контекстне вікно — це чужий клопіт: DeepSeek-V4-Flash і GLM-5.3-Flash на CheapTokens приймають 380K і 390K токенів.
Як це виглядає на практиці. Скажімо, бот підтримки підсумовує 3000 тікетів на місяць, кожен близько 2000 токенів на вході та 400 токенів на виході. За місяць це 2000 × 3000 = 6000000 вхідних токенів і 400 × 3000 = 1200000 вихідних токенів. На DeepSeek-V4-Flash вхід коштує $0.015, а вихід $0.10 за 1M токенів, тож весь місяць виходить $0.21. Таблиця нижче показує те саме навантаження на кожній моделі, з колонкою OpenRouter поруч, щоб ви могли порівняти загалом, вхід і вихід разом:
| Модель | Вхід $/1М | Вихід $/1М | За запит | 3 000 запитів | OpenRouter, 3 000 запитів |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2 000 вхідних і 400 вихідних токенів на запит. Ціни за 1 млн токенів актуальні та змінюються разом із нашими тарифами; стовпець OpenRouter показує довідкові ціни для того самого навантаження.
Сам запит — це той самий виклик у стилі OpenAI, який ви зробили б будь-якому постачальнику. Базова URL-адреса — https:/, а ідентифікатор моделі — повний deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
Відповідь містить блок usage із кількістю вхідних і вихідних токенів, тож ви можете перевірити наведену вище оцінку на своїх тікетах після першого десятка. DeepSeek-V4-Flash дає до 32 768 вихідних токенів на відповідь за однією ціною цілодобово, а GLM-5.3-Flash — легший повсякденний варіант із до 8192. Деталі налаштування — у документації, сторінка моделі — дешевий DeepSeek, а повний прайс-лист — на сторінці цін.
Наступного разу, коли назва моделі супроводжується розміром, у вас є три кроки: помножити, додати кеш, порівняти з картою.


