AI dla początkującychPrzewodnik
Czy model 125B uruchomi się na GPU 16 GB? Matematyka pamięci
Ile pamięci potrzebuje otwarty model 125B: wagi, kwantyzacja i pamięć podręczna KV w kilku linijkach matematyki oraz kiedy API jest prostszym sposobem korzystania z niego.
Na tej stronie
Krótka odpowiedź: nie. Model z 125 mld parametrów potrzebuje około 62,5 GB na same wagi, nawet po kompresji do 4 bitów, a karta graficzna z 16 GB pomieści około jednej czwartej tego. Nadal możesz go uruchomić, przenosząc resztę do pamięci systemowej lub na dysk, ale wtedy to już nie karta decyduje o tym, jak wszystko pójdzie.
Poniżej: jak samodzielnie obliczyć tę liczbę w kilku linijkach, co naprawdę mówi ci „122B-A10B” w nazwie modelu i kiedy wysyłanie żądań do API jest prostszym sposobem korzystania z dużego modelu.
Wagi: parametry razy bajty#
Wyobraź sobie model jako ogromny stos liczb, zwanych wagami lub parametrami. Aby ci odpowiedzieć, komputer potrzebuje ich wszystkich naraz w szybkiej pamięci. Zatem pierwsze oszacowanie to zwykłe mnożenie: parametry w miliardach × bajty na wagę = gigabajty. Waga zajmuje 2 bajty przy 16 bitach, 1 bajt przy 8 bitach i 0,5 bajta przy 4 bitach. To wszystko, co robi kwantyzacja: mniej bitów na liczbę.
Weźmy model z tej klasy, Qwen3.5-122B-A10B. Jego strona na Hugging Face (sprawdzona 30 października 2026) podaje Apache-2.0 jako licencję, publikuje wagi w BF16 i F32 oraz podaje rozmiar jako 125 mld parametrów. Dla 125 mld:
- Przy 16 bitach: 125 × 2 = 250 GB
- Przy 8 bitach: 125 × 1 = 125 GB
- Przy 4 bitach: 125 × 0,5 = 62,5 GB
- Przy 2 bitach: 125 × 0,25 = 31,25 GB
Nawet wiersz z 2 bitami to prawie dwa razy więcej niż karta. A to są dolne granice, nie sumy: pomijają pamięć podręczną kontekstu (kolejne sekcje) i własny narzut środowiska uruchomieniowego, a rzeczywiste formaty skwantyzowane dodają jeszcze trochę.
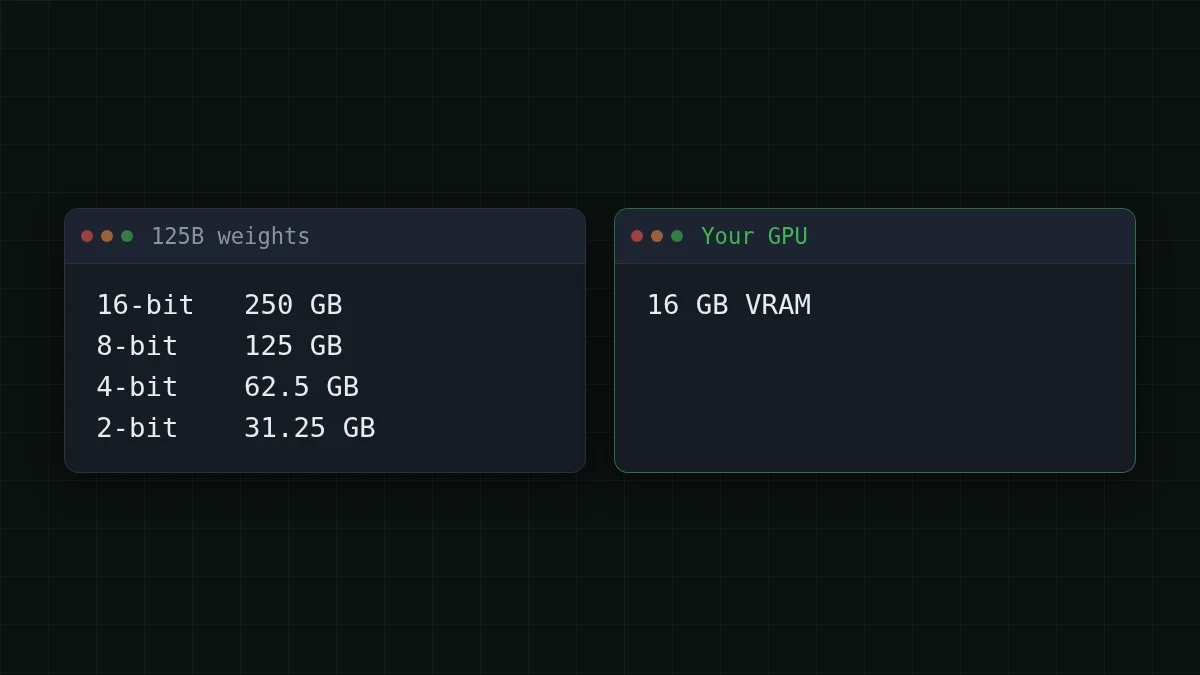
Odwróć wzór, aby zobaczyć, ile pomieści karta 16 GB. Przy 4 bitach to 16 / 0,5 = 32 mld parametrów i to jest górna granica, zanim cokolwiek innego potrzebuje miejsca. Spróbuj policzyć sam:
Zgadnij liczbę
Ile GB zajmują wagi modelu 32B przy 4 bitach?
Twoje przypuszczenie
0100
Pokaż odpowiedź
Odpowiedź: 16
32 × 0,5 = 16 GB. Karta jest pełna, zanim model przeczyta choć jedno słowo twojego pytania, więc 32B to sufit dla karty 16 GB, a komfortowe rozmiary są niższe.
„122B-A10B”: która liczba się liczy#
Nazwa zawiera dwie liczby. Według karty modelu model ma łącznie 122 mld parametrów i 10 mld aktywnych dla każdego tokenu. To model mieszanki ekspertów: w środku znajduje się wiele małych wyspecjalizowanych podsieci, a dla każdego tokenu router budzi tylko kilka z nich.
Wyobraź sobie bibliotekę z 122 półkami, gdzie każde pojedyncze pytanie wysyła cię do 10 z nich. Twój wysiłek czytania jest niewielki, ale cała biblioteka nadal musi znajdować się w budynku, bo nie możesz wiedzieć, których półek będzie potrzebowało następne słowo.
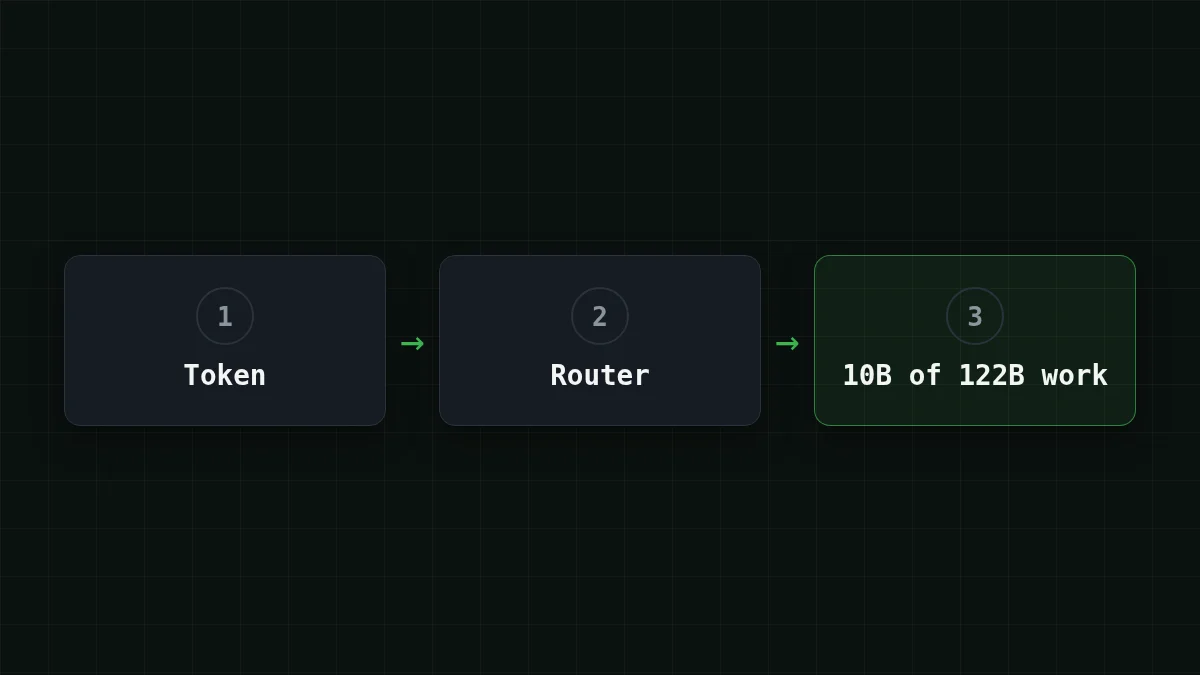
Zatem: pamięć idzie za całością, obliczenia za aktywnymi. Dziesięć miliardów aktywnych parametrów sprawia, że token jest tani w obliczeniu, a nie tani w przechowywaniu. Jak szybko działa konfiguracja, która trzyma część ekspertów w RAM lub na dysku, zależy od twojej pamięci RAM, dysku i oprogramowania. Nie ma uczciwej jednej liczby, więc uważaj na nagłówki, które ją podają.
Szybkie sprawdzenie
Model nazywa się 122B-A10B. Która liczba w przybliżeniu określa, ile pamięci potrzebują jego wagi?
Pokaż odpowiedź
Odpowiedź: 122 mld całkowitych parametrów
Wszyscy eksperci muszą być przechowywani, ponieważ router może wybrać dowolnego z nich dla następnego tokenu. 10B mówi ci tylko, ile pracy zajmuje jeden token.
Drugi rachunek: pamięć podręczna kontekstu#
Wagi to część stała. Druga część rośnie podczas rozmowy. Aby uniknąć ponownego czytania całej rozmowy dla każdego nowego tokenu, model przechowuje notatki o każdym tokenie, który już widział: pamięć podręczną KV (klucze i wartości). Dłuższy kontekst, większa pamięć podręczna. Jeśli chcesz poznać stronę kontekstu od podstaw, jest osobny przewodnik po oknie kontekstu.
Na token pamięć podręczna zajmuje: 2 × warstwy × głowy KV × rozmiar głowy × bajty. Załóżmy, że model ma 48 warstw, 8 głów KV, rozmiar głowy 128 i pamięć podręczną 16-bitową (założony kształt, nie z żadnej karty modelu):
- jeden token: 2 × 48 × 8 × 128 × 2 = 196608 bajtów, około 0,2 MB
- 32 768 tokenów: 196608 × 32768 = 6442450944 bajtów, około 6,4 GB
- 131 072 tokenów (128K): 196608 × 131072 = 25769803776 bajtów, około 25,8 GB
Przy 128K sama ta pamięć podręczna jest większa niż cała karta. Twoje rzeczywiste liczby są w config.json modelu (warstwy, głowy KV, rozmiar głowy), a niektóre architektury utrzymują pamięć podręczną znacznie mniejszą, więc traktuj to jako metodę, a nie wyrok na jeden model.
Karta Qwen3.5-122B-A10B pokazuje, jak wygląda duży koniec: jej przykłady serwowania używają równoległości tensorowej na 8 GPU przy pełnym kontekście 262 144 tokenów. Jeśli zabraknie pamięci, zaleca skrócenie kontekstu przy zachowaniu co najmniej 128K, aby zachować myślenie, a flaga vLLM - pomija enkoder wizji, aby zwolnić pamięć dla pamięci podręcznej.
Twoje własne oszacowanie w kilkunastu linijkach#
Połącz obie części:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9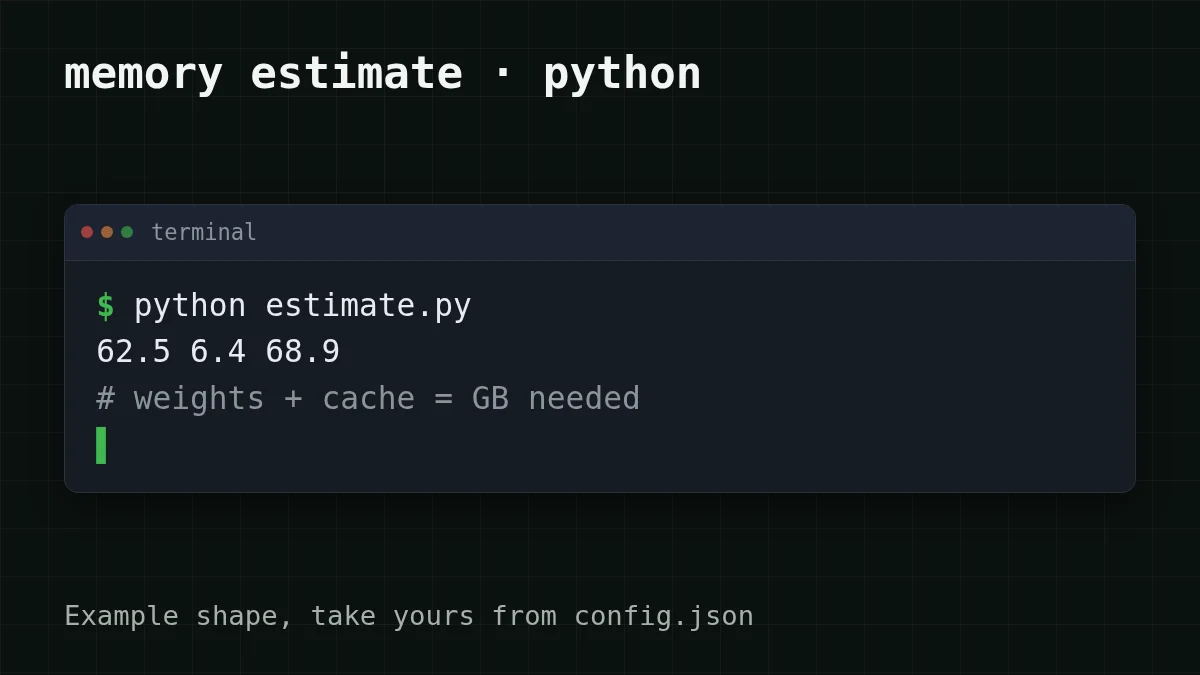
Teraz sprawdzenie rzeczywistości. Załóżmy, że twój PC ma 32 GB RAM obok karty 16 GB: 16 + 32 = 48 GB, wciąż poniżej 68,9 GB wypisanych przez skrypt. Offloading musiałby sięgnąć także do dysku, a ty uruchamiałbyś duży model głównie z pamięci masowej, a nie z karty.
Kiedy API jest prostszym wyborem#
Nie każde zadanie wymaga dużego modelu na twoim biurku. Który opis pasuje do ciebie?
Wybierz swój przypadek
Który jest najbliższy twojemu przypadkowi?
Wybierz opcję, aby zobaczyć odpowiedź
Chcę zobaczyć model działający na własnej maszynie
Wybierz mały: przy 4 bitach model 7B zajmuje około 7 × 0,5 = 3,5 GB na wagi, więc mieści się na karcie 16 GB z miejscem na długą rozmowę. Nauka, jak zachowują się modele, to najlepszy powód do uruchamiania lokalnie. Zobacz też lokalnie czy API dla DeepSeek.
Kilka tysięcy żądań miesięcznie i chcę mocny model
Wyślij je do API. Unikasz kupowania lub wynajmowania pamięci, nie ma nic do zainstalowania, a rachunek obejmuje tylko tokeny, których faktycznie używasz.
Długie dokumenty lub agent z długą historią
Pamięć podręczna to część, która rośnie, a na własnym sprzęcie konkuruje z wagami o tę samą pamięć. W przypadku API okno kontekstu to problem kogoś innego: DeepSeek-V4-Flash i GLM-5.3-Flash w CheapTokens przyjmują 380K i 390K tokenów.
Jak to wygląda w praktyce. Załóżmy, że bot wsparcia podsumowuje 3000 zgłoszeń miesięcznie, każde około 2000 tokenów na wejściu i 400 tokenów na wyjściu. Przez miesiąc to 2000 × 3000 = 6000000 tokenów wejściowych i 400 × 3000 = 1200000 tokenów wyjściowych. W DeepSeek-V4-Flash wejście kosztuje $0.015, a wyjście $0.10 za 1M tokenów, więc cały miesiąc wynosi $0.21. Poniższa tabela pokazuje to samo obciążenie na każdym modelu, z kolumną OpenRouter obok, aby porównać łącznie, wejście i wyjście razem:
| Model | Wejście $/1M | Wyjście $/1M | Za żądanie | 3000 żądań | OpenRouter, 3000 żądań |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2000 tokenów wejściowych i 400 tokenów wyjściowych na żądanie. Ceny za 1 mln tokenów są aktualne i zmieniają się wraz z naszymi taryfami; kolumna OpenRouter pokazuje ceny referencyjne dla tego samego obciążenia.
Samo żądanie to to samo wywołanie w stylu OpenAI, które wykonałbyś u dowolnego dostawcy. Bazowy URL to https:/, a identyfikator modelu to pełny deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
Odpowiedź zawiera blok usage z liczbami tokenów wejściowych i wyjściowych, więc możesz sprawdzić powyższe oszacowanie na własnych zgłoszeniach po pierwszym tuzinie. DeepSeek-V4-Flash daje do 32 768 tokenów wyjściowych na odpowiedź w jednej cenie przez całą dobę, a GLM-5.3-Flash to lżejsza opcja na co dzień z limitem do 8192. Szczegóły konfiguracji są w dokumentacji, strona modelu to tani DeepSeek, a pełna lista cen jest na stronie cen.
Następnym razem, gdy nazwa modelu będzie zawierać rozmiar, masz już trzy kroki: pomnóż, dodaj pamięć podręczną, porównaj z kartą.


