AI 入门指南
125B 模型能在 16 GB GPU 上运行吗?内存计算
一个 125B 开源模型需要多少内存:用几行数学计算权重、量化和 KV 缓存,以及何时 API 是使用它的更简单方式。
简短回答:不能。一个 125B 参数的模型即使经过 4 位压缩,其权重也需要约 62.5 GB,而 16 GB 显卡只能容纳其中约四分之一。你仍然可以通过把其余部分推入系统内存或磁盘来启动它,但那时显卡已不再是决定运行效果的因素。
下面将介绍:如何用几行代码自己算出这个数字,模型名称中的“122B-A10B”究竟告诉你什么,以及何时向 API 发送请求是使用大模型的更简单方式。
权重:参数量乘以字节数#
把模型想象成一大堆数字,称为权重或参数。为了回答你,计算机需要同时将所有数字放入快速内存中。因此,第一个估算就是简单的乘法:参数量(十亿)× 每个权重的字节数 = 千兆字节。一个权重在 16 位下占 2 字节,8 位下占 1 字节,4 位下占 0.5 字节。这就是量化所做的全部:减少每个数字的位数。
以这一级别的模型 Qwen3.5-122B-A10B 为例。其 Hugging Face 页面(2026 年 10 月 30 日检查)标明许可证为 Apache-2.0,以 BF16 和 F32 格式发布权重,并列出规模为 125B 参数。对于 125B:
- 16 位:125 × 2 = 250 GB
- 8 位:125 × 1 = 125 GB
- 4 位:125 × 0.5 = 62.5 GB
- 2 位:125 × 0.25 = 31.25 GB
即使是 2 位那一行也几乎是显卡容量的两倍。而且这些是下限,不是总量:它们没有包括上下文缓存(后续章节)和运行时自身的开销,而真实的量化格式还会在此基础上增加一点。
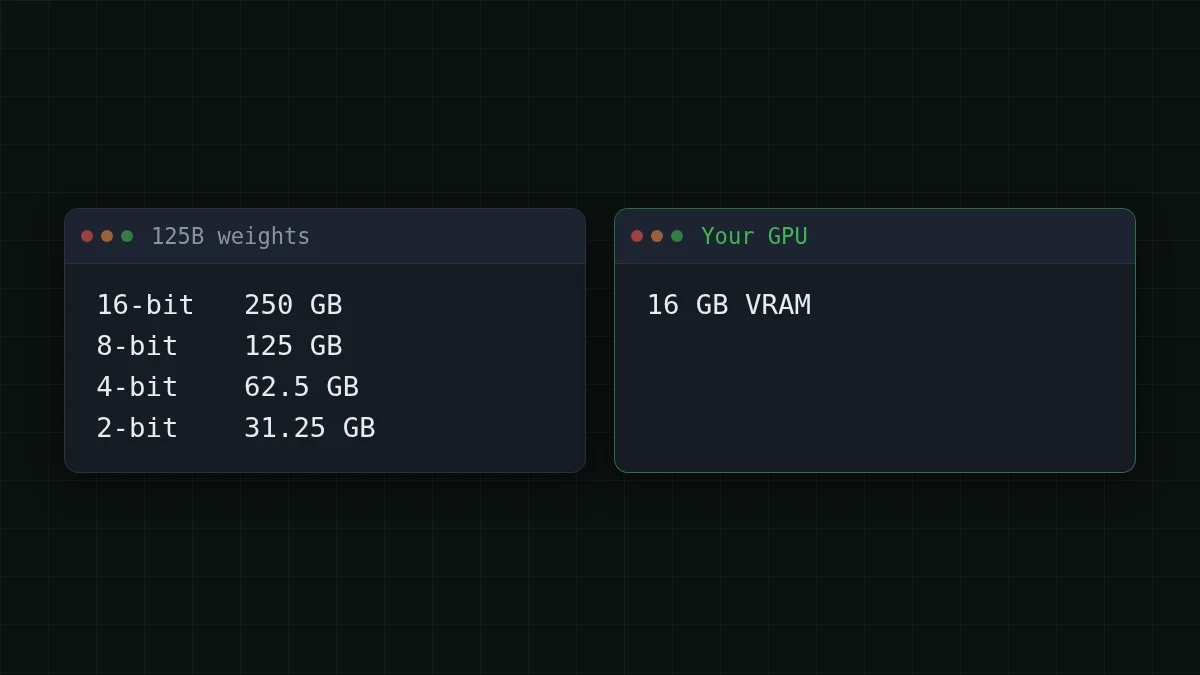
反过来看公式,看看 16 GB 显卡能容纳多少。在 4 位下,即 16 / 0.5 = 320 亿参数,这是在其他任何东西需要空间之前的上限。自己算一下:
猜数字
一个 32B 模型的权重在 4 位下占多少 GB?
你的猜测
0100
显示答案
答案: 16
32 × 0.5 = 16 GB。在模型读取你问题的第一个词之前,显卡就已经满了,所以 32B 是 16 GB 显卡的上限,舒适的尺寸要更低。
“122B-A10B”:哪个数字才算数#
名称中包含两个数字。根据模型卡,该模型总共有 122B 参数,每个 token 激活 10B。它是一个混合专家模型:内部有许多小型专家子网络,对于每个 token,路由器只唤醒其中少数几个。
想象一个有 122 个书架的书库,任何一个问题都会让你去其中 10 个书架。你的阅读量很小,但整个书库仍然必须在大楼内,因为你无法知道下一个词需要哪些书架。
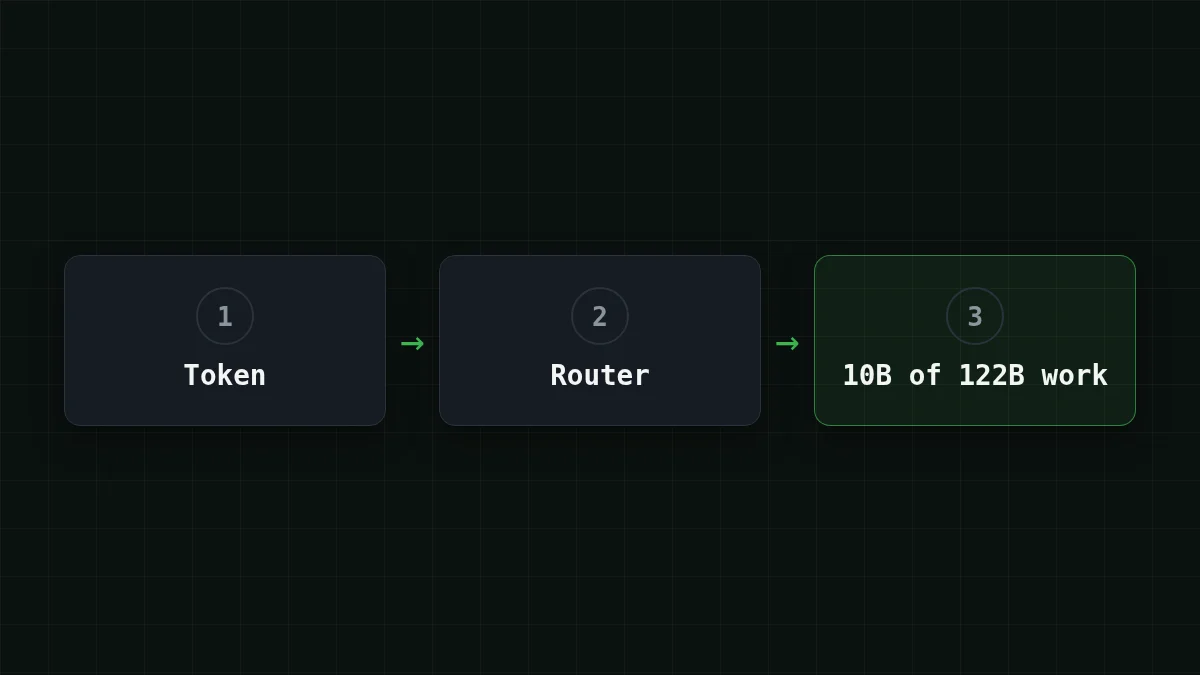
所以:内存跟随总量,计算跟随激活量。 一百亿激活参数使 token 的计算成本低,但存储成本并不低。将部分专家保留在内存或磁盘上的设置运行速度取决于你的内存、磁盘和软件。没有诚实的单一数字,所以对任何给出单一数字的标题都要保持警惕。
快速检查
一个模型被称为 122B-A10B。哪个数字大致决定了其权重需要多少内存?
显示答案
答案: 122B 总参数
所有专家都必须存储,因为路由器可以为下一个 token 选择其中任何一个。10B 只告诉你一个 token 需要多少计算量。
第二笔账单:上下文缓存#
权重是固定的部分。另一部分在你聊天时增长。为了避免为每个新 token 重新阅读整个对话,模型会为它已经看到的每个 token 保留笔记:KV 缓存(键和值)。上下文越长,缓存越大。如果你想从头了解上下文方面的解释,有一份关于上下文窗口的单独指南。
每个 token 的缓存占用:2 × 层数 × KV 头数 × 头大小 × 字节数。假设一个模型有 48 层、8 个 KV 头、头大小为 128,并使用 16 位缓存(这是假设的形状,不是任何模型卡中的):
- 一个 token:2 × 48 × 8 × 128 × 2 = 196608 字节,约 0.2 MB
- 32,768 个 token:196608 × 32768 = 6442450944 字节,约 6.4 GB
- 131,072 个 token(128K):196608 × 131072 = 25769803776 字节,约 25.8 GB
在 128K 时,仅缓存就比整张显卡还大。你的真实数字在模型的 config.json 中(层数、KV 头数、头大小),而且一些架构使缓存小得多,所以请将此视为方法,而不是对某个模型的定论。
Qwen3.5-122B-A10B 的模型卡展示了高端情况:其服务示例在完整的 262,144 token 上下文下使用跨 8 个 GPU 的张量并行。如果内存不足,它建议缩短上下文,同时保持至少 128K 以保留思考,并且 vLLM 标志 - 会跳过视觉编码器以释放缓存内存。
用十几行代码自己估算#
将两部分结合起来:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9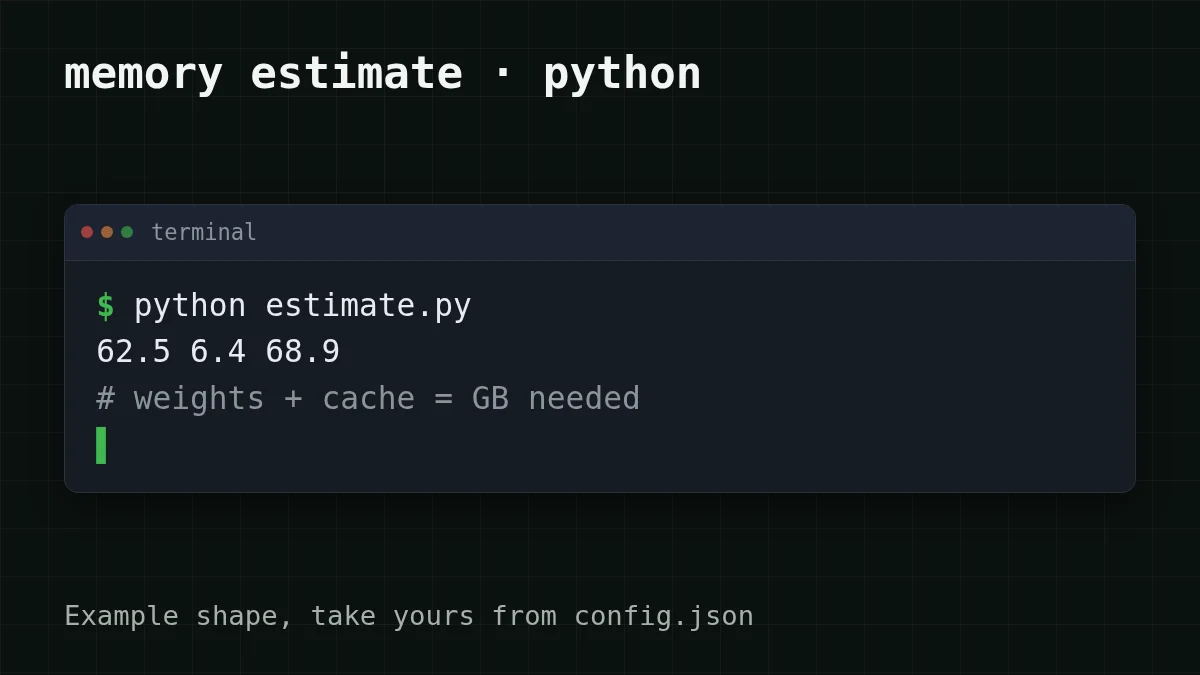
现在进行现实检查。假设你的 PC 有 32 GB 内存和 16 GB 显卡:16 + 32 = 48 GB,仍低于脚本打印的 68.9 GB。卸载将不得不求助于磁盘,而且你将主要从存储而不是显卡运行一个大模型。
何时 API 是更简单的选择#
并非每个任务都需要在你桌面上运行一个大模型。以下哪种描述符合你?
选择你的情况
哪种最接近你的情况?
选择一个选项以查看答案
我想看到模型在我自己的机器上运行
选一个小模型:在 4 位下,一个 7B 模型的权重约占 7 × 0.5 = 3.5 GB,因此它能装入 16 GB 显卡,并为长对话留出空间。了解模型的行为是在本地运行的最佳理由。另请参阅DeepSeek 的本地或 API。
每月几千个请求,我想要一个强大的模型
将它们发送到 API。你无需购买或租用内存,无需安装任何东西,账单仅为你实际使用的 token。
长文档或保持长历史的代理
缓存是增长的部分,在你自己的硬件上,它与权重竞争相同的内存。使用 API,上下文窗口是别人的问题:CheapTokens 上的 DeepSeek-V4-Flash 和 GLM-5.3-Flash 分别支持 380K 和 390K token。
实际应用中的样子。假设一个支持机器人每月总结 3,000 张工单,每张约 2,000 个输入 token 和 400 个输出 token。整个月就是 2000 × 3000 = 6000000 个输入 token 和 400 × 3000 = 1200000 个输出 token。在 DeepSeek-V4-Flash 上,输入每 1M token 花费 $0.015,输出每 1M token 花费 $0.10,所以整个月总计 $0.21。下表显示了每个模型上的相同负载,旁边是 OpenRouter 列,以便你可以比较总计、输入和输出:
| 模型 | 输入 $/1M | 输出 $/1M | 每次请求 | 3,000 次请求 | OpenRouter,3,000 次请求 |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
每次请求 2,000 个输入 token 和 400 个输出 token。每 100 万 token 的价格为当前价格,会随我们的资费一同变动;OpenRouter 列显示相同工作负载的参考价格。
请求本身与你向任何提供商发出的 OpenAI 风格调用相同。基础 URL 是 https:/,模型 ID 是完整的 deepseek-:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
回复包含一个 usage 块,其中包含输入和输出 token 计数,因此你可以在前十几个之后用自己的工单核对上述估算。DeepSeek-V4-Flash 每个答案最多提供 32,768 个输出 token,全天一个价格,而 GLM-5.3-Flash 是更轻量的日常选择,最多 8,192 个。设置详情见文档,模型页面是便宜的 DeepSeek,完整价格列表在定价页面上。
下次模型名称带有尺寸时,你现在有了三个步骤:乘法、加上缓存、与显卡比较。


