Um modelo de 125B roda em uma GPU de 16 GB? A matemática da memória
Quanta memória um modelo aberto de 125B precisa: pesos, quantização e cache KV em algumas linhas de matemática, e quando uma API é a forma mais simples de usá-lo.
Nesta página
Resposta curta: não. Um modelo de 125B parâmetros precisa de cerca de 62,5 GB para os pesos mesmo após compressão em 4 bits, e uma placa de vídeo de 16 GB comporta cerca de um quarto disso. Você ainda pode iniciá-lo empurrando o restante para a RAM do sistema ou para o disco, mas aí a placa deixa de ser o que decide como as coisas funcionam.
A seguir: como obter esse número sozinho em poucas linhas, o que “122B-A10B” em um nome de modelo realmente diz, e quando enviar requisições para uma API é a forma mais simples de usar um modelo grande.
Pesos: parâmetros vezes bytes#
Imagine um modelo como uma pilha enorme de números, chamados pesos ou parâmetros. Para responder, o computador precisa de todos eles na memória rápida ao mesmo tempo. Então a primeira estimativa é multiplicação simples: parâmetros em bilhões × bytes por peso = gigabytes. Um peso ocupa 2 bytes em 16 bits, 1 byte em 8 bits e 0,5 byte em 4 bits. É tudo o que a quantização faz: menos bits por número.
Pegue um modelo dessa classe, o Qwen3.5-122B-A10B. Sua página no Hugging Face (verificada em 30 de outubro de 2026) indica Apache-2.0 como licença, publica os pesos como BF16 e F32 e lista o tamanho como 125B parâmetros. Para 125B:
- Em 16 bits: 125 × 2 = 250 GB
- Em 8 bits: 125 × 1 = 125 GB
- Em 4 bits: 125 × 0,5 = 62,5 GB
- Em 2 bits: 125 × 0,25 = 31,25 GB
Até a linha de 2 bits é quase o dobro da placa. E esses são pisos, não totais: eles deixam de fora o cache de contexto (próximas seções) e a sobrecarga do próprio runtime, e formatos quantizados reais acrescentam um pouco mais.
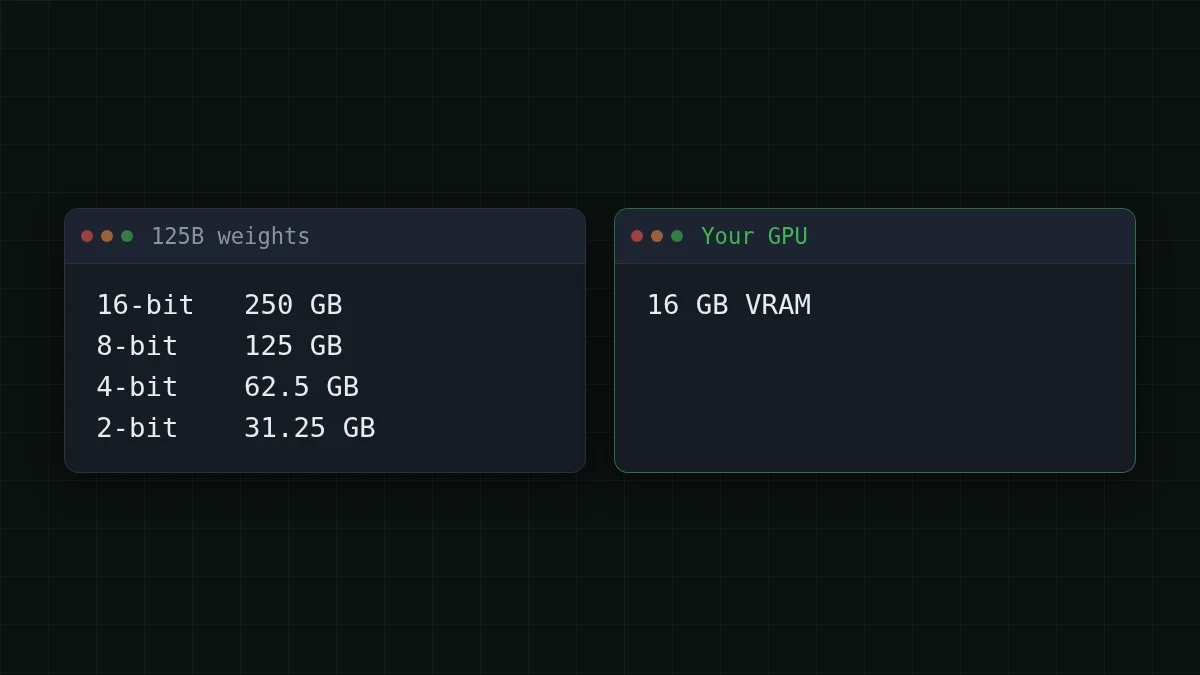
Inverta a fórmula para ver o que uma placa de 16 GB comporta. Em 4 bits, isso é 16 / 0,5 = 32 bilhões de parâmetros, e esse é o teto antes de qualquer outra coisa precisar de espaço. Faça a conta você mesmo:
Adivinhar o número
Quantos GB os pesos de um modelo de 32B ocupam em 4 bits?
O seu palpite
0100
Mostrar resposta
Resposta: 16
32 × 0,5 = 16 GB. A placa está cheia antes de o modelo ler uma única palavra da sua pergunta, então 32B é o teto para uma placa de 16 GB e tamanhos confortáveis ficam abaixo.
“122B-A10B”: qual número conta#
O nome carrega dois números. Segundo o model card, o modelo tem 122B parâmetros no total e 10B ativos para cada token. É um modelo de mistura de especialistas: dentro dele há muitas sub-redes especialistas pequenas, e para cada token um roteador acorda apenas algumas delas.
Pense em uma biblioteca com 122 estantes em que qualquer pergunta individual te leva a 10 delas. Seu esforço de leitura é pequeno, mas a biblioteca inteira ainda precisa estar dentro do prédio, porque você não pode saber quais estantes a próxima palavra vai precisar.
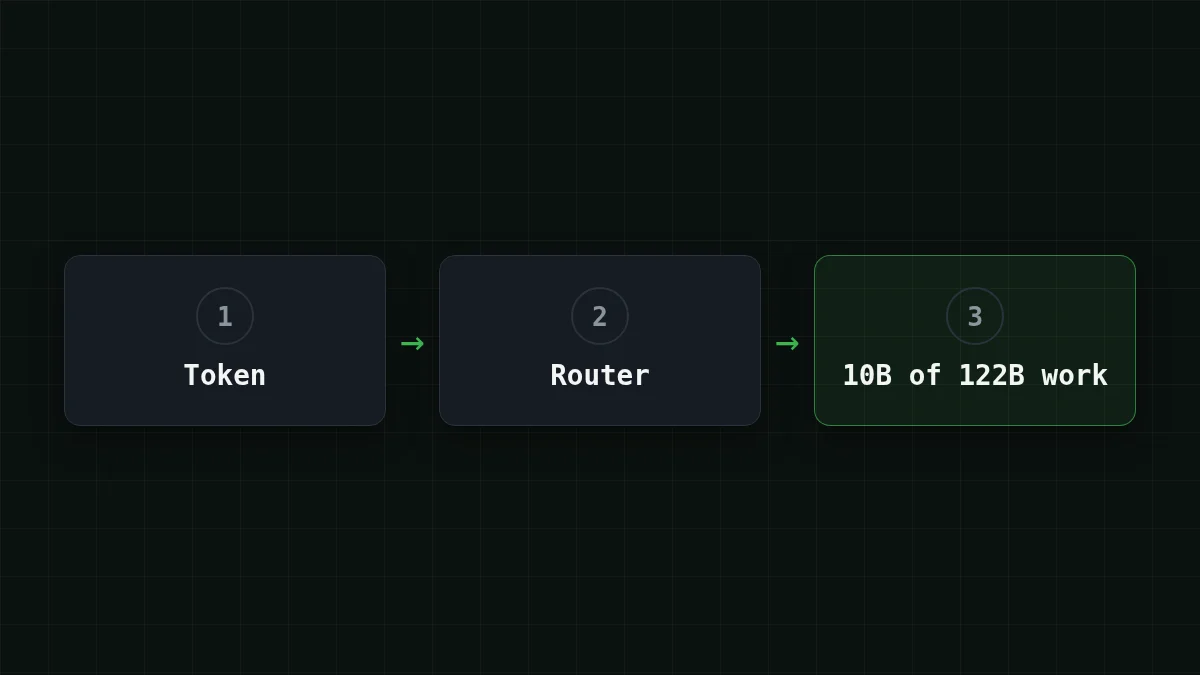
Então: a memória segue o total, a computação segue os ativos. Dez bilhões de parâmetros ativos tornam um token barato de computar, não barato de armazenar. A velocidade de uma configuração que mantém parte dos especialistas na RAM ou no disco depende da sua RAM, disco e software. Não existe um número único honesto, então desconfie de qualquer manchete que dê um.
Verificação rápida
Um modelo é chamado de 122B-A10B. Qual número define aproximadamente quanta memória seus pesos precisam?
Mostrar resposta
Resposta: Os 122B parâmetros totais
Todos os especialistas precisam ser armazenados, porque o roteador pode escolher qualquer um deles para o próximo token. Os 10B só dizem quanto trabalho um token dá.
A segunda conta: o cache de contexto#
Os pesos são a parte fixa. A outra parte cresce enquanto você conversa. Para evitar reler a conversa inteira a cada novo token, o modelo mantém anotações sobre cada token que já viu: o cache KV (chaves e valores). Contexto mais longo, cache maior. Se você quer a parte de contexto explicada do zero, há um guia separado sobre a janela de contexto.
Por token, o cache ocupa: 2 × camadas × cabeças KV × tamanho da cabeça × bytes. Digamos que um modelo tenha 48 camadas, 8 cabeças KV, tamanho de cabeça 128 e cache de 16 bits (um formato suposto, não o de nenhum model card):
- um token: 2 × 48 × 8 × 128 × 2 = 196608 bytes, cerca de 0,2 MB
- 32.768 tokens: 196608 × 32768 = 6442450944 bytes, cerca de 6,4 GB
- 131.072 tokens (128K): 196608 × 131072 = 25769803776 bytes, cerca de 25,8 GB
Em 128K, só esse cache é maior que a placa inteira. Seus números reais estão no config.json do modelo (camadas, cabeças KV, tamanho da cabeça), e algumas arquiteturas mantêm o cache muito menor, então trate isso como o método, não como um veredito sobre um modelo.
O card do Qwen3.5-122B-A10B mostra como é o extremo superior: seus exemplos de serving usam paralelismo de tensor em 8 GPUs no contexto completo de 262.144 tokens. Se a memória acabar, ele aconselha encurtar o contexto mantendo pelo menos 128K para preservar o raciocínio, e a flag - do vLLM pula o codificador de visão para liberar memória para o cache.
Sua própria estimativa em uma dúzia de linhas#
Junte as duas partes:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9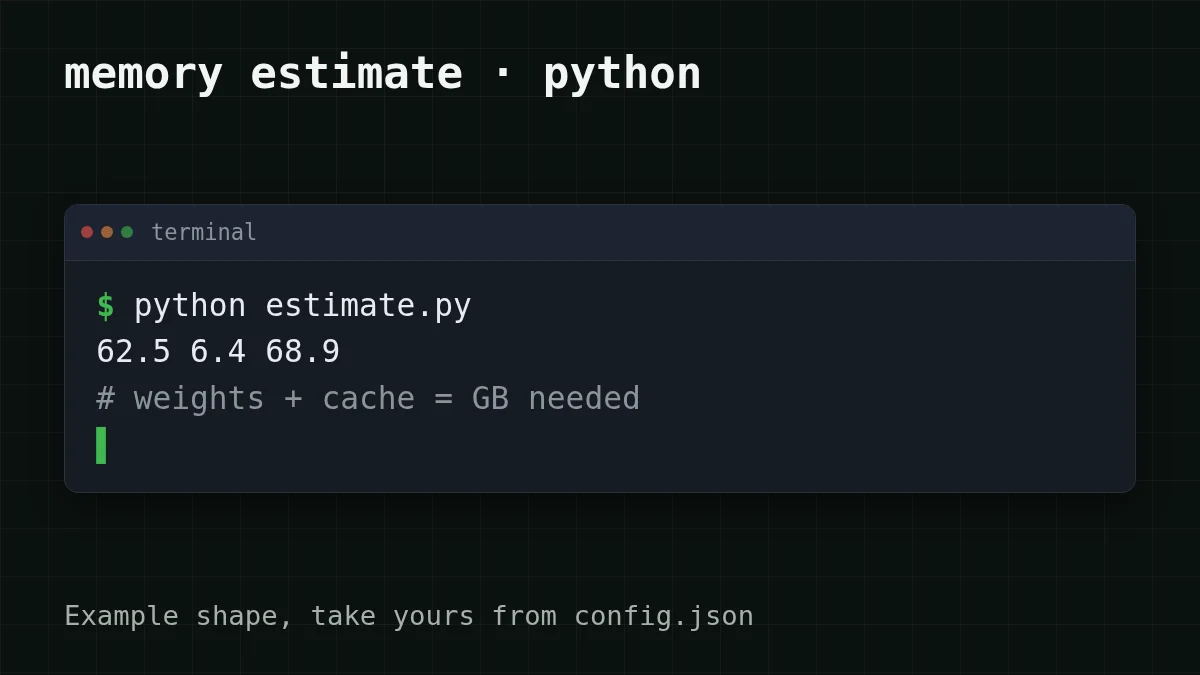
Agora a checagem de realidade. Digamos que seu PC tenha 32 GB de RAM ao lado da placa de 16 GB: 16 + 32 = 48 GB, ainda abaixo dos 68,9 GB que o script imprimiu. O offloading teria que recorrer também ao disco, e você estaria rodando um modelo grande principalmente a partir do armazenamento, não da placa.
Quando uma API é a escolha mais simples#
Nem toda tarefa precisa de um modelo grande na sua mesa. Qual descreve você?
Escolha o seu caso
Qual é o mais próximo do seu caso?
Escolha uma opção para ver a resposta
Quero ver um modelo rodando na minha própria máquina
Escolha um pequeno: em 4 bits, um modelo de 7B ocupa cerca de 7 × 0,5 = 3,5 GB para os pesos, então cabe em uma placa de 16 GB com espaço para uma conversa longa. Aprender como os modelos se comportam é o melhor motivo para rodar localmente. Veja também local ou API para DeepSeek.
Alguns milhares de requisições por mês, e quero um modelo forte
Envie para uma API. Você evita comprar ou alugar memória, não há nada para instalar, e a conta é só dos tokens que você realmente usa.
Documentos longos ou um agente que mantém um histórico longo
O cache é a parte que cresce, e no seu próprio hardware ele compete com os pesos pela mesma memória. Com uma API, a janela de contexto é problema de outra pessoa: DeepSeek-V4-Flash e GLM-5.3-Flash na CheapTokens aceitam 380K e 390K tokens.
Como isso fica na prática. Digamos que um bot de suporte resuma 3.000 tickets por mês, cada um com cerca de 2.000 tokens de entrada e 400 tokens de saída. Ao longo do mês, isso dá 2000 × 3000 = 6000000 tokens de entrada e 400 × 3000 = 1200000 tokens de saída. No DeepSeek-V4-Flash, a entrada custa $0.015 e a saída $0.10 por 1M tokens, então o mês inteiro fica em $0.21. A tabela abaixo mostra a mesma carga em todos os modelos, com a coluna do OpenRouter ao lado para você comparar no total, entrada e saída juntas:
| Modelo | Entrada $/1M | Saída $/1M | Por solicitação | 3.000 solicitações | OpenRouter, 3.000 solicitações |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2.000 tokens de entrada e 400 tokens de saída por solicitação. Os preços por 1M de tokens são atuais e mudam junto com nossas tarifas; a coluna OpenRouter mostra preços de referência para a mesma carga de trabalho.
A requisição em si é a mesma chamada no estilo OpenAI que você faria a qualquer provedor. A URL base é https:/, e o id do modelo é o deepseek- completo:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
A resposta traz um bloco usage com as contagens de tokens de entrada e saída, então você pode conferir a estimativa acima com seus próprios tickets depois da primeira dúzia. O DeepSeek-V4-Flash oferece até 32.768 tokens de saída por resposta a um preço único o dia todo, e o GLM-5.3-Flash é a opção mais leve para o dia a dia, com até 8.192. Os detalhes de configuração estão na documentação, a página do modelo é DeepSeek barato, e a lista completa de preços está na página de preços.
Da próxima vez que um nome de modelo vier com um tamanho, você já tem os três passos: multiplique, some o cache, compare com a placa.


