AI สำหรับผู้เริ่มต้นคู่มือ
โมเดล 125B รันบน GPU 16 GB ได้ไหม? คณิตศาสตร์ของหน่วยความจำ
โมเดลเปิด 125B ต้องใช้หน่วยความจำเท่าไร: น้ำหนัก, quantization และ KV cache ในคณิตศาสตร์ไม่กี่บรรทัด และเมื่อ API เป็นวิธีที่ง่ายกว่าในการใช้มัน
ในหน้านี้
คำตอบสั้น ๆ: ไม่ได้ โมเดลขนาด 125B พารามิเตอร์ต้องใช้หน่วยความจำประมาณ 62.5 GB สำหรับน้ำหนักของมัน แม้จะบีบอัดเหลือ 4 บิตแล้ว และการ์ดจอ 16 GB ก็เก็บได้เพียงประมาณหนึ่งในสี่ของจำนวนนั้น คุณยังสามารถเริ่มรันมันได้โดยผลักส่วนที่เหลือไปยัง RAM ของระบบหรือลงดิสก์ แต่การ์ดจอก็ไม่ใช่ตัวตัดสินว่าทุกอย่างจะดำเนินไปอย่างไรอีกต่อไป
ด้านล่าง: วิธีคำนวณตัวเลขนั้นด้วยตัวเองในไม่กี่บรรทัด "122B-A10B" ในชื่อโมเดลบอกอะไรคุณจริง ๆ และเมื่อใดการส่งคำขอไปยัง API เป็นวิธีที่ง่ายกว่าในการใช้โมเดลขนาดใหญ่
น้ำหนัก: พารามิเตอร์คูณไบต์#
ลองนึกภาพโมเดลเป็นกองตัวเลขมหาศาลที่เรียกว่าน้ำหนักหรือพารามิเตอร์ ในการตอบคุณ คอมพิวเตอร์ต้องมีตัวเลขทั้งหมดนั้นในหน่วยความจำเร็วพร้อมกัน ดังนั้นการประมาณการแรกคือการคูณธรรมดา: พารามิเตอร์เป็นพันล้าน × ไบต์ต่อน้ำหนัก = กิกะไบต์ น้ำหนักหนึ่งใช้ 2 ไบต์ที่ 16 บิต, 1 ไบต์ที่ 8 บิต และ 0.5 ไบต์ที่ 4 บิต นั่นคือทั้งหมดที่ quantization ทำ: ใช้บิตต่อจำนวนน้อยลง
ลองดูโมเดลในคลาสนี้ Qwen3.5-122B-A10B หน้า Hugging Face ของมัน (ตรวจสอบเมื่อ 30 ตุลาคม 2026) ระบุ Apache-2.0 เป็นสัญญาอนุญาต เผยแพร่น้ำหนักเป็น BF16 และ F32 และระบุขนาดเป็น 125B พารามิเตอร์ สำหรับ 125B:
- ที่ 16 บิต: 125 × 2 = 250 GB
- ที่ 8 บิต: 125 × 1 = 125 GB
- ที่ 4 บิต: 125 × 0.5 = 62.5 GB
- ที่ 2 บิต: 125 × 0.25 = 31.25 GB
แม้แต่บรรทัด 2 บิตก็ยังเกือบสองเท่าของการ์ด และนี่คือค่าต่ำสุด ไม่ใช่ผลรวม: พวกมันไม่รวมแคชบริบท (หัวข้อถัดไป) และโอเวอร์เฮดของรันไทม์เอง และรูปแบบ quantized จริงเพิ่มขึ้นเล็กน้อย
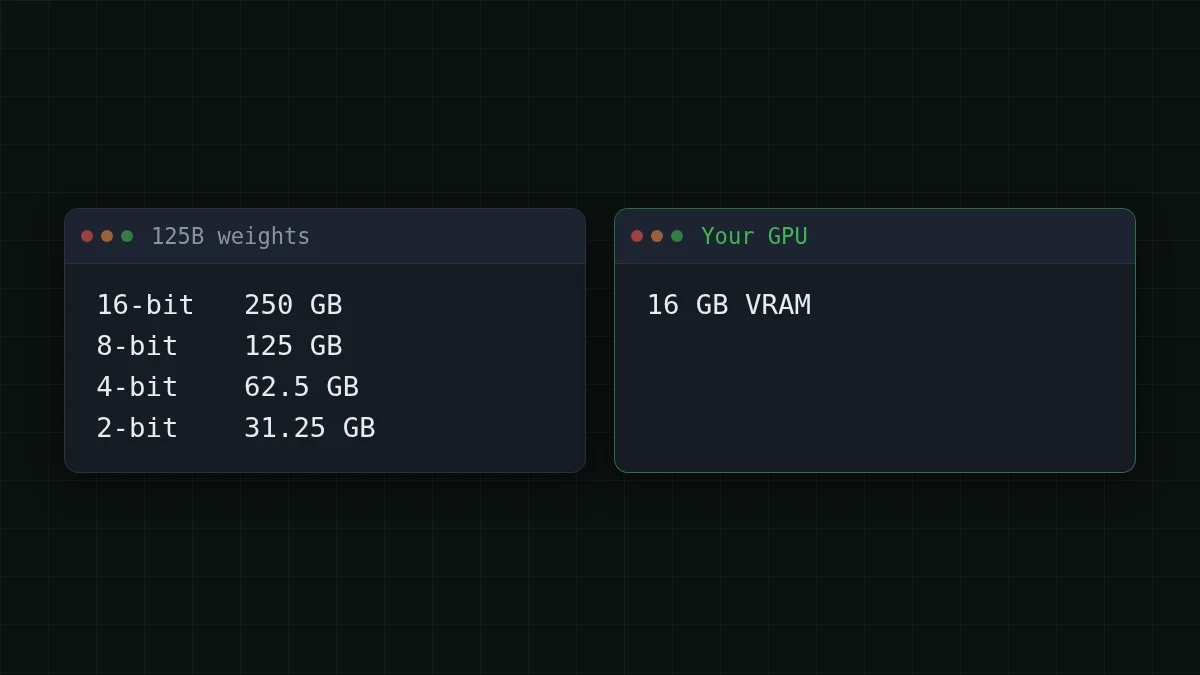
กลับสูตรเพื่อดูว่าการ์ด 16 GB เก็บได้เท่าไร ที่ 4 บิต นั่นคือ 16 / 0.5 = 32 พันล้านพารามิเตอร์ และนั่นคือเพดานก่อนที่สิ่งอื่นจะต้องการที่ ลองคำนวณเอง:
ทายตัวเลข
น้ำหนักของโมเดล 32B ใช้กี่ GB ที่ 4 บิต?
คำตอบของคุณ
0100
แสดงคำตอบ
คำตอบ: 16
32 × 0.5 = 16 GB การ์ดเต็มก่อนที่โมเดลจะอ่านคำแรกในคำถามของคุณด้วยซ้ำ ดังนั้น 32B คือเพดานสำหรับการ์ด 16 GB และขนาดที่สบายจะต่ำกว่านั้น
"122B-A10B": ตัวเลขไหนที่สำคัญ#
ชื่อบรรจุตัวเลขสองตัว ตามการ์ดโมเดล โมเดลมี 122B พารามิเตอร์ทั้งหมด และ 10B ที่ใช้งานต่อโทเค็น มันเป็นโมเดล mixture-of-experts: ภายในมีซับเน็ตเวิร์กผู้เชี่ยวชาญขนาดเล็กจำนวนมาก และสำหรับทุกโทเค็นเราเตอร์จะปลุกเพียงไม่กี่ตัว
ลองนึกถึงห้องสมุดที่มี 122 ชั้นวาง ซึ่งคำถามใด ๆ จะส่งคุณไปยัง 10 ชั้นวาง ความพยายามในการอ่านของคุณน้อย แต่ห้องสมุดทั้งหมดยังต้องอยู่ในอาคาร เพราะคุณไม่รู้ว่าชั้นวางไหนที่คำถัดไปจะต้องใช้
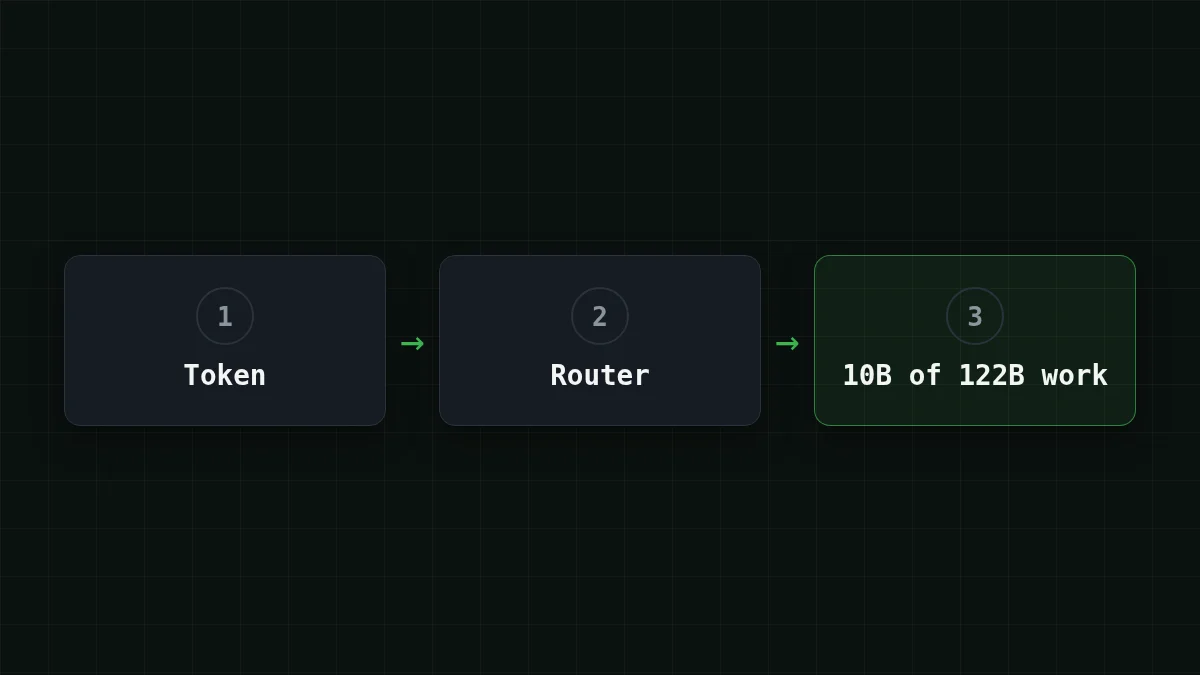
ดังนั้น: หน่วยความจำตามทั้งหมด การคำนวณตามที่ใช้งาน หนึ่งหมื่นล้านพารามิเตอร์ที่ใช้งานทำให้โทเค็นคำนวณถูก ไม่ใช่จัดเก็บถูก ความเร็วของเซ็ตอัปที่เก็บผู้เชี่ยวชาญบางส่วนไว้ใน RAM หรือดิสก์ขึ้นอยู่กับ RAM ดิสก์ และซอฟต์แวร์ของคุณ ไม่มีตัวเลขเดียวที่ซื่อสัตย์ ดังนั้นจงระวังพาดหัวใด ๆ ที่ให้ตัวเลขนั้น
เช็กด่วน
โมเดลถูกเรียกว่า 122B-A10B ตัวเลขใดประมาณการว่าหน่วยความจำสำหรับน้ำหนักต้องใช้เท่าไร?
แสดงคำตอบ
คำตอบ: พารามิเตอร์ทั้งหมด 122B
ผู้เชี่ยวชาญทั้งหมดต้องถูกจัดเก็บ เพราะเราเตอร์สามารถเลือกตัวใดก็ได้สำหรับโทเค็นถัดไป 10B บอกเพียงว่าหนึ่งโทเค็นต้องทำงานมากแค่ไหน
บิลที่สอง: แคชบริบท#
น้ำหนักเป็นส่วนที่คงที่ อีกส่วนเติบโตขึ้นขณะที่คุณแชท เพื่อหลีกเลี่ยงการอ่านบทสนทนาทั้งหมดใหม่สำหรับทุกโทเค็นใหม่ โมเดลเก็บบันทึกของแต่ละโทเค็นที่มันเคยเห็น: แคช KV (คีย์และค่า) บริบทที่ยาวขึ้น แคชใหญ่ขึ้น หากคุณต้องการคำอธิบายด้านบริบทตั้งแต่เริ่มต้น มี คู่มือแยกเกี่ยวกับหน้าต่างบริบท
ต่อโทเค็น แคชใช้: 2 × เลเยอร์ × KV heads × ขนาด head × ไบต์ สมมติว่าโมเดลมี 48 เลเยอร์, 8 KV heads, ขนาด head 128 และแคช 16 บิต (รูปร่างสมมติ ไม่ใช่จากโมเดลการ์ดใด ๆ):
- หนึ่งโทเค็น: 2 × 48 × 8 × 128 × 2 = 196608 ไบต์ ประมาณ 0.2 MB
- 32,768 โทเค็น: 196608 × 32768 = 6442450944 ไบต์ ประมาณ 6.4 GB
- 131,072 โทเค็น (128K): 196608 × 131072 = 25769803776 ไบต์ ประมาณ 25.8 GB
ที่ 128K แคชเพียงอย่างเดียวใหญ่กว่าการ์ดทั้งหมด ตัวเลขจริงของคุณอยู่ใน config.json ของโมเดล (เลเยอร์, KV heads, ขนาด head) และสถาปัตยกรรมบางแบบทำให้แคชเล็กกว่ามาก ดังนั้นถือว่านี่เป็นวิธีการ ไม่ใช่คำตัดสินเกี่ยวกับโมเดลใดโมเดลหนึ่ง
การ์ด Qwen3.5-122B-A10B แสดงให้เห็นว่าปลายใหญ่เป็นอย่างไร: ตัวอย่างการให้บริการใช้ tensor parallelism ข้าม 8 GPU ที่บริบทเต็ม 262,144 โทเค็น หากหน่วยความจำหมด มันแนะนำให้ย่อบริบทให้สั้นลงโดยคงอย่างน้อย 128K เพื่อรักษาการคิด และแฟล็ก vLLM - ข้ามตัวเข้ารหัสภาพเพื่อเพิ่มหน่วยความจำให้แคช
ประมาณการของคุณเองในสิบกว่าบรรทัด#
รวมทั้งสองส่วนเข้าด้วยกัน:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9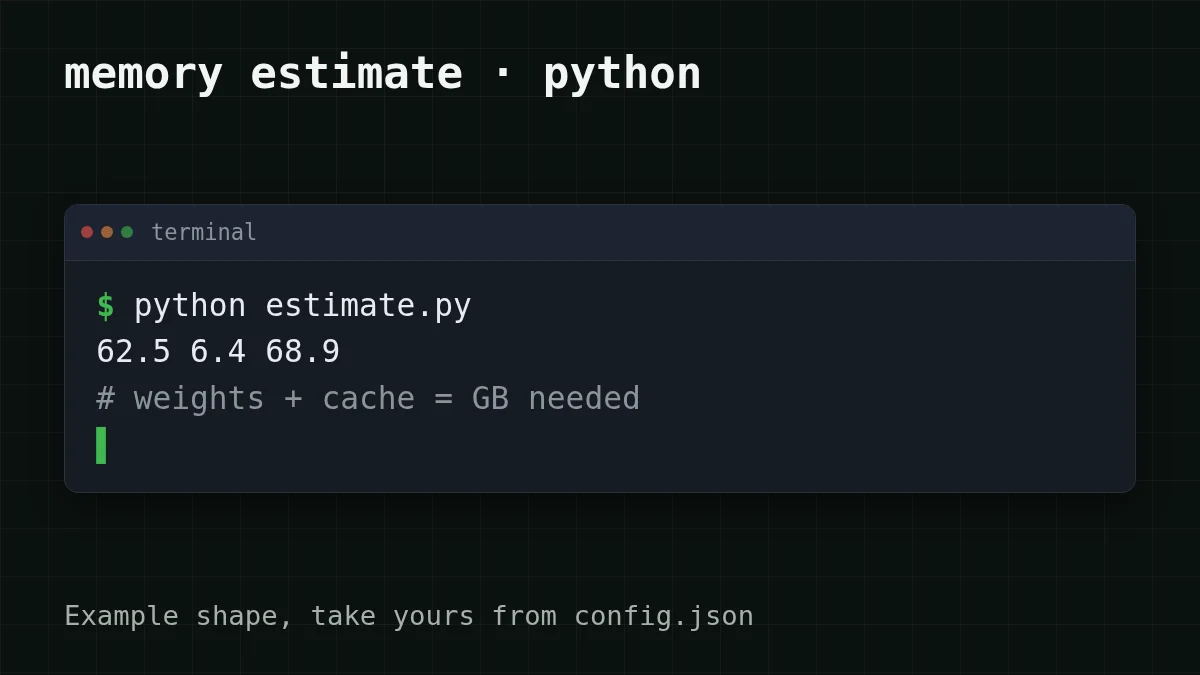
ตอนนี้ตรวจสอบความเป็นจริง สมมติว่า PC ของคุณมี RAM 32 GB beside การ์ด 16 GB: 16 + 32 = 48 GB ยังต่ำกว่า 68.9 GB ที่สคริปต์พิมพ์ การ offload จะต้องเข้าถึงดิสก์ด้วย และคุณจะรันโมเดลขนาดใหญ่ส่วนใหญ่จากที่จัดเก็บแทนที่จะจากการ์ด
เมื่อ API เป็นตัวเลือกที่ง่ายกว่า#
ไม่ใช่ทุกงานต้องการโมเดลขนาดใหญ่บนโต๊ะของคุณ ข้อใดอธิบายคุณ?
เลือกกรณีของคุณ
ข้อใดใกล้เคียงกับกรณีของคุณมากที่สุด?
เลือกตัวเลือกเพื่อดูคำตอบ
ฉันต้องการเห็นโมเดลรันบนเครื่องของตัวเอง
เลือกอันเล็ก: ที่ 4 บิต โมเดล 7B ใช้ประมาณ 7 × 0.5 = 3.5 GB สำหรับน้ำหนัก ดังนั้นมันพอดีกับการ์ด 16 GB โดยมีที่เหลือสำหรับแชทยาว การเรียนรู้ว่าโมเดลทำงานอย่างไรเป็นเหตุผลที่ดีที่สุดในการรันในเครื่อง ดูเพิ่มเติม local หรือ API สำหรับ DeepSeek
คำขอไม่กี่พันครั้งต่อเดือน และฉันต้องการโมเดลที่แข็งแกร่ง
ส่งไปยัง API คุณข้ามการซื้อหรือเช่าหน่วยความจำ ไม่มีอะไรต้องติดตั้ง และบิลเป็นเพียงโทเค็นที่คุณใช้จริง
เอกสารยาวหรือเอเจนต์ที่เก็บประวัติยาว
แคชเป็นส่วนที่เติบโต และบนฮาร์ดแวร์ของคุณเองมันแข่งขันกับน้ำหนักสำหรับหน่วยความจำเดียวกัน กับ API หน้าต่างบริบทเป็นปัญหาของคนอื่น: DeepSeek-V4-Flash และ GLM-5.3-Flash บน CheapTokens รับ 380K และ 390K โทเค็น
สิ่งที่ดูเหมือนในทางปฏิบัติ สมมติว่าบอตสนับสนุนสรุปตั๋ว 3,000 ใบต่อเดือน แต่ละใบประมาณ 2,000 โทเค็นเข้าและ 400 โทเค็นออก ตลอดเดือนนั่นคือ 2000 × 3000 = 6000000 โทเค็นอินพุตและ 400 × 3000 = 1200000 โทเค็นเอาต์พุต บน DeepSeek-V4-Flash อินพุตมีค่าใช้จ่าย $0.015 และเอาต์พุต $0.10 ต่อ 1M โทเค็น ดังนั้นทั้งเดือนรวมเป็น $0.21 ตารางด้านล่างแสดงภาระเดียวกันบนทุกโมเดล โดยมีคอลัมน์ OpenRouter อยู่ข้าง ๆ เพื่อให้คุณเปรียบเทียบเป็นยอดรวม อินพุตและเอาต์พุตรวมกัน:
| โมเดล | Input $/1M | Output $/1M | ต่อคำขอ | 3,000 คำขอ | OpenRouter, 3,000 คำขอ |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2,000 โทเค็นอินพุตและ 400 โทเค็นเอาต์พุตต่อคำขอ ราคาต่อ 1M โทเค็นเป็นราคาปัจจุบันและเปลี่ยนแปลงไปพร้อมกับอัตราค่าบริการของเรา คอลัมน์ OpenRouter แสดงราคาอ้างอิงสำหรับปริมาณงานเดียวกัน
คำขอเองเป็นการเรียกแบบ OpenAI ที่คุณจะส่งไปยังผู้ให้บริการใด ๆ URL ฐานคือ https:/ และ model id คือ deepseek- แบบเต็ม:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
การตอบกลับมีบล็อก usage พร้อมจำนวนโทเค็นอินพุตและเอาต์พุต ดังนั้นคุณสามารถตรวจสอบการประมาณการข้างต้นกับตั๋วของคุณเองได้หลังจากสิบกว่าใบ DeepSeek-V4-Flash ให้คุณได้ถึง 32,768 โทเค็นเอาต์พุตต่อคำตอบในราคาเดียวตลอดทั้งวัน และ GLM-5.3-Flash เป็นตัวเลือกประจำวันที่เบากว่าพร้อมสูงสุด 8,192 รายละเอียดการตั้งค่าอยู่ใน เอกสาร หน้าโมเดลคือ DeepSeek ราคาถูก และรายการราคาเต็มอยู่ใน หน้าราคา
ครั้งต่อไปที่ชื่อโมเดลมาพร้อมขนาด คุณมีสามขั้นตอนแล้ว: คูณ บวกแคช เปรียบเทียบกับการ์ด


