AI untuk pemulaPanduan
Bisakah model 125B berjalan di GPU 16 GB? Hitungan memorinya
Berapa banyak memori yang dibutuhkan model terbuka 125B: bobot, kuantisasi, dan cache KV dalam beberapa baris matematika, dan kapan API adalah cara yang lebih sederhana untuk menggunakannya.
Di halaman ini
Jawaban singkat: tidak. Model dengan 125B parameter membutuhkan sekitar 62,5 GB untuk bobotnya bahkan setelah kompresi 4-bit, dan kartu grafis 16 GB hanya menampung sekitar seperempatnya. Anda masih bisa menjalankannya dengan mendorong sisanya ke RAM sistem atau ke disk, tetapi saat itu kartu bukan lagi yang menentukan jalannya proses.
Di bawah ini: cara mendapatkan angka tersebut sendiri dalam beberapa baris, apa yang sebenarnya diberitahukan oleh “122B-A10B” dalam nama model, dan kapan mengirim permintaan ke API adalah cara yang lebih sederhana untuk menggunakan model besar.
Bobot: parameter dikali byte#
Bayangkan sebuah model sebagai tumpukan angka yang sangat besar, yang disebut bobot atau parameter. Untuk menjawab Anda, komputer perlu menyimpan semuanya di memori cepat sekaligus. Jadi perkiraan pertamanya adalah perkalian biasa: parameter dalam miliar × byte per bobot = gigabyte. Satu bobot memakan 2 byte pada 16-bit, 1 byte pada 8-bit, dan 0,5 byte pada 4-bit. Itulah yang dilakukan kuantisasi: lebih sedikit bit per angka.
Ambil model di kelas ini, Qwen3.5-122B-A10B. Halaman Hugging Face-nya (diperiksa 30 Oktober 2026) menyebut Apache-2.0 sebagai lisensi, menerbitkan bobot dalam BF16 dan F32, dan mencantumkan ukuran 125B parameter. Untuk 125B:
- Pada 16 bit: 125 × 2 = 250 GB
- Pada 8 bit: 125 × 1 = 125 GB
- Pada 4 bit: 125 × 0,5 = 62,5 GB
- Pada 2 bit: 125 × 0,25 = 31,25 GB
Bahkan baris 2-bit hampir dua kali lipat kartu. Dan ini adalah batas bawah, bukan total: angka ini belum menghitung cache konteks (bagian berikutnya) dan overhead runtime itu sendiri, serta format terkuantisasi nyata menambahkan sedikit di atasnya.
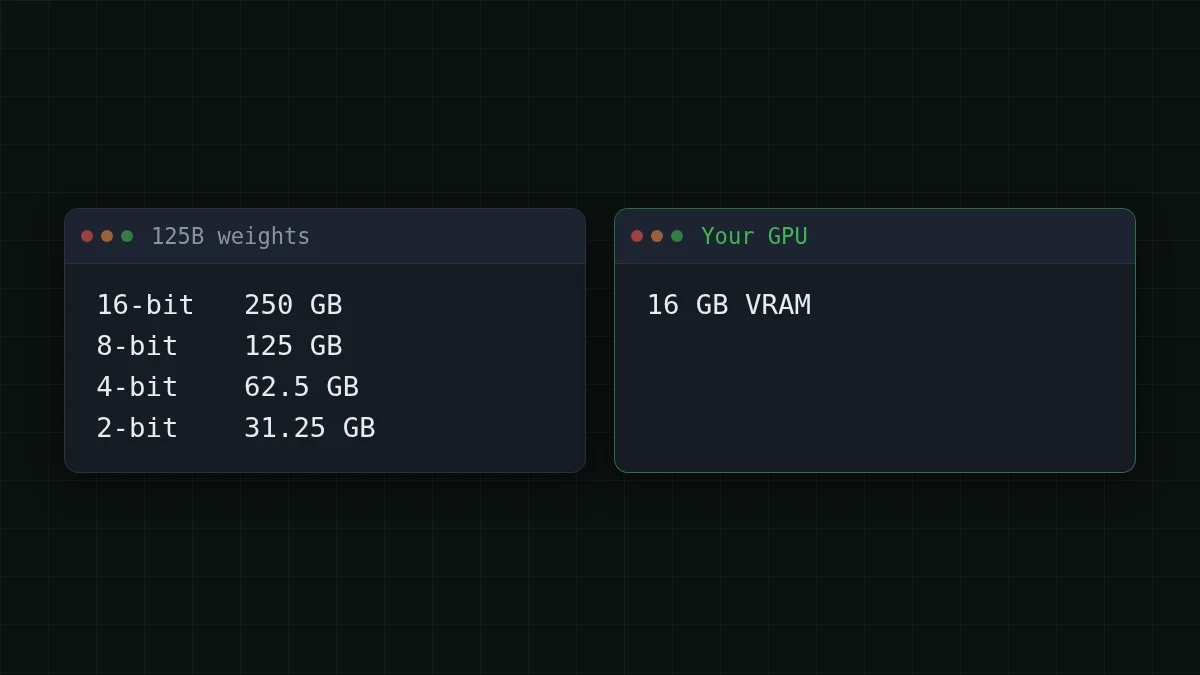
Balik rumusnya untuk melihat apa yang bisa ditampung kartu 16 GB. Pada 4-bit itu berarti 16 / 0,5 = 32 miliar parameter, dan itulah batas atas sebelum hal lain membutuhkan ruang. Coba hitung sendiri:
Tebak angkanya
Berapa GB yang dibutuhkan bobot model 32B pada 4-bit?
Tebakan Anda
0100
Tampilkan jawaban
Jawaban: 16
32 × 0,5 = 16 GB. Kartu sudah penuh sebelum model membaca satu kata pun dari pertanyaan Anda, jadi 32B adalah batas atas untuk kartu 16 GB dan ukuran yang nyaman berada lebih rendah.
“122B-A10B”: angka mana yang dihitung#
Nama itu memuat dua angka. Menurut kartu model, model ini memiliki total 122B parameter dan 10B aktif untuk setiap token. Ini adalah model mixture-of-experts: di dalamnya ada banyak sub-jaringan spesialis kecil, dan untuk setiap token sebuah router hanya membangunkan beberapa di antaranya.
Bayangkan sebuah perpustakaan dengan 122 rak di mana setiap pertanyaan mengirim Anda ke 10 rak. Upaya membaca Anda kecil, tetapi seluruh perpustakaan tetap harus berada di dalam gedung, karena Anda tidak bisa tahu rak mana yang dibutuhkan kata berikutnya.
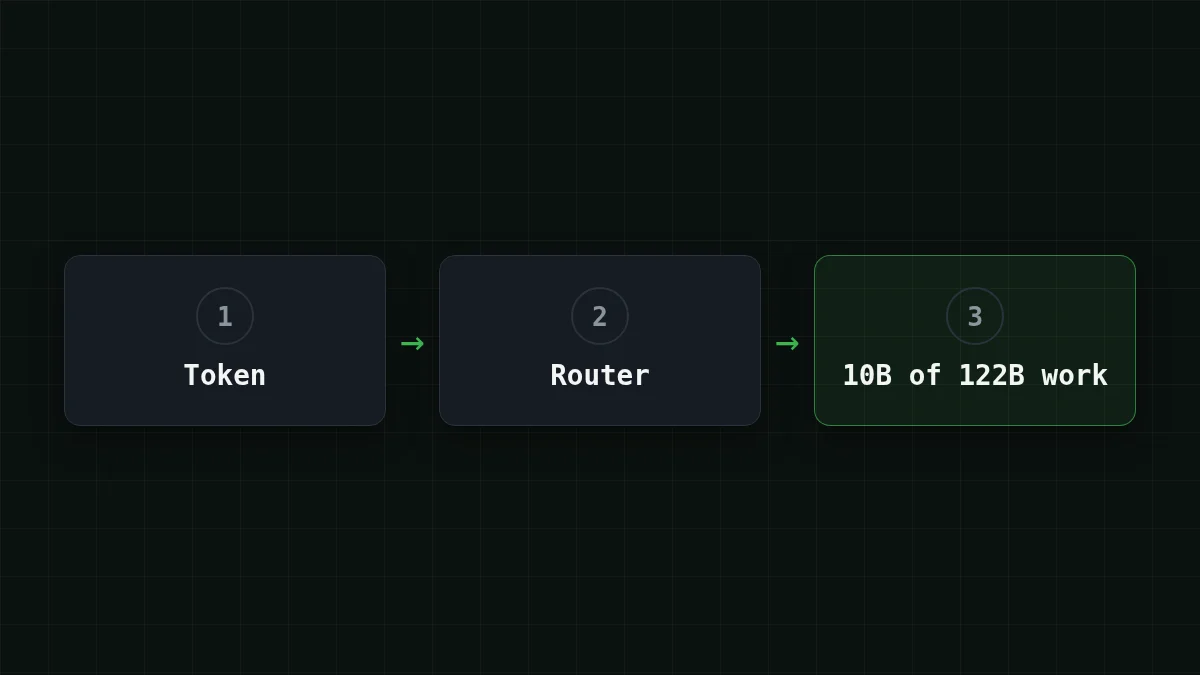
Jadi: memori mengikuti total, komputasi mengikuti yang aktif. Sepuluh miliar parameter aktif membuat sebuah token murah untuk dihitung, bukan murah untuk disimpan. Seberapa cepat setup yang menyimpan sebagian expert di RAM atau disk berjalan bergantung pada RAM, disk, dan perangkat lunak Anda. Tidak ada satu angka jujur, jadi waspadalah terhadap judul berita yang memberikannya.
Cek cepat
Sebuah model disebut 122B-A10B. Angka mana yang kira-kira menentukan berapa banyak memori yang dibutuhkan bobotnya?
Tampilkan jawaban
Jawaban: 122B parameter total
Semua expert harus disimpan, karena router dapat memilih salah satunya untuk token berikutnya. Angka 10B hanya memberi tahu Anda berapa banyak kerja yang dibutuhkan satu token.
Tagihan kedua: cache konteks#
Bobot adalah bagian yang tetap. Bagian lainnya tumbuh saat Anda mengobrol. Untuk menghindari membaca ulang seluruh percakapan untuk setiap token baru, model menyimpan catatan tentang setiap token yang sudah dilihatnya: cache KV (key dan value). Konteks lebih panjang, cache lebih besar. Jika Anda ingin penjelasan sisi konteks dari awal, ada panduan terpisah tentang jendela konteks.
Per token, cache memakan: 2 × layer × KV head × ukuran head × byte. Misalkan sebuah model memiliki 48 layer, 8 KV head, ukuran head 128, dan cache 16-bit (bentuk yang diasumsikan, bukan dari kartu model mana pun):
- satu token: 2 × 48 × 8 × 128 × 2 = 196608 byte, sekitar 0,2 MB
- 32.768 token: 196608 × 32768 = 6442450944 byte, sekitar 6,4 GB
- 131.072 token (128K): 196608 × 131072 = 25769803776 byte, sekitar 25,8 GB
Pada 128K, cache itu saja sudah lebih besar dari seluruh kartu. Angka nyata Anda ada di config.json model (layer, KV head, ukuran head), dan beberapa arsitektur menjaga cache jauh lebih kecil, jadi anggap ini sebagai metode, bukan sebagai putusan tentang satu model.
Kartu Qwen3.5-122B-A10B menunjukkan seperti apa ujung besarnya: contoh serving-nya menggunakan tensor parallelism di 8 GPU pada konteks penuh 262.144 token. Jika memori habis, ia menyarankan memperpendek konteks sambil mempertahankan setidaknya 128K untuk mempertahankan thinking, dan flag vLLM - melewati vision encoder untuk membebaskan memori bagi cache.
Perkiraan Anda sendiri dalam selusin baris#
Gabungkan kedua bagian:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9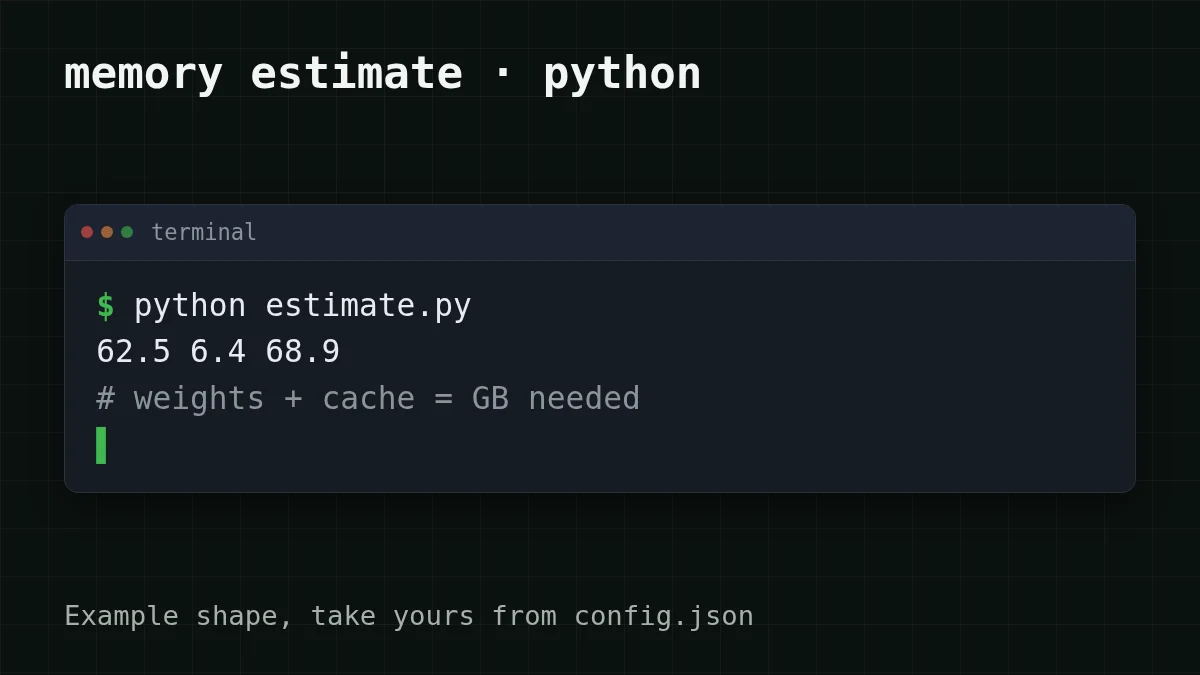
Sekarang cek kenyataannya. Katakanlah PC Anda memiliki RAM 32 GB di samping kartu 16 GB: 16 + 32 = 48 GB, masih di bawah 68,9 GB yang dicetak skrip. Offloading harus menjangkau disk juga, dan Anda akan menjalankan model besar sebagian besar dari penyimpanan, bukan dari kartu.
Kapan API adalah pilihan yang lebih sederhana#
Tidak setiap tugas membutuhkan model besar di meja Anda. Mana yang menggambarkan Anda?
Pilih kasus Anda
Mana yang paling dekat dengan kasus Anda?
Pilih opsi untuk melihat jawabannya
Saya ingin melihat model berjalan di mesin saya sendiri
Pilih yang kecil: pada 4-bit, model 7B memakan sekitar 7 × 0,5 = 3,5 GB untuk bobot, jadi cocok untuk kartu 16 GB dengan ruang untuk obrolan panjang. Mempelajari perilaku model adalah alasan terbaik untuk menjalankannya secara lokal. Lihat juga lokal atau API untuk DeepSeek.
Beberapa ribu permintaan sebulan, dan saya ingin model yang kuat
Kirim ke API. Anda melewati pembelian atau penyewaan memori, tidak ada yang perlu dipasang, dan tagihannya hanya token yang benar-benar Anda gunakan.
Dokumen panjang atau agen yang menyimpan riwayat panjang
Cache adalah bagian yang tumbuh, dan pada perangkat keras Anda sendiri ia bersaing dengan bobot untuk memori yang sama. Dengan API, jendela konteks adalah masalah orang lain: DeepSeek-V4-Flash dan GLM-5.3-Flash di CheapTokens menerima 380K dan 390K token.
Seperti apa itu dalam praktik. Katakanlah sebuah bot dukungan merangkum 3.000 tiket sebulan, masing-masing sekitar 2.000 token masuk dan 400 token keluar. Sepanjang bulan itu berarti 2000 × 3000 = 6000000 token input dan 400 × 3000 = 1200000 token output. Pada DeepSeek-V4-Flash, input berbiaya $0.015 dan output $0.10 per 1M token, jadi seluruh bulan menjadi $0.21. Tabel di bawah menunjukkan beban yang sama pada setiap model, dengan kolom OpenRouter di sampingnya agar Anda dapat membandingkan secara total, input dan output sekaligus:
| Model | Input $/1Jt | Output $/1Jt | Per permintaan | 3.000 permintaan | OpenRouter, 3.000 permintaan |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2.000 token input dan 400 token output per permintaan. Harga per 1 juta token adalah harga saat ini dan berubah seiring tarif kami; kolom OpenRouter menunjukkan harga referensi untuk beban kerja yang sama.
Permintaannya sendiri adalah panggilan bergaya OpenAI yang sama seperti yang Anda lakukan ke penyedia mana pun. Base URL-nya adalah https:/, dan id modelnya adalah deepseek- lengkap:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
Balasannya membawa blok usage dengan jumlah token input dan output, sehingga Anda dapat memeriksa perkiraan di atas terhadap tiket Anda sendiri setelah selusin pertama. DeepSeek-V4-Flash memberi Anda hingga 32.768 token output per jawaban dengan satu harga sepanjang waktu, dan GLM-5.3-Flash adalah opsi sehari-hari yang lebih ringan dengan hingga 8.192. Detail penyiapan ada di dokumentasi, halaman modelnya adalah DeepSeek murah, dan daftar harga lengkap ada di halaman harga.
Lain kali sebuah nama model disertai ukuran, Anda sekarang memiliki tiga langkah: kalikan, tambahkan cache, bandingkan dengan kartu.


