AI cho người mớiHướng dẫn
Mô hình 125B có chạy được trên GPU 16 GB không? Phép toán bộ nhớ
Một mô hình mở 125B cần bao nhiêu bộ nhớ: trọng số, lượng tử hóa và bộ nhớ đệm KV trong vài dòng toán, và khi nào API là cách đơn giản hơn để dùng nó.
Trên trang này
Câu trả lời ngắn: không. Một mô hình 125B tham số cần khoảng 62,5 GB cho trọng số ngay cả sau khi nén 4-bit, và một card đồ họa 16 GB chỉ chứa được khoảng một phần tư con số đó. Bạn vẫn có thể khởi chạy nó bằng cách đẩy phần còn lại vào RAM hệ thống hoặc lên đĩa, nhưng khi đó card không còn là thứ quyết định mọi thứ diễn ra thế nào.
Dưới đây: cách tự tính ra con số đó trong vài dòng, “122B-A10B” trong tên mô hình thực sự cho bạn biết điều gì, và khi nào gửi yêu cầu đến API là cách đơn giản hơn để dùng một mô hình lớn.
Trọng số: tham số nhân byte#
Hãy hình dung một mô hình như một đống số khổng lồ, gọi là trọng số hay tham số. Để trả lời bạn, máy tính cần tất cả chúng trong bộ nhớ nhanh cùng một lúc. Vậy ước tính đầu tiên chỉ là phép nhân đơn giản: tham số tính bằng tỷ × byte mỗi trọng số = gigabyte. Một trọng số chiếm 2 byte ở 16-bit, 1 byte ở 8-bit và 0,5 byte ở 4-bit. Đó là tất cả những gì lượng tử hóa làm: ít bit hơn cho mỗi số.
Lấy một mô hình thuộc lớp này, Qwen3.5-122B-A10B. Trang Hugging Face của nó (kiểm tra ngày 30 tháng 10 năm 2026) ghi giấy phép là Apache-2.0, công bố trọng số ở dạng BF16 và F32, và liệt kê kích thước là 125B tham số. Với 125B:
- Ở 16 bit: 125 × 2 = 250 GB
- Ở 8 bit: 125 × 1 = 125 GB
- Ở 4 bit: 125 × 0,5 = 62,5 GB
- Ở 2 bit: 125 × 0,25 = 31,25 GB
Ngay cả dòng 2-bit cũng gần gấp đôi card. Và đây là mức sàn, không phải tổng: chúng bỏ qua bộ nhớ đệm ngữ cảnh (các phần tiếp theo) và chi phí vận hành của runtime, và các định dạng lượng tử hóa thực tế thêm vào một chút.
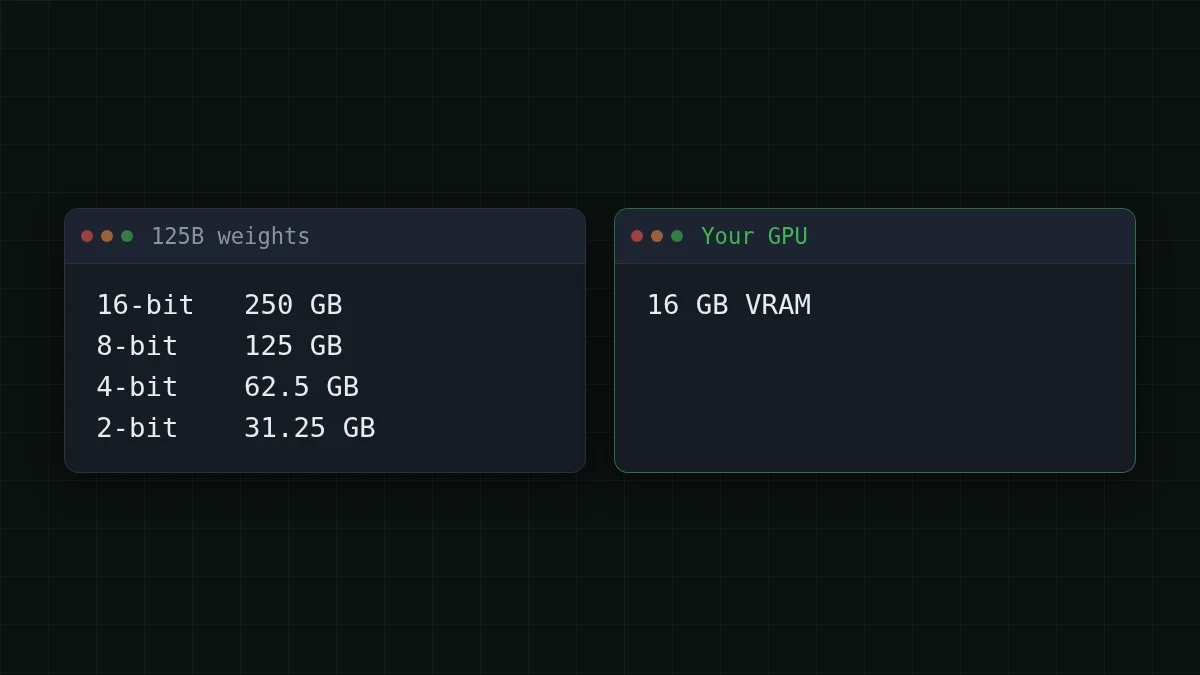
Đảo công thức để xem card 16 GB chứa được gì. Ở 4-bit, đó là 16 / 0,5 = 32 tỷ tham số, và đó là mức trần trước khi bất cứ thứ gì khác cần chỗ. Tự thử phép tính:
Đoán số
Trọng số của mô hình 32B chiếm bao nhiêu GB ở 4-bit?
Dự đoán của bạn
0100
Hiện đáp án
Trả lời: 16
32 × 0,5 = 16 GB. Card đầy trước khi mô hình đọc được một từ nào trong câu hỏi của bạn, vậy 32B là mức trần cho card 16 GB và các kích thước thoải mái nằm thấp hơn.
“122B-A10B”: con số nào mới quan trọng#
Cái tên chứa hai con số. Theo thẻ mô hình, mô hình có tổng cộng 122B tham số và 10B hoạt động cho mỗi token. Đây là mô hình hỗn hợp chuyên gia: bên trong là nhiều mạng con chuyên biệt nhỏ, và với mỗi token một bộ định tuyến chỉ đánh thức một vài trong số chúng.
Hãy nghĩ đến một thư viện có 122 kệ, nơi bất kỳ câu hỏi nào cũng chỉ đưa bạn đến 10 kệ. Công sức đọc của bạn nhỏ, nhưng cả thư viện vẫn phải nằm trong tòa nhà, vì bạn không thể biết từ tiếp theo sẽ cần những kệ nào.
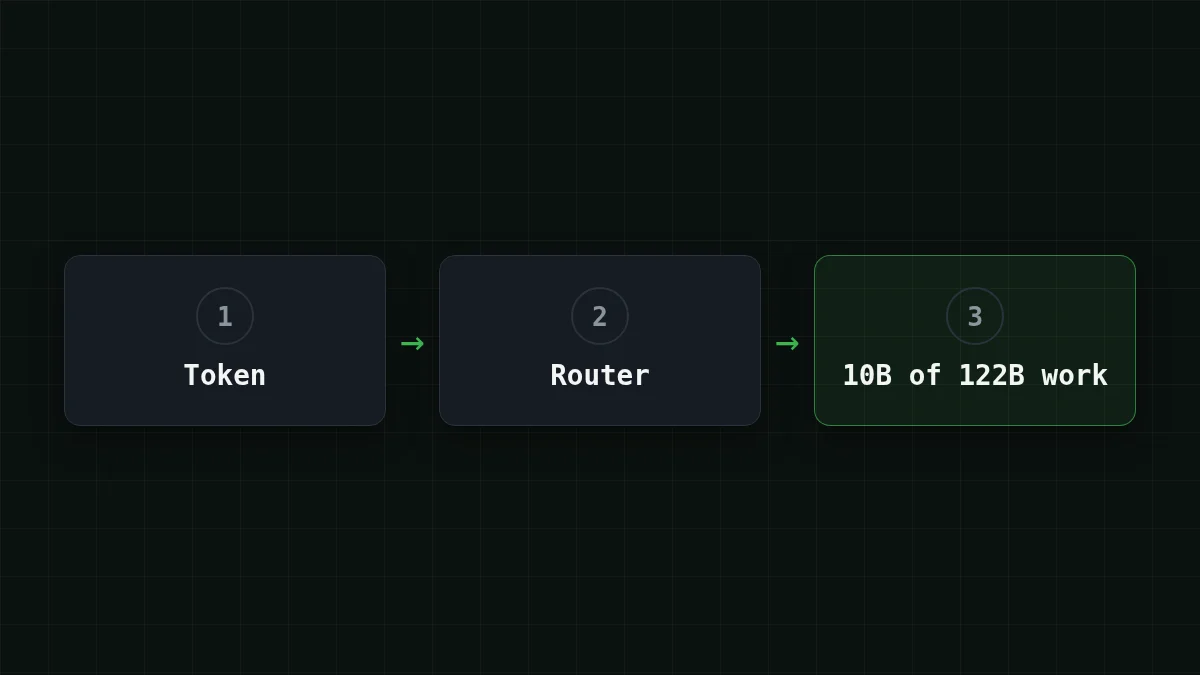
Vậy: bộ nhớ theo tổng, tính toán theo hoạt động. Mười tỷ tham số hoạt động làm cho một token rẻ để tính toán, không rẻ để lưu trữ. Một thiết lập giữ một phần chuyên gia trong RAM hoặc trên đĩa chạy nhanh đến đâu phụ thuộc vào RAM, đĩa và phần mềm của bạn. Không có một con số trung thực duy nhất, nên hãy cảnh giác với bất kỳ tiêu đề nào đưa ra một con số như vậy.
Kiểm tra nhanh
Một mô hình được gọi là 122B-A10B. Con số nào gần đúng quyết định lượng bộ nhớ mà trọng số của nó cần?
Hiện đáp án
Trả lời: 122B tổng tham số
Tất cả chuyên gia phải được lưu trữ, vì bộ định tuyến có thể chọn bất kỳ chuyên gia nào cho token tiếp theo. 10B chỉ cho bạn biết một token tốn bao nhiêu công sức.
Hóa đơn thứ hai: bộ nhớ đệm ngữ cảnh#
Trọng số là phần cố định. Phần còn lại tăng lên trong khi bạn trò chuyện. Để tránh đọc lại toàn bộ cuộc hội thoại cho mỗi token mới, mô hình giữ ghi chú về từng token nó đã thấy: bộ nhớ đệm KV (khóa và giá trị). Ngữ cảnh càng dài, bộ nhớ đệm càng lớn. Nếu bạn muốn giải thích phần ngữ cảnh từ đầu, có một hướng dẫn riêng về cửa sổ ngữ cảnh.
Mỗi token, bộ nhớ đệm chiếm: 2 × số lớp × số đầu KV × kích thước đầu × byte. Giả sử một mô hình có 48 lớp, 8 đầu KV, kích thước đầu 128 và bộ nhớ đệm 16-bit (một hình dạng giả định, không phải từ bất kỳ thẻ mô hình nào):
- một token: 2 × 48 × 8 × 128 × 2 = 196608 byte, khoảng 0,2 MB
- 32.768 token: 196608 × 32768 = 6442450944 byte, khoảng 6,4 GB
- 131.072 token (128K): 196608 × 131072 = 25769803776 byte, khoảng 25,8 GB
Ở 128K, chỉ riêng bộ nhớ đệm đó đã lớn hơn toàn bộ card. Con số thực của bạn nằm trong config.json của mô hình (số lớp, số đầu KV, kích thước đầu), và một số kiến trúc giữ bộ nhớ đệm nhỏ hơn nhiều, nên hãy coi đây là phương pháp, không phải phán quyết về một mô hình cụ thể.
Thẻ Qwen3.5-122B-A10B cho thấy đầu lớn trông thế nào: các ví dụ phục vụ của nó dùng song song tensor trên 8 GPU ở ngữ cảnh đầy đủ 262.144 token. Nếu hết bộ nhớ, nó khuyên rút ngắn ngữ cảnh trong khi giữ ít nhất 128K để bảo toàn suy nghĩ, và cờ vLLM - bỏ qua bộ mã hóa thị giác để giải phóng bộ nhớ cho bộ nhớ đệm.
Ước tính của riêng bạn trong một tá dòng#
Ghép cả hai phần lại:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9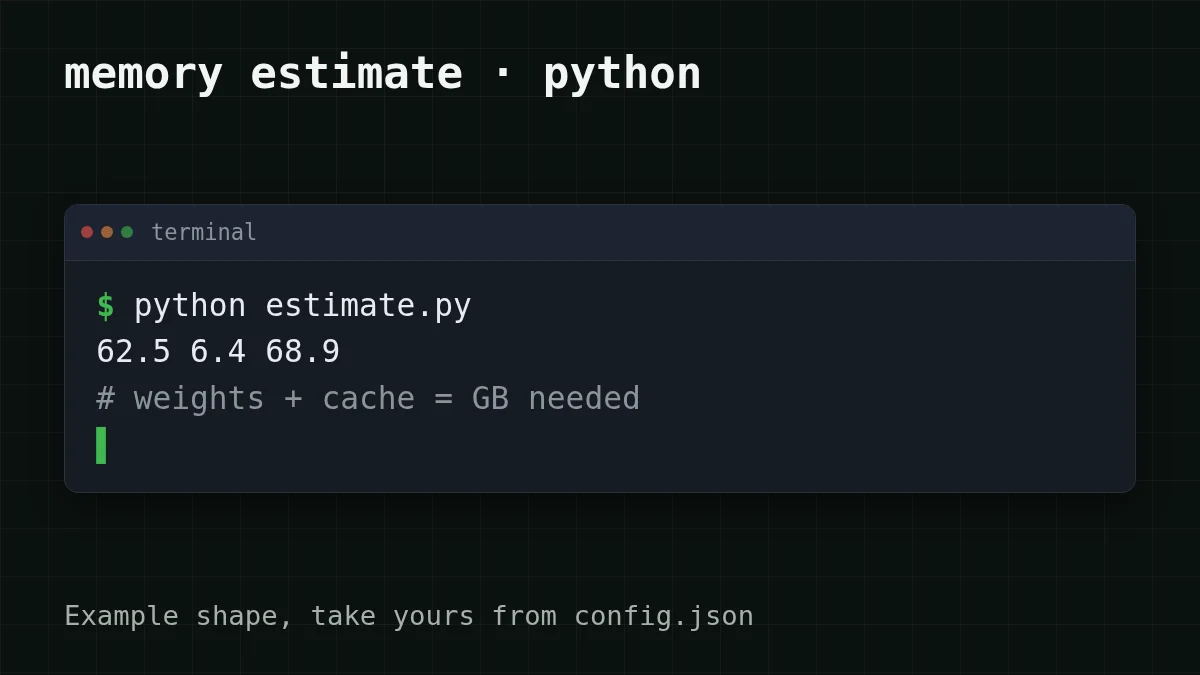
Giờ là kiểm tra thực tế. Giả sử PC của bạn có 32 GB RAM bên cạnh card 16 GB: 16 + 32 = 48 GB, vẫn dưới 68,9 GB mà script in ra. Việc offload sẽ phải chạm đến cả đĩa, và bạn sẽ chạy một mô hình lớn chủ yếu từ bộ nhớ lưu trữ chứ không phải từ card.
Khi API là lựa chọn đơn giản hơn#
Không phải mọi tác vụ đều cần một mô hình lớn trên bàn của bạn. Điều nào mô tả bạn?
Chọn trường hợp của bạn
Điều nào gần nhất với trường hợp của bạn?
Chọn một tùy chọn để xem đáp án
Tôi muốn thấy một mô hình chạy trên máy của mình
Chọn một mô hình nhỏ: ở 4-bit, mô hình 7B chiếm khoảng 7 × 0,5 = 3,5 GB cho trọng số, nên nó vừa với card 16 GB với chỗ trống cho một cuộc trò chuyện dài. Học cách mô hình hoạt động là lý do tốt nhất để chạy cục bộ. Xem thêm cục bộ hay API cho DeepSeek.
Vài nghìn yêu cầu một tháng, và tôi muốn một mô hình mạnh
Gửi chúng đến API. Bạn bỏ qua việc mua hoặc thuê bộ nhớ, không có gì để cài đặt, và hóa đơn chỉ là số token bạn thực sự dùng.
Tài liệu dài hoặc một agent giữ lịch sử dài
Bộ nhớ đệm là phần tăng lên, và trên phần cứng của riêng bạn nó cạnh tranh với trọng số cho cùng bộ nhớ. Với API, cửa sổ ngữ cảnh là vấn đề của người khác: DeepSeek-V4-Flash và GLM-5.3-Flash trên CheapTokens nhận 380K và 390K token.
Điều đó trông thế nào trong thực tế. Giả sử một bot hỗ trợ tóm tắt 3.000 ticket một tháng, mỗi ticket khoảng 2.000 token đầu vào và 400 token đầu ra. Trong tháng đó là 2000 × 3000 = 6000000 token đầu vào và 400 × 3000 = 1200000 token đầu ra. Trên DeepSeek-V4-Flash, đầu vào tốn $0.015 và đầu ra $0.10 mỗi 1M token, nên cả tháng tốn $0.21. Bảng dưới đây cho thấy cùng tải lượng trên mọi mô hình, với cột OpenRouter bên cạnh để bạn so sánh tổng cộng, đầu vào và đầu ra cùng nhau:
| Mô hình | Đầu vào $/1M | Đầu ra $/1M | Mỗi yêu cầu | 3.000 yêu cầu | OpenRouter, 3.000 yêu cầu |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2.000 token đầu vào và 400 token đầu ra mỗi yêu cầu. Giá trên 1 triệu token là giá hiện hành và thay đổi cùng với biểu phí của chúng tôi; cột OpenRouter hiển thị giá tham chiếu cho cùng khối lượng công việc.
Bản thân yêu cầu là lệnh gọi kiểu OpenAI giống như bạn sẽ gửi đến bất kỳ nhà cung cấp nào. URL cơ sở là https:/, và id mô hình là deepseek- đầy đủ:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
Phản hồi mang một khối usage với số lượng token đầu vào và đầu ra, để bạn có thể kiểm tra ước tính ở trên với ticket của riêng bạn sau một tá yêu cầu đầu tiên. DeepSeek-V4-Flash cho bạn tối đa 32.768 token đầu ra mỗi câu trả lời với một mức giá suốt ngày đêm, và GLM-5.3-Flash là lựa chọn hàng ngày nhẹ hơn với tối đa 8.192. Chi tiết thiết lập có trong tài liệu, trang mô hình là DeepSeek giá rẻ, và danh sách giá đầy đủ ở trang giá.
Lần tới khi một tên mô hình đi kèm với kích thước, bạn đã có ba bước: nhân, cộng bộ nhớ đệm, so sánh với card.


