AI入門ガイド
125Bモデルは16 GB GPUで動くのか?メモリの計算
125Bのオープンモデルに必要なメモリ量:重み、量子化、KVキャッシュを数行の計算で求め、APIの方が簡単に使えるのはどんな場合かを解説します。
短い答え:いいえ。125Bパラメータのモデルは、4ビット圧縮後でも重みに約62.5 GBを必要とし、16 GBのグラフィックスカードにはその約4分の1しか収まりません。残りをシステムRAMやディスクに追い出すことで起動はできますが、その場合カードはもはや動作を左右する要素ではありません。
以下では、その数値を数行で自分で求める方法、「122B-A10B」というモデル名が実際に何を教えてくれるのか、そして大きなモデルを使うのにAPIへリクエストを送る方が簡単なのはどんな場合かを説明します。
重み:パラメータ数 × バイト数#
モデルを、重み(パラメータ)と呼ばれる膨大な数の集まりとして想像してください。答えるためには、コンピュータはそれらすべてを一度に高速メモリ上に置く必要があります。したがって最初の見積もりは単純な掛け算です:パラメータ数(十億)× 重みあたりのバイト数 = ギガバイト。重みは16ビットで2バイト、8ビットで1バイト、4ビットで0.5バイトを占めます。量子化がやっているのはこれだけです:数値あたりのビット数を減らすことです。
このクラスのモデル、Qwen3.5-122B-A10Bを例に取りましょう。そのHugging Faceページ(2026年10月30日確認)では、ライセンスとしてApache-2.0を挙げ、重みをBF16とF32で公開し、サイズを125Bパラメータと記載しています。125Bの場合:
- 16ビット:125 × 2 = 250 GB
- 8ビット:125 × 1 = 125 GB
- 4ビット:125 × 0.5 = 62.5 GB
- 2ビット:125 × 0.25 = 31.25 GB
2ビットの行でさえカードのほぼ2倍です。しかもこれらは下限であり総量ではありません:コンテキストキャッシュ(次のセクション)やランタイム自体のオーバーヘッドを含んでおらず、実際の量子化フォーマットではさらに少し上乗せされます。
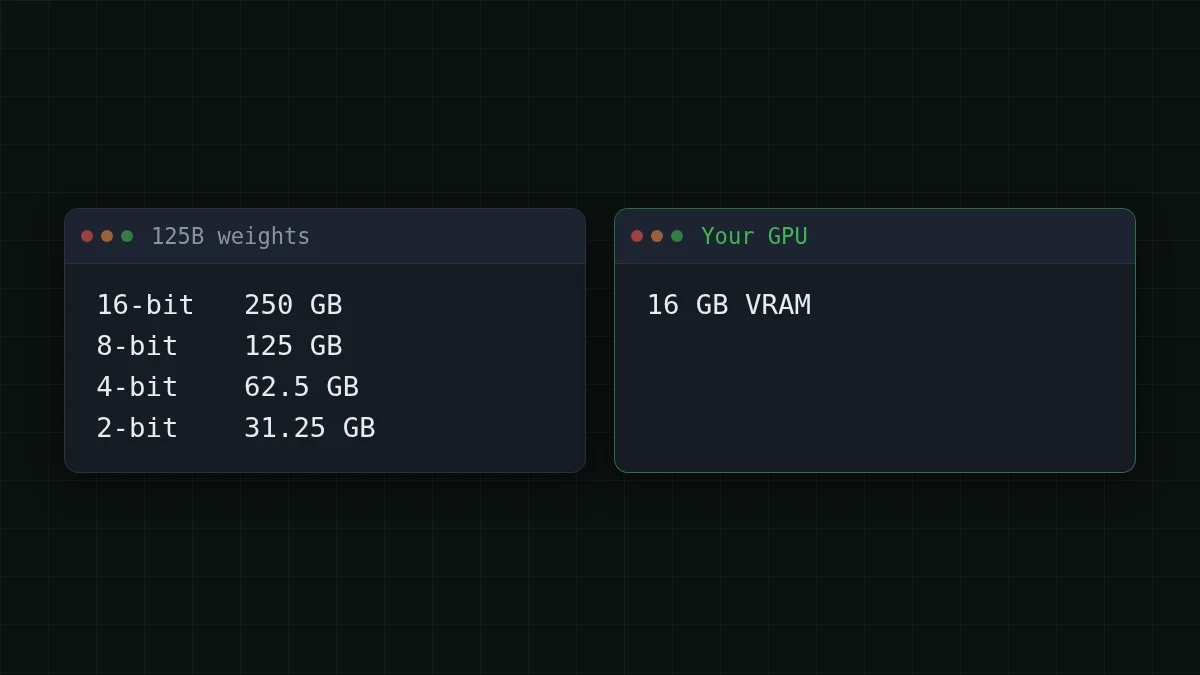
式を逆にすれば、16 GBカードに何が収まるかがわかります。4ビットなら16 / 0.5 = 320億パラメータで、これが他に何も場所を必要としない場合の上限です。自分で計算してみましょう:
数字を当てる
32Bモデルの重みは4ビットで何GBになりますか?
あなたの予想
0100
答えを表示
答え: 16
32 × 0.5 = 16 GB。モデルがあなたの質問の一言も読む前にカードは満杯になるので、16 GBカードの上限は32Bであり、余裕のあるサイズはそれより下になります。
「122B-A10B」:どちらの数が効くのか#
この名前には2つの数が詰まっています。モデルカードによれば、モデルは合計122Bパラメータを持ち、トークンごとに10Bがアクティブになります。これはmixture-of-expertsモデルです:内部には多数の小さな専門サブネットワークがあり、トークンごとにルーターがそのうちの少数だけを起動します。
122の棚がある図書館で、どんな質問でもそのうち10の棚へ案内される場面を想像してください。あなたの読む手間は小さいですが、図書館全体は建物の中になければなりません。次の単語がどの棚を必要とするかはわからないからです。
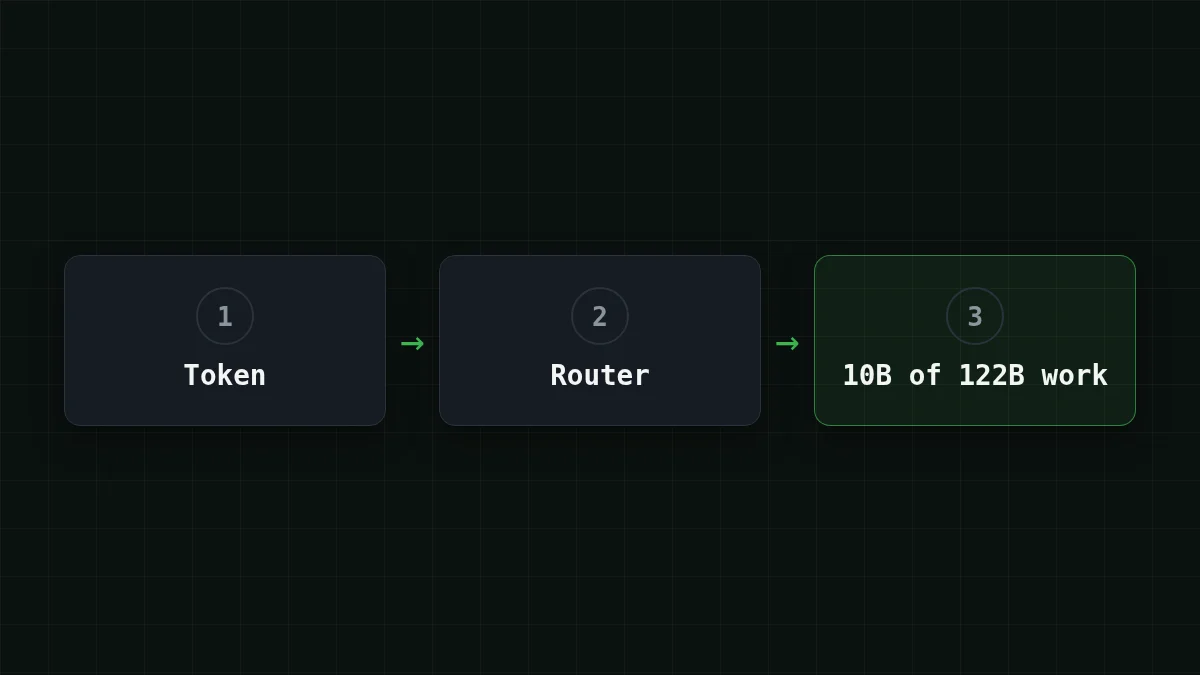
つまり:メモリは合計に従い、計算はアクティブな数に従う。 100億のアクティブパラメータはトークンの計算を安くしますが、保存を安くはしません。エキスパートの一部をRAMやディスクに置く構成がどれだけ速く動くかは、RAM、ディスク、ソフトウェア次第です。正直な単一の数値は存在しないので、それを示す見出しには注意してください。
クイックチェック
あるモデルは122B-A10Bと呼ばれています。重みに必要なメモリ量を大まかに決めるのはどちらの数ですか?
答えを表示
答え: 合計122Bパラメータ
ルーターは次のトークンにどのエキスパートでも選べるため、すべてのエキスパートを保存する必要があります。10Bは1トークンの計算量を教えてくれるだけです。
2つ目の請求:コンテキストキャッシュ#
重みは固定部分です。もう一方はチャット中に増えていきます。新しいトークンごとに会話全体を読み直さないよう、モデルはすでに見た各トークンについての記録を保持します:KVキャッシュ(キーとバリュー)です。コンテキストが長いほどキャッシュは大きくなります。コンテキスト側を一から説明したものが必要なら、コンテキストウィンドウに関する別のガイドがあります。
トークンあたりのキャッシュは:2 × レイヤー数 × KVヘッド数 × ヘッドサイズ × バイト数。あるモデルが48レイヤー、8 KVヘッド、ヘッドサイズ128、16ビットキャッシュを持つとします(仮定の形状であり、どのモデルカードのものではありません):
- 1トークン:2 × 48 × 8 × 128 × 2 = 196608バイト、約0.2 MB
- 32,768トークン:196608 × 32768 = 6442450944バイト、約6.4 GB
- 131,072トークン(128K):196608 × 131072 = 25769803776バイト、約25.8 GB
128Kではそのキャッシュだけでカード全体より大きくなります。実際の数値はモデルのconfig.json(レイヤー数、KVヘッド数、ヘッドサイズ)にあり、アーキテクチャによってはキャッシュをはるかに小さく保てるので、これは特定モデルへの判定ではなく手法として扱ってください。
Qwen3.5-122B-A10Bのカードは大きな側の例を示しています:そのサービング例では、最大262,144トークンのコンテキストで8 GPUにわたるテンソル並列を使用します。メモリが不足した場合は、思考を保つために少なくとも128Kを維持しつつコンテキストを短縮するよう助言しており、vLLMのフラグ-はビジョンエンコーダをスキップしてキャッシュ用のメモリを解放します。
十数行で自分の見積もりを#
両方の部分を合わせます:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9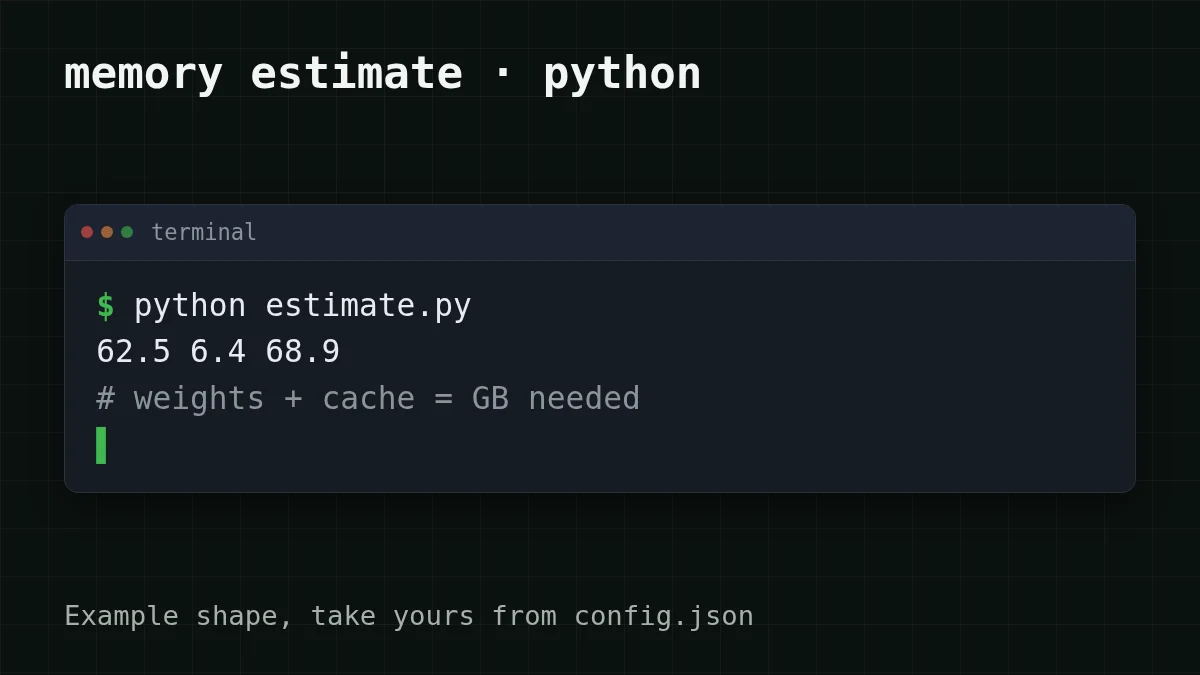
ここで現実確認です。あなたのPCに16 GBカードと並んで32 GBのRAMがあるとします:16 + 32 = 48 GBで、スクリプトが出力した68.9 GBをまだ下回ります。オフロードはディスクにも頼らざるを得ず、大きなモデルをカードではなく主にストレージから動かすことになります。
APIがより簡単な選択になる場合#
すべてのタスクが机の上に大きなモデルを必要とするわけではありません。あなたはどれに当てはまりますか?
ケースを選ぶ
あなたのケースに最も近いのはどれですか?
オプションを選択して答えを表示
自分のマシンでモデルを動かすところを見たい
小さなものを選びましょう:4ビットなら7Bモデルの重みは約7 × 0.5 = 3.5 GBなので、長いチャットの余地を残して16 GBカードに収まります。モデルの振る舞いを学ぶことはローカルで動かす最良の理由です。DeepSeekのローカルかAPIかも参照してください。
月に数千リクエストで、強力なモデルが欲しい
APIに送りましょう。メモリの購入やレンタルは不要で、インストールするものもなく、請求は実際に使ったトークン分だけです。
長い文書、または長い履歴を保つエージェント
増えるのはキャッシュの部分で、自分のハードウェアでは同じメモリを重みと奪い合います。APIならコンテキストウィンドウは他人の問題です:CheapTokensのDeepSeek-V4-FlashとGLM-5.3-Flashは380Kと390Kトークンを扱えます。
実際にどうなるか。サポートボットが月に3,000件のチケットを要約し、各チケットが入力約2,000トークン、出力400トークンだとします。1か月では2000 × 3000 = 6000000入力トークン、400 × 3000 = 1200000出力トークンです。DeepSeek-V4-Flashでは入力が$0.015、出力が$0.10(100万トークンあたり)なので、1か月全体で$0.21になります。下の表は同じ負荷をすべてのモデルで示し、隣にOpenRouterの列を並べて、合計・入力・出力をまとめて比較できるようにしています:
| モデル | 入力 $/1M | 出力 $/1M | リクエストあたり | 3,000 リクエスト | OpenRouter、3,000 リクエスト |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
リクエストあたり 2,000 入力トークンと 400 出力トークン。100万トークンあたりの価格は現行のもので、当社の料金体系に合わせて変動します。OpenRouter 列は同じワークロードの参考価格を示しています。
リクエスト自体は、どのプロバイダーにも送るのと同じOpenAI形式の呼び出しです。ベースURLはhttps:/、モデルIDは完全なdeepseek-です:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
}'応答には入力トークン数と出力トークン数を含むusageブロックが付くので、最初の十数件の後で上の見積もりを自分のチケットと照合できます。DeepSeek-V4-Flashは1回答あたり最大32,768出力トークンを24時間同じ価格で提供し、GLM-5.3-Flashは最大8,192のより軽い日常向けオプションです。設定の詳細はドキュメント、モデルページは安価なDeepSeek、完全な価格表は価格ページにあります。
次にモデル名とサイズを見かけたら、3つの手順があります:掛ける、キャッシュを足す、カードと比べる。


