IA pour débutantsGuide
Un modèle 125B peut-il tourner sur un GPU de 16 Go ? Le calcul de mémoire
Combien de mémoire nécessite un modèle ouvert 125B : poids, quantification et cache KV en quelques lignes de calcul, et quand une API est la façon la plus simple de l'utiliser.
Sur cette page
Réponse courte : non. Un modèle de 125 milliards de paramètres a besoin d'environ 62,5 Go pour ses poids, même après compression en 4 bits, et une carte graphique de 16 Go en contient environ un quart. Vous pouvez toujours le lancer en poussant le reste dans la RAM système ou sur le disque, mais ce n'est alors plus la carte qui décide du déroulement des choses.
Ci-dessous : comment obtenir ce chiffre vous-même en quelques lignes, ce que « 122B-A10B » dans le nom d'un modèle vous dit vraiment, et quand envoyer des requêtes à une API est la façon la plus simple d'utiliser un grand modèle.
Poids : paramètres fois octets#
Imaginez un modèle comme un énorme tas de nombres, appelés poids ou paramètres. Pour vous répondre, l'ordinateur a besoin de tous ces nombres en mémoire rapide en même temps. La première estimation est donc une simple multiplication : milliards de paramètres × octets par poids = gigaoctets. Un poids occupe 2 octets en 16 bits, 1 octet en 8 bits et 0,5 octet en 4 bits. C'est tout ce que fait la quantification : moins de bits par nombre.
Prenez un modèle de cette classe, Qwen3.5-122B-A10B. Sa page Hugging Face (consultée le 30 octobre 2026) indique Apache-2.0 comme licence, publie les poids en BF16 et F32, et affiche une taille de 125 milliards de paramètres. Pour 125B :
- En 16 bits : 125 × 2 = 250 Go
- En 8 bits : 125 × 1 = 125 Go
- En 4 bits : 125 × 0,5 = 62,5 Go
- En 2 bits : 125 × 0,25 = 31,25 Go
Même la ligne 2 bits fait presque le double de la carte. Et ce sont des planchers, pas des totaux : ils omettent le cache de contexte (sections suivantes) et la surcharge du runtime, et les formats quantifiés réels ajoutent un peu par-dessus.
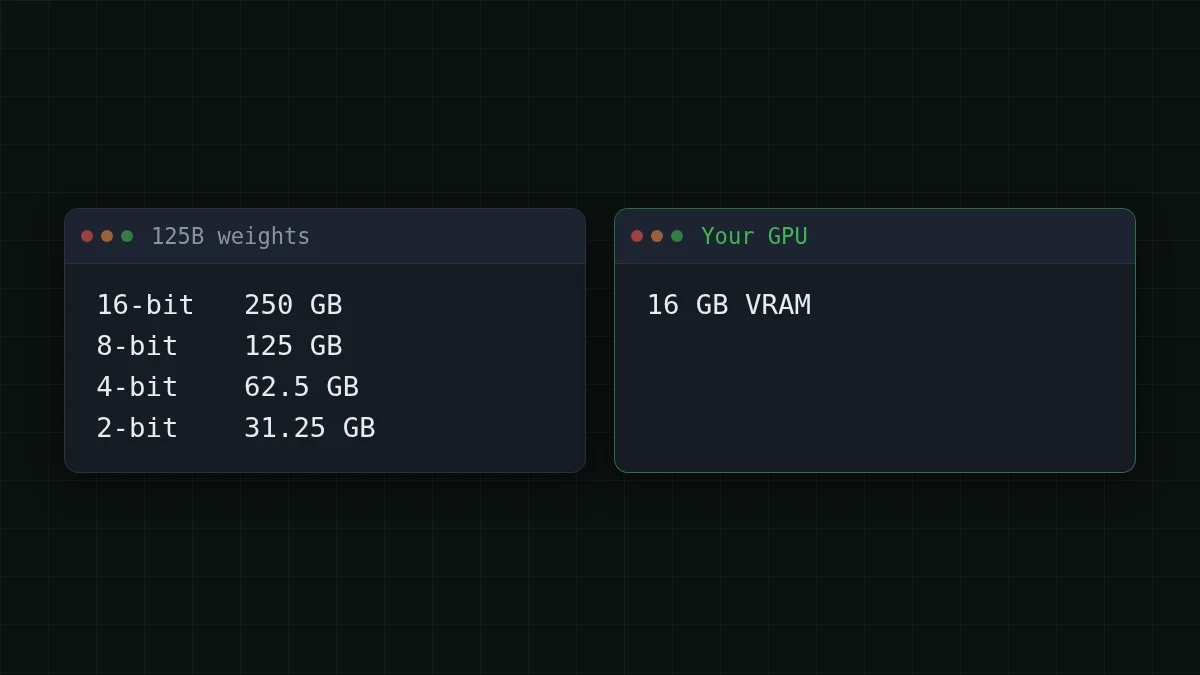
Retournez la formule pour voir ce qu'une carte de 16 Go peut contenir. En 4 bits, cela fait 16 / 0,5 = 32 milliards de paramètres, et c'est le plafond avant que quoi que ce soit d'autre n'ait besoin de place. Faites le calcul vous-même :
Devinez le nombre
Combien de Go prennent les poids d'un modèle 32B en 4 bits ?
Votre estimation
0100
Afficher la réponse
Réponse: 16
32 × 0,5 = 16 Go. La carte est pleine avant que le modèle ait lu un seul mot de votre question, donc 32B est le plafond pour une carte de 16 Go et les tailles confortables se situent plus bas.
« 122B-A10B » : quel nombre compte#
Le nom contient deux nombres. D'après la fiche du modèle, le modèle a 122B de paramètres au total et 10B actifs pour chaque token. C'est un modèle à mélange d'experts : à l'intérieur se trouvent de nombreux petits sous-réseaux spécialisés, et pour chaque token un routeur n'en réveille que quelques-uns.
Pensez à une bibliothèque de 122 rayons où chaque question vous envoie vers 10 d'entre eux. Votre effort de lecture est faible, mais toute la bibliothèque doit quand même être dans le bâtiment, car vous ne pouvez pas savoir de quels rayons le prochain mot aura besoin.
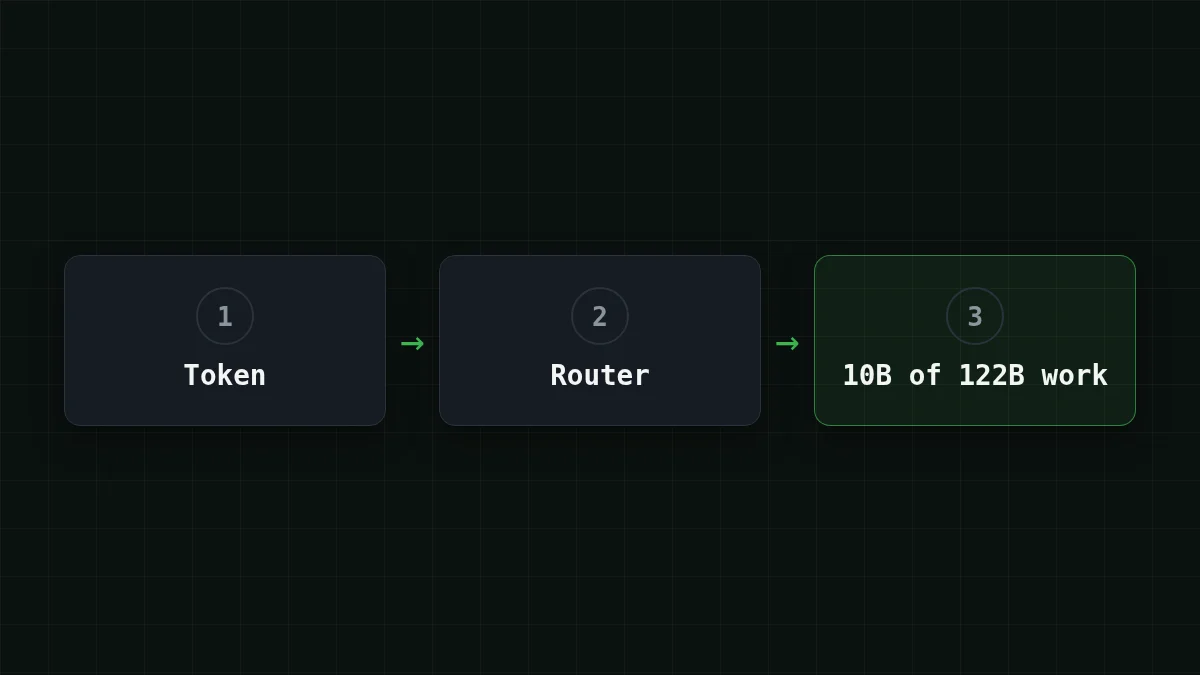
Donc : la mémoire suit le total, le calcul suit l'actif. Dix milliards de paramètres actifs rendent un token peu coûteux à calculer, pas à stocker. La vitesse d'une installation qui garde une partie des experts en RAM ou sur disque dépend de votre RAM, de votre disque et de votre logiciel. Il n'y a pas de chiffre unique honnête, alors méfiez-vous de tout titre qui en donne un.
Vérification rapide
Un modèle s'appelle 122B-A10B. Quel nombre détermine approximativement la mémoire nécessaire à ses poids ?
Afficher la réponse
Réponse: Les 122B de paramètres totaux
Tous les experts doivent être stockés, car le routeur peut en choisir n'importe lequel pour le prochain token. Les 10B indiquent seulement la quantité de travail d'un token.
La deuxième facture : le cache de contexte#
Les poids sont la partie fixe. L'autre partie grandit pendant que vous discutez. Pour éviter de relire toute la conversation à chaque nouveau token, le modèle conserve des notes sur chaque token déjà vu : le cache KV (clés et valeurs). Contexte plus long, cache plus gros. Si vous voulez l'explication du contexte depuis le début, il y a un guide séparé sur la fenêtre de contexte.
Par token, le cache occupe : 2 × couches × têtes KV × taille de tête × octets. Supposons un modèle à 48 couches, 8 têtes KV, une taille de tête de 128 et un cache en 16 bits (une forme supposée, pas celle d'une fiche de modèle) :
- un token : 2 × 48 × 8 × 128 × 2 = 196608 octets, environ 0,2 Mo
- 32 768 tokens : 196608 × 32768 = 6442450944 octets, environ 6,4 Go
- 131 072 tokens (128K) : 196608 × 131072 = 25769803776 octets, environ 25,8 Go
À 128K, ce cache seul est plus grand que toute la carte. Vos chiffres réels se trouvent dans le config.json du modèle (couches, têtes KV, taille de tête), et certaines architectures gardent le cache bien plus petit, alors traitez ceci comme la méthode, pas comme un verdict sur un modèle.
La fiche de Qwen3.5-122B-A10B montre à quoi ressemble le haut du panier : ses exemples de service utilisent le parallélisme tensoriel sur 8 GPU avec le contexte complet de 262 144 tokens. Si la mémoire manque, elle conseille de raccourcir le contexte en gardant au moins 128K pour préserver la réflexion, et l'option vLLM - saute l'encodeur visuel pour libérer de la mémoire pour le cache.
Votre propre estimation en une douzaine de lignes#
Combinez les deux parties :
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9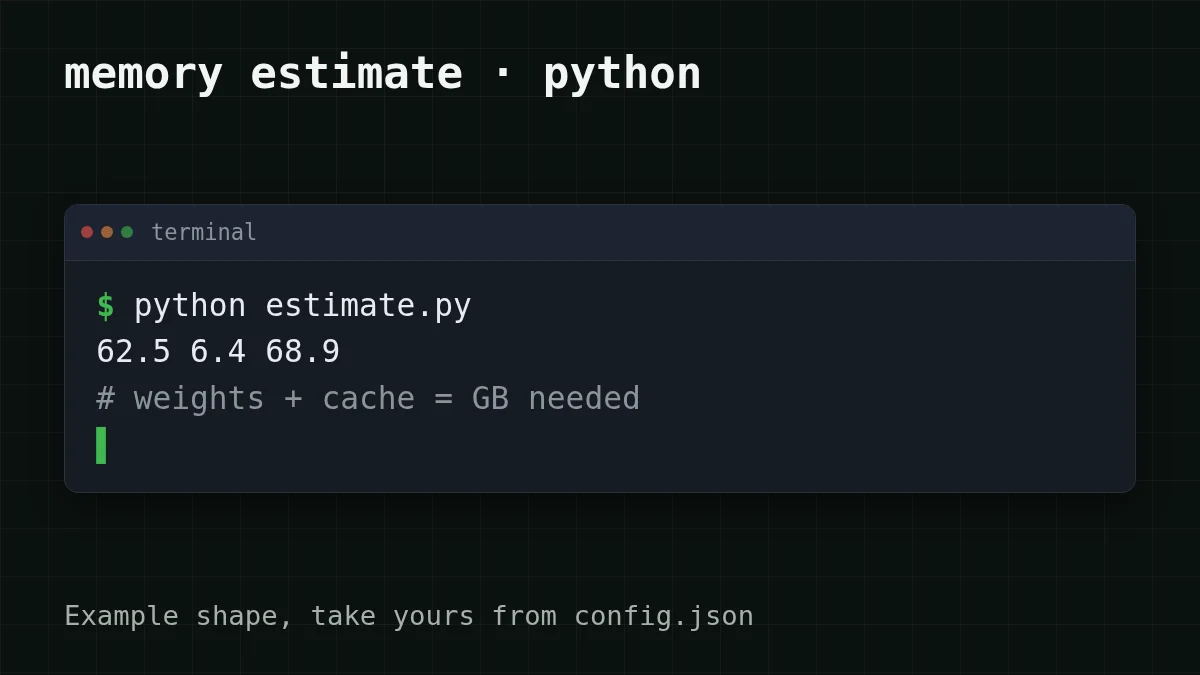
Maintenant, le test de réalité. Supposons que votre PC ait 32 Go de RAM à côté de la carte de 16 Go : 16 + 32 = 48 Go, toujours en dessous des 68,9 Go affichés par le script. Le déchargement devrait aussi recourir au disque, et vous feriez tourner un grand modèle principalement depuis le stockage plutôt que depuis la carte.
Quand une API est le choix le plus simple#
Toutes les tâches n'ont pas besoin d'un grand modèle sur votre bureau. Lequel vous décrit ?
Choisissez votre cas
Qu'est-ce qui se rapproche le plus de votre cas ?
Choisissez une option pour voir la réponse
Je veux voir un modèle tourner sur ma propre machine
Choisissez-en un petit : en 4 bits, un modèle 7B prend environ 7 × 0,5 = 3,5 Go pour les poids, donc il tient sur une carte de 16 Go avec de la place pour une longue conversation. Apprendre comment les modèles se comportent est la meilleure raison de faire tourner en local. Voir aussi local ou API pour DeepSeek.
Quelques milliers de requêtes par mois, et je veux un modèle puissant
Envoyez-les à une API. Vous évitez d'acheter ou de louer de la mémoire, il n'y a rien à installer, et la facture ne concerne que les tokens que vous utilisez réellement.
Des documents longs ou un agent qui garde un long historique
Le cache est la partie qui grandit, et sur votre propre matériel il rivalise avec les poids pour la même mémoire. Avec une API, la fenêtre de contexte est le problème de quelqu'un d'autre : DeepSeek-V4-Flash et GLM-5.3-Flash sur CheapTokens prennent 380K et 390K tokens.
À quoi cela ressemble en pratique. Supposons qu'un bot de support résume 3 000 tickets par mois, chacun d'environ 2 000 tokens en entrée et 400 tokens en sortie. Sur le mois, cela fait 2000 × 3000 = 6000000 tokens d'entrée et 400 × 3000 = 1200000 tokens de sortie. Sur DeepSeek-V4-Flash, l'entrée coûte $0.015 et la sortie $0.10 par million de tokens, donc le mois entier revient à $0.21. Le tableau ci-dessous montre la même charge sur chaque modèle, avec la colonne OpenRouter à côté pour comparer en total, entrée et sortie ensemble :
| Modèle | Entrée $/1M | Sortie $/1M | Par requête | 3 000 requêtes | OpenRouter, 3 000 requêtes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2 000 tokens d'entrée et 400 tokens de sortie par requête. Les prix par million de tokens sont actuels et évoluent avec nos tarifs ; la colonne OpenRouter indique des prix de référence pour la même charge de travail.
La requête elle-même est le même appel de style OpenAI que vous feriez à n'importe quel fournisseur. L'URL de base est https:/, et l'identifiant du modèle est le deepseek- complet :
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
La réponse contient un bloc usage avec les nombres de tokens d'entrée et de sortie, ce qui vous permet de vérifier l'estimation ci-dessus avec vos propres tickets après la première douzaine. DeepSeek-V4-Flash vous donne jusqu'à 32 768 tokens de sortie par réponse à un prix unique 24h/24, et GLM-5.3-Flash est l'option quotidienne plus légère avec jusqu'à 8 192. Les détails de configuration sont dans la documentation, la page du modèle est DeepSeek pas cher, et la liste complète des prix est sur la page de tarification.
La prochaine fois qu'un nom de modèle s'accompagne d'une taille, vous avez maintenant les trois étapes : multiplier, ajouter le cache, comparer avec la carte.


