¿Puede un modelo de 125B ejecutarse en una GPU de 16 GB? Las cuentas de la memoria
Cuánta memoria necesita un modelo abierto de 125B: pesos, cuantización y caché KV en unas pocas líneas de cálculo, y cuándo una API es la forma más sencilla de usarlo.
En esta página
Respuesta corta: no. Un modelo de 125B parámetros necesita unos 62,5 GB para sus pesos incluso tras la compresión a 4 bits, y una tarjeta gráfica de 16 GB alberga aproximadamente una cuarta parte de eso. Aun así puedes arrancarlo empujando el resto a la RAM del sistema o al disco, pero entonces la tarjeta ya no es lo que decide cómo van las cosas.
A continuación: cómo obtener ese número tú mismo en unas pocas líneas, qué te dice realmente «122B-A10B» en el nombre de un modelo, y cuándo enviar peticiones a una API es la forma más sencilla de usar un modelo grande.
Pesos: parámetros por bytes#
Imagina un modelo como un enorme montón de números, llamados pesos o parámetros. Para responderte, el ordenador necesita tenerlos todos en memoria rápida a la vez. Así que la primera estimación es una simple multiplicación: parámetros en miles de millones × bytes por peso = gigabytes. Un peso ocupa 2 bytes a 16 bits, 1 byte a 8 bits y 0,5 bytes a 4 bits. Eso es todo lo que hace la cuantización: menos bits por número.
Toma un modelo de esta clase, Qwen3.5-122B-A10B. Su página de Hugging Face (consultada el 30 de octubre de 2026) indica Apache-2.0 como licencia, publica los pesos en BF16 y F32, y lista el tamaño como 125B parámetros. Para 125B:
- A 16 bits: 125 × 2 = 250 GB
- A 8 bits: 125 × 1 = 125 GB
- A 4 bits: 125 × 0,5 = 62,5 GB
- A 2 bits: 125 × 0,25 = 31,25 GB
Incluso la línea de 2 bits es casi el doble de la tarjeta. Y estos son mínimos, no totales: dejan fuera la caché de contexto (siguientes secciones) y la sobrecarga del propio runtime, y los formatos cuantizados reales añaden un poco más.
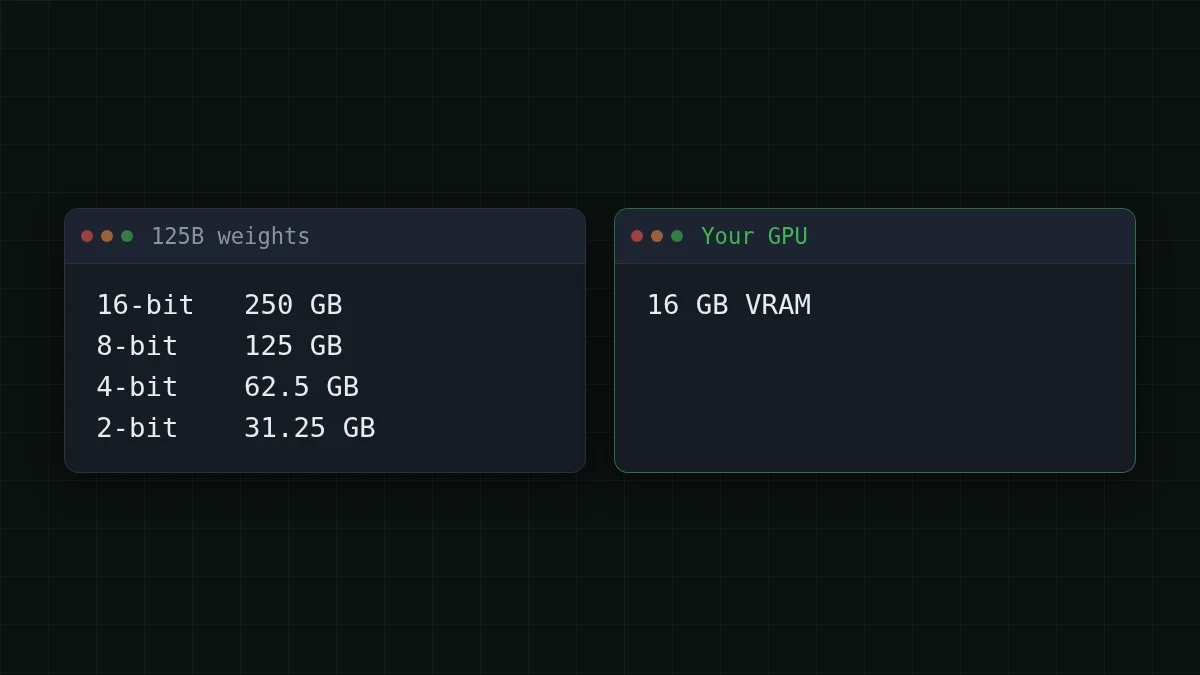
Dale la vuelta a la fórmula para ver qué puede albergar una tarjeta de 16 GB. A 4 bits eso son 16 / 0,5 = 32 mil millones de parámetros, y ese es el techo antes de que algo más necesite espacio. Prueba la suma tú mismo:
Adivina el número
¿Cuántos GB ocupan los pesos de un modelo de 32B a 4 bits?
Tu respuesta
0100
Mostrar respuesta
Respuesta: 16
32 × 0,5 = 16 GB. La tarjeta está llena antes de que el modelo haya leído una sola palabra de tu pregunta, así que 32B es el techo para una tarjeta de 16 GB y los tamaños cómodos quedan por debajo.
«122B-A10B»: qué número cuenta#
El nombre empaqueta dos números. Según la ficha del modelo, el modelo tiene 122B parámetros en total y 10B activos por cada token. Es un modelo de mezcla de expertos: dentro hay muchas subredes especialistas pequeñas, y por cada token un enrutador despierta solo a unas pocas.
Piensa en una biblioteca con 122 estanterías donde cualquier pregunta te envía a 10 de ellas. Tu esfuerzo de lectura es pequeño, pero toda la biblioteca tiene que seguir dentro del edificio, porque no puedes saber qué estanterías necesitará la siguiente palabra.
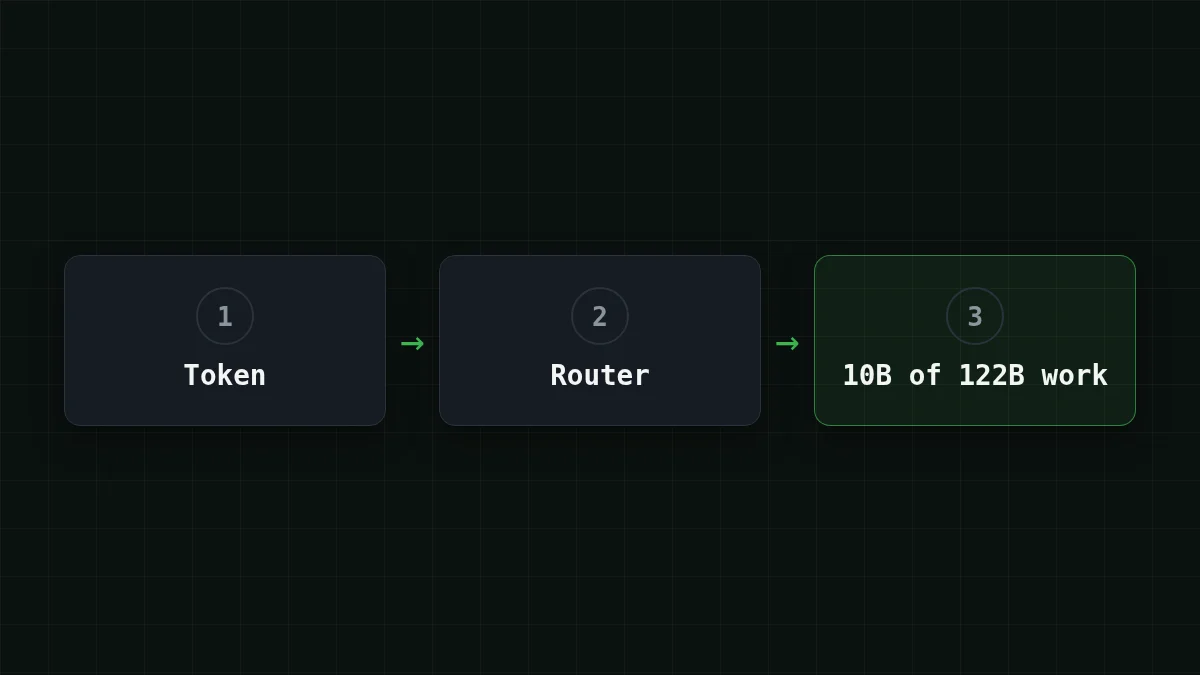
Así que: la memoria sigue al total, el cómputo sigue a los activos. Diez mil millones de parámetros activos hacen que un token sea barato de calcular, no barato de almacenar. La velocidad de una configuración que mantiene parte de los expertos en RAM o en disco depende de tu RAM, tu disco y tu software. No hay una cifra única honesta, así que desconfía de cualquier titular que dé una.
Verificación rápida
Un modelo se llama 122B-A10B. ¿Qué número determina aproximadamente cuánta memoria necesitan sus pesos?
Mostrar respuesta
Respuesta: Los 122B parámetros totales
Todos los expertos deben almacenarse, porque el enrutador puede elegir cualquiera de ellos para el siguiente token. Los 10B solo te dicen cuánto trabajo cuesta un token.
La segunda factura: la caché de contexto#
Los pesos son la parte fija. La otra parte crece mientras chateas. Para evitar releer toda la conversación por cada token nuevo, el modelo guarda notas sobre cada token que ya ha visto: la caché KV (claves y valores). Contexto más largo, caché más grande. Si quieres que el lado del contexto se explique desde cero, hay una guía aparte sobre la ventana de contexto.
Por token la caché ocupa: 2 × capas × cabeceras KV × tamaño de cabecera × bytes. Digamos que un modelo tiene 48 capas, 8 cabeceras KV, un tamaño de cabecera de 128 y una caché de 16 bits (una forma supuesta, no la de ninguna ficha de modelo):
- un token: 2 × 48 × 8 × 128 × 2 = 196608 bytes, unos 0,2 MB
- 32.768 tokens: 196608 × 32768 = 6442450944 bytes, unos 6,4 GB
- 131.072 tokens (128K): 196608 × 131072 = 25769803776 bytes, unos 25,8 GB
A 128K esa caché por sí sola es mayor que toda la tarjeta. Tus números reales están en el config.json del modelo (capas, cabeceras KV, tamaño de cabecera), y algunas arquitecturas mantienen la caché mucho más pequeña, así que trata esto como el método, no como un veredicto sobre un modelo concreto.
La ficha de Qwen3.5-122B-A10B muestra cómo es el extremo grande: sus ejemplos de servicio usan paralelismo tensorial en 8 GPUs con el contexto completo de 262.144 tokens. Si se agota la memoria, aconseja acortar el contexto manteniendo al menos 128K para preservar el razonamiento, y el flag de vLLM - omite el codificador de visión para liberar memoria para la caché.
Tu propia estimación en una docena de líneas#
Junta ambas partes:
def weights_gb(params_b, bits):
    return params_b * bits / 8

def cache_gb(layers, kv_heads, head_dim, tokens, nbytes=2):
    return 2 * layers * kv_heads * head_dim * nbytes * tokens / 1e9

w = weights_gb(125, 4)                # 4-bit quantization
c = cache_gb(48, 8, 128, 32768)       # example shape, take yours from config.json
print(round(w, 1), round(c, 1), round(w + c, 1))
# 62.5 6.4 68.9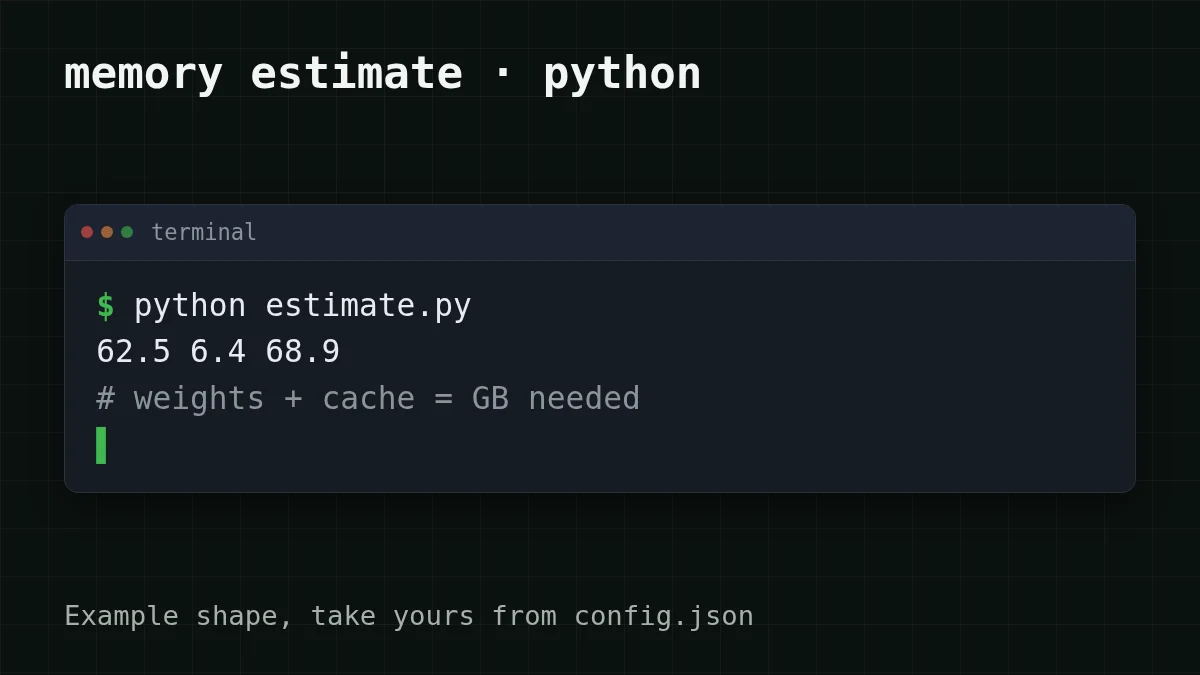
Ahora la comprobación de la realidad. Digamos que tu PC tiene 32 GB de RAM junto a la tarjeta de 16 GB: 16 + 32 = 48 GB, todavía por debajo de los 68,9 GB que imprimió el script. El offloading tendría que recurrir también al disco, y estarías ejecutando un modelo grande mayormente desde el almacenamiento en lugar de desde la tarjeta.
Cuándo una API es la opción más sencilla#
No todas las tareas necesitan un modelo grande en tu escritorio. ¿Cuál te describe?
Elige tu caso
¿Cuál se acerca más a tu caso?
Elige una opción para ver la respuesta
Quiero ver un modelo ejecutarse en mi propia máquina
Elige uno pequeño: a 4 bits, un modelo de 7B ocupa unos 7 × 0,5 = 3,5 GB para los pesos, así que cabe en una tarjeta de 16 GB con espacio para un chat largo. Aprender cómo se comportan los modelos es la mejor razón para ejecutar en local. Ver también local o API para DeepSeek.
Unos miles de peticiones al mes, y quiero un modelo potente
Envíalas a una API. Te ahorras comprar o alquilar memoria, no hay nada que instalar, y la factura es solo por los tokens que realmente usas.
Documentos largos o un agente que mantiene un historial largo
La caché es la parte que crece, y en tu propio hardware compite con los pesos por la misma memoria. Con una API la ventana de contexto es problema de otro: DeepSeek-V4-Flash y GLM-5.3-Flash en CheapTokens admiten 380K y 390K tokens.
Cómo se ve eso en la práctica. Digamos que un bot de soporte resume 3.000 tickets al mes, cada uno de unos 2.000 tokens de entrada y 400 tokens de salida. A lo largo del mes eso son 2000 × 3000 = 6000000 tokens de entrada y 400 × 3000 = 1200000 tokens de salida. En DeepSeek-V4-Flash, la entrada cuesta $0.015 y la salida $0.10 por 1M tokens, así que el mes entero sale por $0.21. La tabla de abajo muestra la misma carga en cada modelo, con la columna de OpenRouter al lado para que compares en total, entrada y salida juntas:
| Modelo | Entrada $/1M | Salida $/1M | Por solicitud | 3000 solicitudes | OpenRouter, 3000 solicitudes |
|---|---|---|---|---|---|
| GLM-5.3-Flash | $0.02 | $0.04 | $0.000056 | $0.168 | $0.301 |
| DeepSeek-V4-Flash | $0.015 | $0.10 | $0.00007 | $0.21 | $0.588 |
| MiniMax-M2.7 | $0.05 | $0.15 | $0.00016 | $0.48 | $5.76 |
2000 tokens de entrada y 400 tokens de salida por solicitud. Los precios por 1M de tokens son actuales y cambian junto con nuestras tarifas; la columna de OpenRouter muestra precios de referencia para la misma carga de trabajo.
La petición en sí es la misma llamada al estilo OpenAI que harías a cualquier proveedor. La URL base es https:/, y el id del modelo es el deepseek- completo:
curl https://api.cheaptokens.dev/v1/chat/completions \
  -H "Authorization: Bearer $CHEAPTOKENS_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "deepseek-ai/DeepSeek-V4-Flash-0731",
    "messages": [{"role": "user", "content": "Summarise this ticket in one sentence: ..."}],
    "max_tokens": 200
  }'
La respuesta lleva un bloque usage con los recuentos de tokens de entrada y salida, así que puedes contrastar la estimación anterior con tus propios tickets tras la primera docena. DeepSeek-V4-Flash te da hasta 32.768 tokens de salida por respuesta a un precio constante las 24 horas, y GLM-5.3-Flash es la opción diaria más ligera con hasta 8.192. Los detalles de configuración están en la documentación, la página del modelo es DeepSeek barato, y la lista completa de precios está en la página de precios.
La próxima vez que un nombre de modelo venga con un tamaño, ya tienes los tres pasos: multiplica, suma la caché, compara con la tarjeta.


